Дипломная (вкр): Страховое покрытие денежных остатков и запасов товаров в торговых точках ритейловой компании
модель страховой ритейловый денежный товар
Глава 3. Эконометрическое моделирование и прогнозирование страхового покрытия остатков денежных средств в торговых точках
.1 Исследование временного ряда остатков денежных средств
Данная глава посвящена анализу и моделированию временных рядов остатков денежных средств в торговых точках. Изучаемый набор данных содержит 466 торговых точек, торговые точки с большим числом пропусков были исключены, как и в случае с временными рядами запасов товаров. Временной ряд представляет собой 1401 дневное наблюдение в период с 1 января 2013 года по 1 ноября 2016 года.
Основным отличием данных временных рядов является наличие большого числа выбросов. Данные выбросы связаны с сезонным увеличением спроса и аномально высокими продажами в праздничные дни.
Поведение всех точек, независимо от среднего значения, похоже и имеет
приблизительно одинаковые характеристики, поэтому далее описание данных будет
происходить на примере торговой точки 1948 (рис. 18).
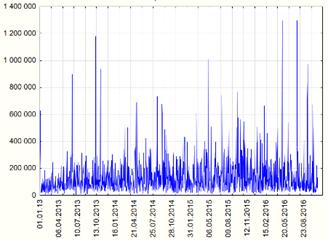
Рис. 18. Временной ряд торговой точки 1948, 2013-2016 гг.
На графике (рис. 18) временного ряда можно видеть множество пиков,
которые значительно изменяют среднее значение денежных средств в данной точке.
Можно видеть аномально высокие продажи в летние месяцы и предновогоднее время.
Чтобы проанализировать основные периоды аномальных значений остатков денежных
средств, был построен график, отражающий число точек с выбросами в каждый день
наблюдения.
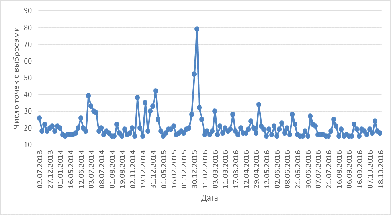
Рис. 19. Число торговых точек, в которых наблюдаются выбросы в конкретную
дату
На графике (рис. 19) изображены даты, в которые выбросы происходили более чем в 14 точках. В 2013 году выбросы наблюдались в конце июля и перед новогодними праздниками в феврале. В 2014 году среднее число выбросов во все дни выросло по сравнению с 2013 годом. В 2015 в течение всего года число выбросов оставалось на невысоком уровне, однако перед Новым годом, продажи резко возросли практически в 20% точек. Основным отличием 2016 года является наличие множества аномалий в весенние месяцы. Группы точек отличаются как по количеству выбросов, так и по дням, следовательно, данные признаки необходимо включить в характеристики кластеризации точек.
Гистограмма остатков денежных средств имеет форму, подобную плотности логнормального распределения с длинным правым хвостом, который появился в результате наличия выбросов с высоким значением денежных средств. Если среднее значение ряда равно 134 тысячам, то выбросы в конце хвоста превосходят миллион рублей.
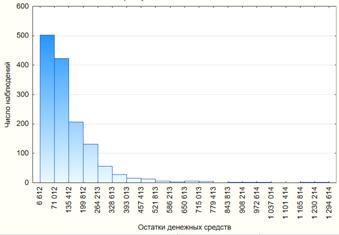
Рис. 20. Гистограмма остатков денежных средств в торговой точке 1948
Рассмотрим также распределение средних значений временных рядов на
гистограмме (рис. 21).
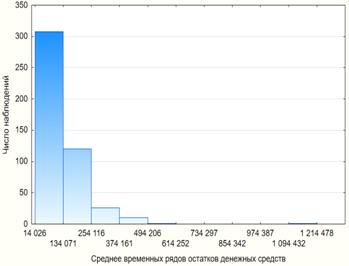
Рис. 21. Гистограмма средних значений временных рядов во всех торговых
точках
Средние временных рядов, как и множество денежных величин, распределены предположительно логнормально. Около 80% средних всех точек лежит в промежутке от 24 до 246 тысяч рублей. Однако есть и точки со средним значением больше миллиона рублей. Так как алгоритм кластеризации k-средних очень чувствителен к выбросам, денежные величины были прологарифмированы.
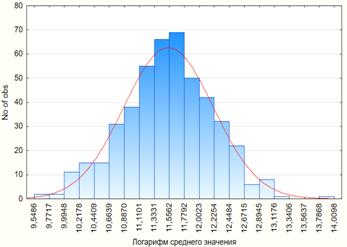
Рис. 22. Гистограмма логарифма среднего значения денежных средств в
торговых точках
Распределение логарифмированных значений близко к нормальному закону распределения. Тест Жарка-Бера подтверждает гипотезу о нормальном законе распределения (J-B = 1,23, prob = 0,54).
Таким образом, для кластеризации остатков денежных средств должны быть использованы характеристики логарифмированных величин, а также величины, характеризующие число и даты выбросов.
.2 Объединение торговых точек со схожими характеристиками остатков денежных средств в группы
Как и в случае с запасами товаров в точках, кластеризация на основе данных о денежных средствах производится с помощью метода k-средних. На первом этапе вся совокупность точек будет разбита на несколько больших однородных классов с учетом количества выбросов. Далее каждый из классов будет разбит на подклассы в зависимости от того, в какие дни выбросы в точках происходили.
Первоначальное разбиение на классы было произведено на основе следующих признаков:
. Число выбросов в точке
2. Среднее значение остатка денежных средств
. Стандартное отклонение
. Максимальный размах между соседними наблюдениями
. Среднее первой разности
. Стандартное отклонение первой разности
Как упоминалось ранее, для классификации точек по остаткам денежных средств необходимо учитывать выбросы. Так как в дальнейшем временные ряды точек одного кластера будут усреднены, очень важно, чтобы в группе находились точки с одинаковым поведением и аномальными наблюдениями в одни и те же дни. Для кластерного анализа были взяты данные по выбросам в точке в следующие даты, где общее число аномальных наблюдений больше 30:
. 2,3,4 июля; 17,26,30,31 декабря 2014 года
2. 1 января; 30,31 декабря 2015 года
. 1 января; 3 марта; 4 апреля 2016 года
Данные точки невозможно кластеризовать графически, так как число
характеристик для кластеризации велико. Поэтому для разбиения на группы
применялся кластерный анализ, метод k-средних. Для определения числа кластеров,
прежде всего, необходимо провести графический анализ двумерной гистограммы.
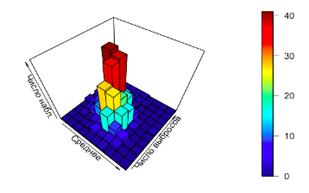
Рис. 23. Двумерная гистограмма разброса точек для среднего и числа выбросов остатков денежных средств
Также выделяются области с желтыми и зелеными частотами. Однако, данный
метод не позволяет точно определить количество кластеров, так как отражает
разбиение только по двум переменным. Поэтому был проведен иерархический
кластерный анализ и построена дендрограмма с использованием метода Варда.
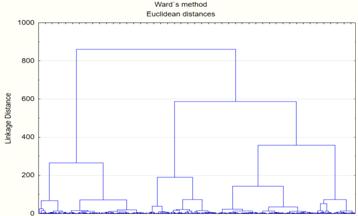
Рис. 24. Дендрограмма классификации торговых точек по остаткам денежных
средств и их характеристикам
На дендрограмме (рис. 24) отчетливо выделяются четыре кластера
практически равного размера для расстояния, равного 300. Таким образом, в
кластеризации методом k-средних задано 4 кластера.
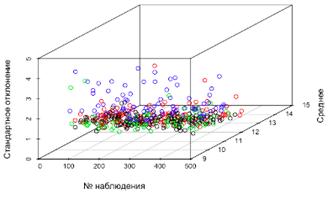
Рис. 25. Точечная диаграмма разбиения точек с остатками денежных средств на четыре кластера
Так как для классификации точек в однородные группы использовалось
множество факторов, на точечной диаграмме (рис. 25) трудно описать различия
кластеров и определить принадлежность точек. Можно сказать только, что синий
кластер имеет наибольшие значения стандартного отклонения, а зеленый кластер
наименьшие средние (рис. 26). Для понимания различий между кластерами
необходимо рассмотреть значения всех характеристик в каждой группе.
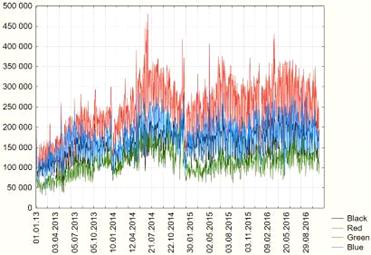
Рис. 26. Остатки денежных средств с выбросами в торговых точках в четырех
кластерах
Можно видеть (табл. 10), что кластеры имеют примерно одинаковые средние значения, однако отличаются по количеству выбросов, максимальному размаху между соседними наблюдениями, среднему первой разности и стандартному отклонению первой разности. Синий кластер имеет значительно больший максимальный размах, чем другие. Наибольшее количество выбросов содержится в зеленом кластере.
Также необходимо определить, в какие дни в каждом кластере происходят выбросы. В черном и красном кластере превалирует только одна дата. В данных группах выбросы происходят в конце декабря 2014 года. Зеленый и синий кластер включают большее число дат с аномалиями.
Таблица 10
Характеристики кластеров по остаткам денежных средств в торговых точках
|
Кластер |
Логарифм товарных запасов |
Первая разность логарифма товарных запасов |
Число наблюдений |
||||
|
|
Среднее |
Максимальный размах между соседними наблюдениями |
Стандартное отклонение |
Среднее |
Размах временного ряда |
Стандартное отклонение |
|
|
Черный |
23,73 |
11,49 |
0,83 |
4 |
0,0001 |
0,86 |
183 |
|
Красный |
15,26 |
11,96 |
0,85 |
4,26 |
0,0002 |
0,77 |
117 |
|
Зеленый |
31,71 |
11,06 |
1,03 |
5,41 |
0,0001 |
0,96 |
79 |
|
Синий |
21,47 |
11,48 |
1,64 |
11,25 |
-0,0005 |
0,91 |
87 |
Таблица 11
Даты с аномальными наблюдениями, характерные для каждого кластера
|
Черный |
Красный |
Зеленый |
Синий |
|
30.12.14 |
17.12.14 |
04.07.14 |
03.03.16 |
|
|
|
03.07.14 |
01.01.16 |
|
|
|
31.12.14 |
30.04.16 |
|
|
|
02.07.14 |
26.12.14 |
|
|
|
01.01.15 |
30.12.15 |
|
|
|
|
31.12.15 |
Для проверки значимости различий между кластерами был проведен
дисперсионный анализ. Дисперсия между кластерами объясняет 72% общей дисперсии.
Данное разделение на кластеры значимо, F-статистика = 392 (probability =
0,001).
Таблица 12
Дисперсионный анализ разбиения денежных средств на четыре кластера
|
|
Черный |
Красный |
Зеленый |
Синий |
|
Size |
183 |
117 |
79 |
87 |
|
SS Within |
1276 |
2040 |
1764 |
1491 |
|
SS Between |
16742 |
|||
|
SS Total |
23313 |
|||
Таким образом, было получено 4 кластера. Разбиение учитывает
характеристики временного ряда, первой разности временного ряда и даты, в
которые в точках происходят пики продаж. Дисперсионный анализ доказал
значимость разделения.
3.3 Моделирование и прогнозирование временных рядов остатков денежных средств в группах торговых точек
Как говорилось в предыдущих разделах, отличительной особенностью данных временных рядов является наличие аномальных наблюдений в летние месяцы и праздничные дни. Существует два способа моделирования временных рядов с подобными характеристиками:
. Исключение выбросов из временного ряда и прогнозирование с помощью более простых временных моделей. Данный метод в дальнейшем предполагает отдельное страхование аномальных дней. Это может быть выгодно с точки зрения экономии страховых премий.
2. Прогнозирование временных рядов с выбросами с использованием сложных, смешанных моделей. Это позволяет страховать подобные риски без заключения дополнительных соглашений на страхование выбросов.
Оба метода интересны ритейловой компании, так как каждый из них обладает
своими преимуществами и может быть рассмотрен в процессе заключения договора
страхования. Интересным является вариант страхования точек кластеров с малым
значением выбросов по первой схеме, а с большим числом - по второй.
3.3.1 Прогнозирование временных рядов остатков денежных средств без выбросов с помощью моделей ARFIMA
Для построения моделей данной главы из каждого кластера были исключены
дни с большим количеством точек, в которых в это время происходили выбросы.
Полученные временные ряды представлены на графике (рис. 27).
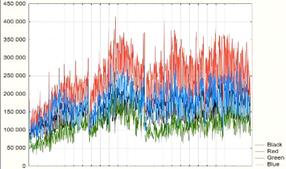
Рис. 27. Временные ряды остатков денежных средств четырех кластеров
Можно видеть, что даже после удаления типичных дней с аномальными
продажами, ряды имеют множество пиков. Видно, что ряды имеют схожие
характеристики: различная волатильность, восходящие и нисходящие тренды.
Поэтому предварительный анализ перед построением модели будет проведен на
примере синего кластера.
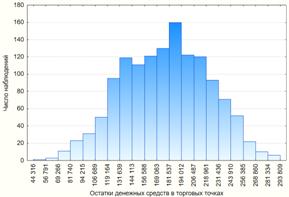
Рис. 28. Гистограмма средних остатков денежных средств в торговых точках синего кластера
Распределение данного кластера, хоть и напоминает по форме кривую Гаусса,
но сильно отличается от нормального распределения. Также гистограмма показывает
наличие тяжелых хвостов: частоты имеют высокое значение на большинстве
интервалов. Подобное поведение данных указывает на возможность применения
ARCH/GARCH и ARFIMA моделей. Для проверки этого предположения необходимо также
рассмотреть коррелограмму.
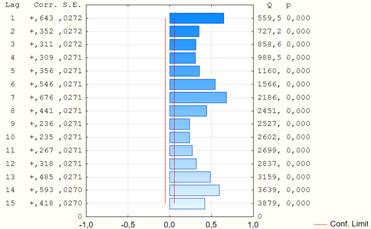
Рис. 29. Коррелограмма временного ряда синего кластера
На коррелограмме видно, что все автокорреляции имеют высокие положительные значения и значимы не менее чем на 15 лагах. Кроме того, корреляции не убывают с гиперболической скоростью, а имеют синусоидальные колебания. На лагах, кратных семи, корреляции резко возрастают. Данные признаки говорят о наличии длинной памяти во временном ряду. Процессы с длинной памятью прогнозируются с помощью модели ARFIMA.
На периодограмме также наблюдается недельная сезонность. Наибольшее
значение логарифм периодограммы принимает на частоте 0,02  .
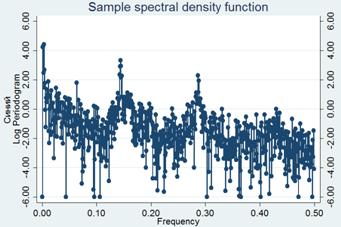
Рис. 30. Периодограмма временного ряда синего кластера
Как уже было отмечено в 1 главе, процесс ARFIMA достаточно трудно отличить от обычных I(1) c помощью тестов малой мощности, Дики-Фуллера и Филипса-Перрона, а тест KPSS состоятелен при стационарных процессах с длинной памятью, но необходимо большое количество наблюдений. Поэтому наиболее надежным является использование R/S анализа. Проведем R/S анализ и найдем экспоненту Херста Н - меру, используемую для анализа процессов с длинной памятью:
. H>0.5 процесс персистентен (монотонно следующий вдоль детерминированного тренда) и имеет положительную автокорреляцию- сохраняет имеющуюся тенденцию.
2. H=0.5 - тенденции не выражено.
. H<0.5 процесс характеризуется антиперсистентностью и отрицательной автокорреляцией-любая тенденция стремится смениться противоположной.