Материал: Теория вероятностей и математическая статистика. Учебное пособие. Горбунов В.В., Соколова О.А
стическая дисперсия – «выборочной дисперсией».
Происхождение этих терминов следующее. В статистике часто приходится исследовать распределение того или иного признака для весьма большой совокупности индивидуумов, образующих статистический коллектив (длина или вес тела какого-либо из группы животных; стандартность или размер детали из их большого числа). Данный признак является случайной величиной, значение которого от индивидуума к индивидууму или от детали к детали меняется. Однако чтобы составить представление о распределении этой случайной величины или о ее важнейших характеристиках, нет необходимости исследовать каждый индивидуум, можно исследовать некоторую выборку достаточно большого объема для того, чтобы в ней были выявлены существенные черты изучаемого распределения. Та обширная совокупность, из которой производится выборка, называется генеральной совокупностью. При этом предполагается, что число членов N в генеральной совокупности весьма велико, а число членов n в выборке ограничено.
При составлении выборки можно поступать двумя способами: после того, как объект отобран и над ним произведено наблюдение, он может быть возвращен либо не возвращен в генеральную совокупность. В связи с этим выборки подразде-
ляют на повторные и бесповторные.
Повторной называют выборку, при которой отобранный объект (перед отбором следующего) возвращается в генеральную совокупность.
Бесповторной называют выборку, при которой отобранный объект в генеральную совокупность не возвращается.
На практике обычно пользуются бесповторным случайным отбором.
Для того чтобы выборка правильно отражала все черты генеральной совокупности, она должна быть репрезентативной (представительной). Выборка будет репрезентативной,
66
если каждый ее объект отобран случайно из генеральной совокупности, а все объекты имеют одинаковую вероятность попасть в выборку.
Существуют следующие способы отбора.
1.Отбор, не требующий расчленения генеральной совокупности на части. Сюда относятся: простой случайный беспо-
вторный отбор; простой случайный повторный отбор. Про-
стым случайным называют такой отбор, при котором объекты извлекают по одному из всей генеральной совокупности.
2.Отбор, при котором генеральная совокупность разби-
вается на части: типический отбор; механический отбор; се-
рийный отбор. Типическим называют отбор, при котором объекты отбираются не из всей генеральной совокупности, а из каждой ее «типической» части. Типическим отбором пользуются тогда, когда обследуемый признак заметно колеблется в различных типических частях генеральной совокупности. Механическим называют отбор, при котором генеральную совокупность «механически» делят на несколько групп, столько, сколько объектов должно войти в выборку, а из каждой группы отбирают один объект. Серийным называют отбор, при котором объекты отбирают из генеральной совокупности не по одному, а «сериями», которые подвергают сплошному обследованию.
На практике часто применяют комбинированный отбор, при котором сочетаются указанные способы.
При достаточно большом числе членов генеральной совокупности N оказывается, что свойства выборочных (статистических) распределений и характеристик практически не зависят от N, отсюда вытекает математическая идеализация, состоящая в том, что генеральная совокупность, из которой осуществляется выбор, имеет бесконечный объем. При этом отличают точные характеристики (закон распределения, математическое ожидание, дисперсию и т.д.), относящиеся к генеральной совокупности, от аналогичных им «выборочных» характе-
67
ристик. Выборочные характеристики отличаются от соответствующих характеристик генеральной совокупности за счет ограниченности объема выборки n. При неограниченном увеличении n все выборочные характеристики приближаются к соответствующим характеристикам генеральной совокупности.
4. Выравнивание статистических рядов
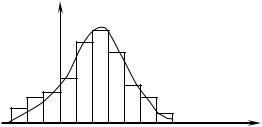
При обработке статистического материала часто приходится решать вопрос о том, как подобрать для статистического ряда плавную теоретическую кривую распределения, выражающую лишь существенные черты статистического материала, а не случайности, связанные с недостаточным объемом экспериментальных данных (рис. 4). Такая задача называется задачей выравнивания (сглаживания) статистических рядов.
f(х)
х
0
Рис. 4
Как правило, принципиальный вид теоретической кривой выбирается заранее, в соответствии с задачей, а в некоторых случаях с внешним видом статистического распределения. Аналитическое выражение выбранной кривой распределения зависит от некоторых параметров; задача выравнивания статистического ряда переходит в задачу рационального выбора
68

тех значений параметров, при которых соответствие между статистическим и теоретическим распределениями оказывается наилучшим. При сглаживании эмпирических зависимостей или при подборе параметров распределения применяют метод наименьших квадратов.
5. Критерии согласия
Рассмотрим вопрос, связанный с согласованием теоретического и статистического распределений, а именно вопрос проверки гипотез.
Пусть статистическое распределение выровнено с помощью некоторой теоретической кривой f(x) (рис. 4). Между теоретическим и статистическим распределениями неизбежны некоторые расхождения, как бы хорошо ни была подобрана кривая. Возникает вопрос: объясняются ли эти расхождения только лишь случайными обстоятельствами, связанными с ограниченным числом наблюдений, или они существенны и связаны с тем, что данная кривая плохо выравнивает данное статистическое распределение. Для ответа на этот вопрос служат так называемые «критерии согласия».
Рассмотрим один из наиболее часто применяемых критериев согласия – так называемый «критерий 2 » Пирсона.
Пусть произведено n независимых опытов, в каждом из которых величина Х приняла определенное значение. Результаты опытов сведены в k разрядов в виде статистического ряда:
Ii |
x1;x2 |
|
x2;x3 |
|
. . . |
xi;xi+1 |
. . . |
xk;xk+1 |
|
|
|
|
|
|
|
|
|
pi* |
p1* |
|
p2* |
|
. . . |
pi* |
. . . |
pk* |
|
|
|
|
|
|
|
|
|
Требуется |
проверить, |
согласуются ли |
эксперименталь- |
|||||
69
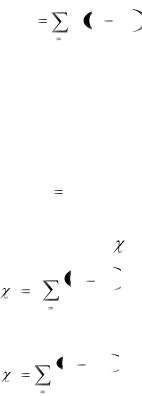
ные с гипотезой о том, что случайная величина Х имеет данный закон распределения (заданный функцией распределения F(x) или плотностью f(x)), который назовем «теоретическим».
Зная теоретический закон распределения, можно найти теоретические вероятности попадания случайной величины в каждый из разрядов: p1, p2, . . ., pk.
Проверяя согласованность теоретического и статистического распределений, исходят из расхождений U между теоретическими вероятностями pi и наблюдаемыми частотами pi*(за счет чисто случайных причин). В качестве меры расхождения между теоретическим и статистическим распределениями выбирается сумма квадратов отклонений (pi*- pi), взятая с некоторыми «весами» сi:
k |
|
|
p 2 . |
|
U |
c |
p* |
(9) |
|
|
i |
i |
i |
|
i |
1 |
|
|
|
Коэффициенты сi вводят потому, что в общем случае отклонения, относящиеся к различным разрядам, нельзя считать равноправными по значимости. Одно и то же по абсолютной величине отклонение (pi*- pi) может быть мало значительным, если сама вероятность pi велика, и очень заметным, если она мала. Поэтому в качестве сi Пирсон предложил отношение
c |
n |
, |
|
||
i |
pi |
|
|
||
тогда мера расхождения обозначается 2 :
2 |
k |
p* |
p |
2 |
|
n |
i |
i |
. |
||
|
|
pi |
|
||
|
i 1 |
|
|
|
|
Для удобства вычислений применяется формула
k |
mi |
npi |
2 |
|
2 |
|
. |
||
i 1 |
|
npi |
|
|
|
|
|
70