Материал: 2411
Анализ существующих полнотекстовых электронных библиотек (ПЭБ) показывает необходимость создания таких систем, которые позволяли бы работать эффективно многим индексаторам над созданием цифровых коллекций документов, обеспечить поиск необходимого контекста и использовать интеллектуальный анализ текста. Есть определенное мнение, что индексирование документов должно осуществляться в автоматическом режиме. Но бывают случаи, когда даже самая совершенная программа не сможет отметить особенность документов. Поэтому подобные системы должны предусматривать возможность ручного индексирования отдельных частей документа и индексирования документа несколькими индексаторами (плюрализм мнений индексаторов). Заметим, что при этом крайне важно, чтобы исходные документы остались в неизменном виде. Поскольку в коллекциях часто встречаются разные издания одной книги, важно научиться работать с версиями документов (не требовать повторного индексирования новых изданий). Важной частью подобных систем является и возможность поиска аналогий.
Отметим одну особенность, присущую современным ЭБ, это наличие в коллекциях документов в форматах PDF и DjVu. Кроме того, ЭБ могут содержать большое число аудио- и видеодокументов. Возникает потребность индексирования и поиска в таких документах.
Далее опишем информационно-поисковую систему (ИПС) для ПЭБ с хранением документов в текстовом виде. Дальнейшее расширение на другие форматы будет возможно подключением дополнительных модулей.
Информационно-поисковые языки
Процесс создания информационно-поисковой системы (ИПС) во многом определяется разработкой специализированного информационнопоискового языка (ИПЯ). Основная роль, которую играют ИПЯ, состоит в записи на нем поисковых образов (ПО) документов и поисковых заданий (ПЗ). Специфическая роль, которую должен играть такой язык, будет меняться в зависимости от библиотеки, фонда и читателей. Выбор или разработка ИПЯ является, вероятно, наиболее трудной ступенью в разработке информационно-поисковой системы.
Требования к информационно-поисковым языкам
Некоторыми характерными особенностями языка, служащего для индексирования, являются следующие:
с одной стороны, ИПЯ должен однозначно восприниматься компьютером, с другой стороны, желательно, что бы он был понятен и человеку для ручного поиска;
поисковые образы (ПО), записанные на ИПЯ, должны в достаточной мере описывать соответствующие документы. При этом полнота описания определяется не только степенью детализации, но и концентрацией на
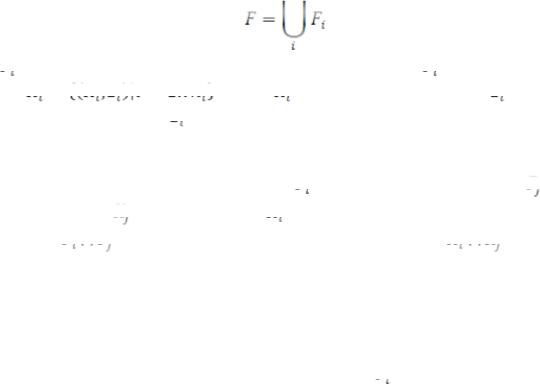
“нужном” предмете. Сам же “нужный” предмет в поисковом образе будет меняться в зависимости от групп потребителей;
ПО объединяются в массивы, называемые индексом. Структура индексов должна быть разработана таким образом, чтобы обеспечить быстрый поиск и высокую релевантность результата;
с течением времени языки вообще, и ИПЯ в частности, изменяются. Правильно построенные ИПЯ должны обладать возможностями модификации по мере того, как изменяется язык документов или потребителей. Например, с появлением нового формата хранения информации или новой группы потребителей ИПЯ не должен оказываться непригодным или не масштабируемым.
Большое значение имеет надежность разрабатываемой информационной системы, следовательно, необходимо предусмотреть соответствующие действия.
Структура поисковых образов
Поиск по большим массивам данных во многом зависит от организации индексных файлов, содержащих в том или ином объеме сведения о массивах.
Язык описания документов
Индексируемый документ F представляется как покрытие:
где 
 фрагменты документа. Каждому фрагменту

 сопоставляется набор


 , где

 – ключевое слово и

 – его значимость. Значения

 принадлежат некоторому упорядоченному множеству {1,2…5}.
Далее будем предполагать, что выполняются следующие соотношения: если некоторый фрагмент 
 содержится во фрагменте

 , то
набор ключевых 
 содержится в
 . Более того, будем считать, что фрагменту


 соответствует набор ключевых слов


 . Таким
образом, мы определили правило наследования ключевых слов.
Структура индексных файлов
В качестве индексных файлов используются инвертированные списки. Индексный файл содержит ключевые слова, отсортированные для ускорения поиска в алфавитном порядке. За каждым ключевым словом следуют ссылки на файлы, с указанием фрагмента 

 , где данное ключевое слово встречается и указывается его смысловая значимость. Таким образом, фрагмент индексного файла выглядит следующим образом:
*.log файл
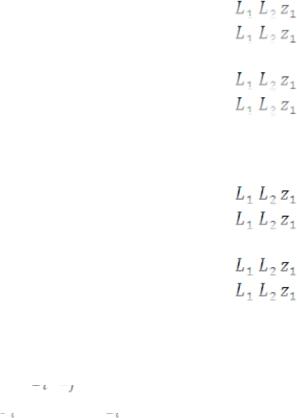
Для каждого документа F создаётся вспомогательный файл F.log, который играет роль дневника работы (это необходимо для обеспечения надежности, также дает возможность продолжить прерванное индексирование с того момента, на котором оно было прервано). Каждый
индексатор работает только с файлами типа .log. Далее файлы типа .log
используются для пополнения основного индексного файла. Структура его такова:
…
SESSION OPEN= Дата_индексации_n ADD
Ключевое_слово_m |
; |
Ключевое_слово_m+1 |
; |
DEL |
|
Ключевое_слово_m |
; |
Ключевое_слово_m+1 |
; |
SESSION CLOSED
SESSION OPEN= Дата_индексации_n+1
ADD
Ключевое_слово_m |
; |
Ключевое_слово_m+1 |
; |
DEL |
|
Ключевое_слово_m |
; |
Ключевое_слово_m+1 |
; |
SESSION CLOSED |
|
… |
|
где 
 ,

 – номера абзацев/страниц начала и конца фрагмента документа


 , значения

 – значимость.
Каждая сессия индексации документа заключена между специальных фраз SESSION OPEN и SESSION CLOSED. Это обеспечивает возможность в любой момент вернуться к одному из прежних состояний, а также отменить результаты последних сессий индексации вплоть до самой первой сессии.
Между специальными словами ADD и DEL стоят ключевые слова, добавленные в текущей сессии. Между DEL и SESSION CLOSED – удалённые.
Файл ключевых слов (основной индексный файл)
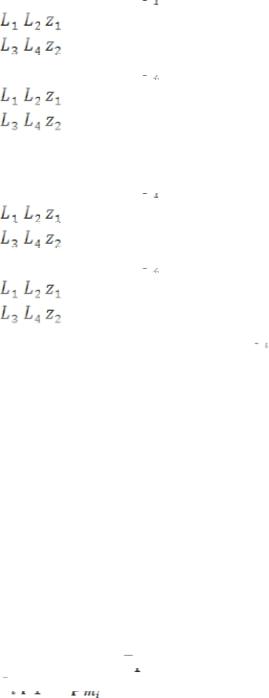
Файл ключевых слов включает в себя ключевые слова, собранные по всем документам, инвертированный список в этом файле может быть построен по информации из *.log файлов для книг либо в ходе ручной индексации книги, без последующей записи в файлы *.log. Данный файл описывает документ согласно языку, представленному выше. Формат его фрагмента выглядит следующим образом:
....
Ключевое_слово_n ссылка_на_файл_


ссылка_на_файл_


...
Ключевое_слово_n+1 ссылка_на_файл_


ссылка_на_файл_


Отметим, что ссылка_на_файл_

 – это номер документа в системе, по которому идентифицируется книга через файл списка книг.
Глобальный индексный файл
Стоп-словарь – список слов, содержащий часто встречающиеся слова, которые не несут большой смысловой нагрузки.
Данный файл включает в себя все слова всех документов, исключая слова, входящие в стоп-словарь системы.
Глобальный индексный файл имеет несколько отличную от файла ключевых слов структуру. Создается он в процессе автоматической индексации, пользователь не принимает участия в его создании. Данный файл включает в себя все слова всех документов, исключая слова, входящие в стоп-словарь системы.
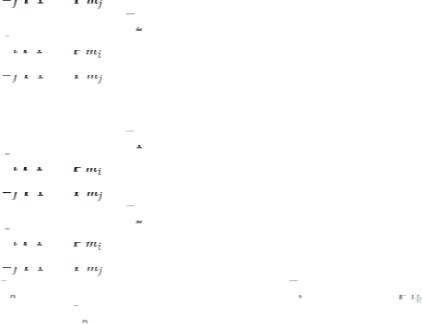
Формат его фрагмента выглядит следующим образом:
....
Слово_n номер_файла_


 …



 …


номер_файла_


 …


 …


...
Слово_n+1 номер_файла_


 …


 …


номер_файла_


 …


 …


где 
 – страницы/абзацы документа


 , значения


 – позиции слова на странице

 .
Библиографический список
1.Greenstone / Википедия – свободная общедоступная многоязычная универсальная энциклопедия // URL: http://ru.wikipedia.org/wiki/Greenstone
2.Кудим К.А. Сравнение систем электронных библиотек EPrints 3.0 и DSpace
1.4.1/ К.А. Кудим, Г.Ю. Проскудина, В.А. Резниченко. – С. 2 9.
3.Sumatra: Интернет. Sumatra PDF viewer// http://blog.kowalczyk.info/software/ sumatrapdf/ index.html
4.Hunspell / Википедия – свободная общедоступная многоязычная универсальная энциклопедия // URL: http://ru.wikipedia.org/wiki/Hunspell
УДК 004.9
ЭЛЕКТРОННЫЕ ЗАЧЕТНЫЕ КНИЖКИ И ЖУРНАЛ ПРЕПОДАВАТЕЛЯ В ИНФОРМАЦИОННО – ОБРАЗОВАТЕЛЬНОЙ СРЕДЕ ВУЗА
Б.С.Добронец,д-рфиз.-мат.наук, проф.,П.С. Бабкин, аспирант Сибирский федеральный университет ( г. Красноярск)
В настоящее время всё большую роль приобретают информационносоциальные технологии в образовании. Такие системы обеспечивают