Материал: 5316
экспоненциальная средняя 2-го порядка: |
|
||
S 2 |
(y)=A - |
2(1 ) |
B , |
|
|||
0 |
|
|
|
где – параметр сглаживания.
В зависимости от величины параметра, прогнозные оценки по-разному учи-
тывают влияние исходного ряда наблюдений: чем больше , тем больше вклад
последних наблюдений в формирование тренда, а влияние начальных условий
убывает быстро. При малом прогнозные оценки учитывают все наблюдения,
при этом уменьшение влияния более ранней информации происходит медленно.
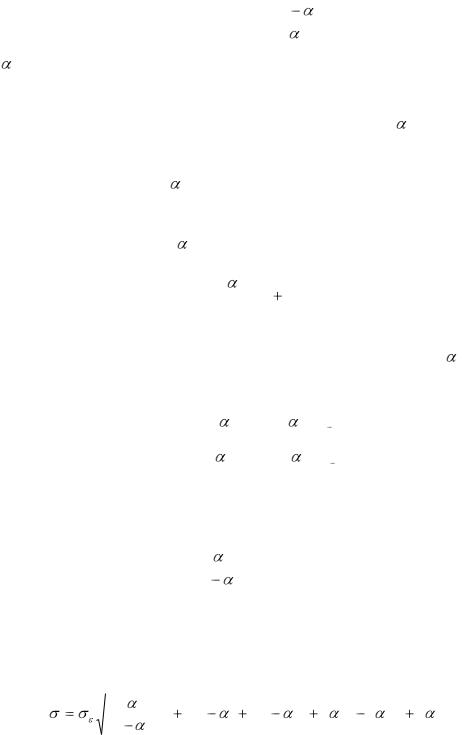
Для приближённой оценки |
|
|
используют соотношение Брауна: |
|
|||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
2 |
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
= |
|
|
|
|
, |
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
т 1 |
|
|
|
|
|
||||||||
где m – число наблюдений (точек) в ретроспективном динамическом ряду. |
|||||||||||||||||||||
Зная начальные условия S 1 |
(y), S |
2 (y) и значение параметра , |
вычисляют |
||||||||||||||||||
|
|
|
0 |
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
экспоненциальные средние 1-го и 2-го порядка: |
|
|
|
|
|
||||||||||||||||
|
|
S |
1 |
(y)= |
|
y + (1- |
) S 1 |
1 |
(y); |
|
|||||||||||
|
|
|
t |
|
|
|
|
|
t |
|
|
|
|
|
|
t |
|
|
|
||
|
S 2 |
(y)= |
S1 |
+ (1- |
) S 2 |
1 |
(y). |
|
|||||||||||||
|
|
t |
|
|
|
|
|
|
t |
|
|
|
|
|
|
t |
|
|
|
||
Оценки коэффициентов линейного тренда: |
|
|
|
|
|
|
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
А = 2 S 1 |
(y) - S 2 (y); |
|
|
|
||||||||||||
|
|
|
|
|
|
|
|
|
t |
|
|
|
|
|
t |
|
|
|
|
|
|
|
|
|
|
|
|
|
[ S1 (y)- S 2 |
|
|
|
|||||||||||
|
|
|
В = |
|
|
(y)]. |
|
||||||||||||||
|
|
|
|
|
|
||||||||||||||||
|
|
|
|
1 |
|
|
|
|
|
t |
t |
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
Прогноз на время t равен: |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
yt= А + В *t. |
|
|
|
|
|
|||||||||
Ошибка прогноза: |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||
|
|
[1 |
|
4(1 |
) |
|
5(1 |
|
|
)2 |
2 |
|
(4 3 ) p 2 2 p2 ] |
, |
|||||||
(2 )3 |
|
|
|
|
|
||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
где p – период прогноза.
Рассмотрим пример. Пусть задан временной ряд объёма расходов на капи-
тальный ремонт в жилищно-коммунальном хозяйстве города за 5 лет в млн руб.
в сопоставимых ценах (таблица 3.3).
36
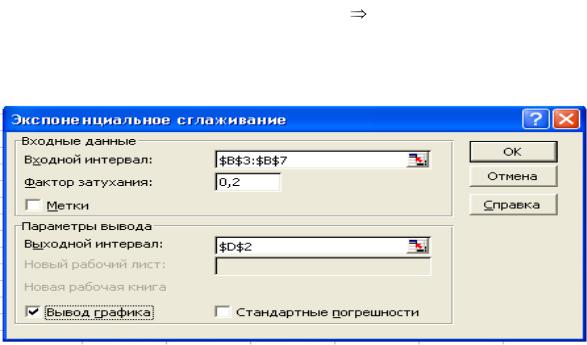
Таблица 3.3 – Динамика расходов на капитальный ремонт в жилищнокоммунальном хозяйстве города, млн рублей
t |
1 |
2 |
3 |
4 |
5 |
показатель |
40 |
37 |
46 |
32 |
49 |
Используя метод экспоненциального сглаживания, построить прогноз ожидаемого объёма финансовых расходов на капитальный ремонт в ЖКХ города.
Согласно имеющейся динамике показателя расходов, можно предположить, что тренд описывается линейной функцией.
Рассмотрим решение задачи средствами Excel.
1.Заносим статистические данные на лист Excel.
2.В меню ДАННЫЕ выберите команду АНАЛИЗ ДАННЫХ.
Если раздел АНАЛИЗ ДАННЫХ отсутствует, то его необходимо установить. Для установки раздела АНАЛИЗ ДАННЫХ в пакете Excel необходимо выполнить следующее:
а) в меню ФАЙЛ выберите команду ПАРАМЕТРЫ, далее НАДСТРОЙКИ; б) в появившемся списке установите флажок ПАКЕТ АНАЛИЗА.
3. В открывшемся диалоговом окне АНАЛИЗ ДАННЫХ выберите инструмент ЭКСПОНЕНЦИАЛЬНОЕ СГЛАЖИВАНИЕ ОК.
4. В диалоговом окне ЭКСПОНЕНЦИАЛЬНОЕ СГЛАЖИВАНИЕ необходимо определить следующие параметры:
–в поле Входной интервал укажем диапазон с исходными данными (В3:В7);
–укажем Фактор затухания, равный 0,2;
–установим курсор в поле Выходной интервал, мышкой укажем любую ячейку, например D2;
37
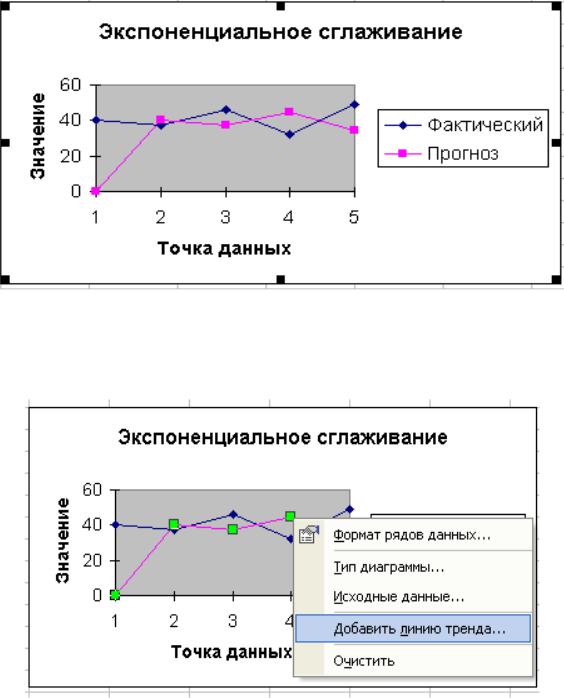
–установим флажок на команде вывод графика;
–после того как все параметры заданы, щёлкнем по кнопке ОК, Excel выполнит все необходимые вычисления и разместит результаты на листе.
5. Правой кнопкой мыши нажмите на одно из значений графика Прогноз. Далее в диалоговом окне выберите Добавить линию тренда.
6. В диалоговом окне Линия тренда выберите тип предполагаемой зависимости, например, предположим, что зависимость линейная. Далее выберите команду Параметры, в появившемся диалоговом окне отметьте флажок на команде
Показать уравнение на диаграмме.
38
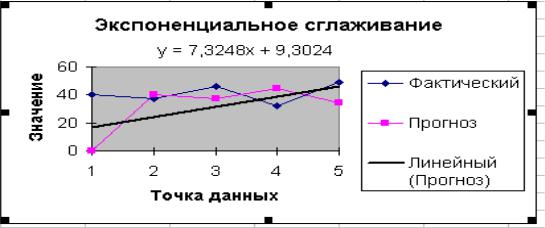
С помощью полученного уравнения У= 7,3248х + 9,3024 получим прогнозное значение У = 7,3248*6 + 9,3024, где «6» – период прогноза. Получим 53,25 млн руб. – прогнозное значение объёма расходов на капитальный ремонт в ЖКХ города на следующий год.
3.2. Корреляционно-регрессионный анализ в макроэкономическом прогнозировании
Большинство явлений и процессов в экономике находится в постоянной взаимной и объективной связи. Исследование зависимостей и взаимосвязей между объективно существующими явлениями и процессами играет большую роль в экономике. Оно даёт возможность глубже понять сложный механизм причинноследственных отношений между явлениями. Для исследования интенсивности, вида и формы зависимостей широко применяется корреляционно-регрессионный анализ, который является методическим инструментарием при решении задач прогнозирования и планирования.
Различают два вида зависимостей между экономическими явлениями и процессами – функциональную и стохастическую (вероятностную, статистическую).
В случае функциональной зависимости имеется однозначное отображение множества А на множество В. Множество А называют областью определения функции, в множество В – множеством значений функции.
Функциональная зависимость встречается редко. В большинстве случаев функция (Y) или аргумент (Х) – случайные величины. Х и Y подвержены действию различных случайных факторов, среди которых могут быть факторы, общие для двух случайных величин.
Статистической называется зависимость между случайными величинами,
39
при которой изменение одной из величин влечёт за собой изменение закона распределения другой величины. В этом случае говорят о корреляционной зависимости. В экономике приходится иметь дело со многими явлениями, имеющими вероятностный характер. Например, к числу случайных величин можно отнести стоимость продукции, доходы бюджетов и др.
Односторонняя вероятностная зависимость между случайными величинами есть регрессия. Она устанавливает соответствие между этими величинами.
Односторонняя стохастическая зависимость выражается с помощью функции, которая называется регрессией. В общем виде такая зависимость может быть представлена следующим образом:
Yit =f (Xkt, et ),
где Yit – i-я зависимая переменная в момент времени t, Xkt – k-я независимая переменная (фактор) в момент времени t, et – ошибка наблюдения в момент времени t.
Уравнение регрессии характеризует взаимосвязь переменных X и Y в том смысле, что показывает, как изменяется величина Y в зависимости от изменения величины Х.
Перечислим различные виды регрессии.
1. Регрессия относительно числа переменных:
–простая регрессия – регрессия между двумя переменными;
–множественная регрессия – регрессия между зависимой переменной Y и несколькими независимыми переменными Х1,Х2…Хm.
2. Регрессия относительно формы зависимости:
–линейная регрессия, выражаемая линейной функцией;
–нелинейная регрессия, выражаемая нелинейной функцией.
3. В зависимости от характера регрессии различают:
–положительную регрессию. Она имеет место, если с увеличением (уменьшением) независимой переменной значения зависимой переменной также соответственно увеличиваются (уменьшаются);
–отрицательную регрессию. В этом случае с увеличением или уменьшением независимой переменной зависимая переменная уменьшается или увеличивается.
Регрессия тесно связана с корреляцией. Корреляция в широком смысле слова означает связь, соотношение между объективно существующими явлениями. Связи между явлениями могут быть различны по силе. При измерении тесноты связи говорят о корреляции в узком смысле слова.
Понятия «корреляция» и «регрессия» тесно связаны между собой. В корреляционном анализе оценивается сила связи, а в регрессионном анализе исследуется
40