Материал: 5478
61
Простая случайная выборка – это вероятностный метод выборки, согласно которому каждая единица ГС имеет известную и равную вероятность отбора. Другими словами, все имеют одинаковый шанс попасть в выборку. Для формирования данной выборки используют методы случайных чисел или вслепую.
При простой случайной выборке с использованием статистических таблиц случайных чисел исследователь должен иметь пронумерованный список ГС (контура выборки). Затем генерируют случайные числа, чтобы определить номер единиц, которые будут включены в выборку. Генерация случайных чисел происходит произвольно. В таблице выбирают любую начальную цифру и от нее двигаются в любом направлении, причем меняя направление движения, пока не выберут необходимое число респондентов либо эту работу выполняет компьютер.
При использовании метода вслепую единицы совокупности также нумеруются, вносятся в карточки и помещаются в барабан (по принципу лотереи), который встряхивают и из него вынимаются отдельные таблички.
Достоинством метода считается объективность, т.к. у всех есть равный шанс, простота понимания и выполнения.
Недостаток метода – трудно определить каждую единицу контура выборки, особенно при крупных генеральных совокупностях; высокие затраты на проведение.
Систематическая выборка – это вероятностный метод выборки, предполагающий некую систему, в соответствии с которой сначала задается произвольная отправная точка, а затем из контура выборки последовательно, через равные интервалы выбираются остальные элементы. В данном случае используют «интервал скачка», рассчитанный как соотношение размера контура выборки к объему выборки. Например, совокупность состоит из 10 тыс. элементов, желательный объем выборки равен 100. Тогда 10000: 100 = 100. В нашем примере интервал скачка равен 100. Затем выбирается случайное число между 1 и 100. Если, например, это число 23, то в выборку войдут следующие элементы ГС 23, 123, 223, 323, 423 и т.д.
Данный метод целесообразно использовать, если есть справочники. Обычно применяют при почтовых, телефонных опросах или личных интервью в торговых центрах (опрашивается, например, каждый пятый посетитель, покидающий универмаг, если интервал скачка равен 5).
Достоинство метода:
-экономит время, а значит, деньги;
-если ГС обладает информацией об исследуемой характеристике, то выборка
более репрезентативна, чем простая случайная. Недостатки метода аналогичны предыдущей выборке.
Кластерная выборка основана на делении совокупности на группы (кластеры), каждая из которых представляет совокупность в целом. Элементы кластера должны быть максимально разнородны, а сами кластеры – как можно более однородны. В идеале каждый кластер должен представлять собой небольшую модель генеральной совокупности. После определения кластеров, которые будут подвергаться обследованию, случайным способом из элементов кластера формируется выборка. При использовании данной выборки контур выборки нужен только для кластеров, которые вошли в выборку. Полученные результаты от кластера распространяются на всю совокупность.
Распространенной формой кластерной выборки считается территориальная выборка, в которой кластеры состоят из округов, микрорайонов, краев, кварталов.
Достоинством метода является:
-легкость применения, т.к. не требуется список всей совокупности;
-эффективность с точки зрения затрат;

62
Недостаток:
-низкая точность, т.к. сложно сформировать неоднородные кластеры (например, жители одного квартала могут иметь больше сходства, чем различий, что не соответствует генеральной совокупности).
Перечисленные методы приемлемы, если генеральная совокупность характеризуется симметричным распределением изучаемой характеристики среди элементов совокупности. Если распределение несимметрично, то есть смысл использовать метод стратифицированной выборки.
Стратифицированная выборка – это двухэтапный метод вероятностной выборки, согласно которому генеральная совокупность делится на подгруппы (страты) по какимлибо признакам таким образом, чтобы каждый элемент совокупности относился только к одному слою. Затем из слоев простым случайным способом отбираются элементы выборки. При этом доля каждой страты в общем объеме выборки соответствует ее удельному весу в генеральной совокупности. Элементы, относящиеся к одной страте, должны быть как можно более однородными, а относящиеся к разным слоям, как можно более разнородными. Кроме того, признак, в соответствии с которым выделены страты, должен быть тесно увязан с исследуемой переменной. Признаком стратификации могут быть демографические переменные, размер фирмы, уровень дохода, отрасль промышленности.
Количество страт в стратифицированной выборке остается предметом спора между специалистами. Практический опыт показывает, что следует использовать не более шести страт.
Достоинство метода:
-включает все важные подгруппы совокупности;
-обеспечивает высокую точность.
Недостаток:
-сложно выбрать подходящие переменные,
-невозможно стратифицировать с учетом нескольких переменных (более двух);
-высокие затраты.
Невероятностные методы предполагают неслучайный отбор респондентов и в значительной степени основаны на индивидуальных предпочтениях исследователя. В результате применения данных методов мнение единиц выборки может отличаться от мнения элементов генеральной совокупности. Это порождает систематические ошибки данных исследования. Используя невероятностные выборки, можно получить детальную оценку характеристик совокупности, но насколько точны полученные данные определить невозможно, т.к. неясна вероятность включения в выборку каждой единицы. Поэтому невероятностные выборки считаются нерепрезентативными и сведения, полученные от лиц, выделенных таким образом, сложно распространять на генеральную совокупность.
Виды невероятностных методов:
метод, основанный на принципе удобства (нерепрезентативная выборка); на основе суждения исследователя (поверхностная выборка); в ходе обследования (выборка по принципу «снежного кома»); квотная выборка.
Метод, основанный на принципе удобства, заключается в том, что исследователь формирует выборку самым удобным для него способом (с точки зрения затрат и времени). Например, опрос покупателей проводится в магазине, ближайшем от места жительства исследователя. Очевидно, что многие представители совокупности не примут участия в опросе. Данный метод применим только в поисковых исследованиях, направленных на выявление новых идей, гипотез, уточнение характеристик объекта
63
исследования. Нерепрезентативные выборки можно применять для фокус-групп при предварительных опросах, но все же следует проявлять осторожность в оценке полученных результатов.
Достоинство метода – экономичность (с точки зрения времени и затрат), удобство отбора.
Недостаток – необъективность отбора, нерепрезентативность.
Формирование выборки на основе суждений основано на использовании мнения компетентного специалиста (исследователя). Считается, что исследователь, обладая опытом и знаниями, может достаточно точно отобрать единицы выборки, которые будут представлять ГС.
Типичные примеры поверхностной выборки: избирательные участки для изучения поведения избирателей; универмаги, выбранные для тестирования новой системы выкладки товара; инженеры, покупающие промышленное оборудование, выбранные для участия в исследовании, потому, что они являются представителями компаний определенной отрасли. На основе такого подхода часто формируются фокус-группы.
Достоинство – низкая стоимость, удобство, быстрота.
Недостаток – субъективность, результаты зависят от компетентности исследователя.
Формирование выборки в ходе обследования основано на расширении числа опрашиваемых путем получения сведений о них от первых респондентов, принявших участие в опросе. Формируют начальную группу респондентов (методом случайного отбора) и затем их просят назвать других кандидатов, входящих в совокупность. Процесс, когда каждый опрошенный называет другого кандидата, приводит к эффекту «снежного кома».
Главная задача такой выборки – дать оценку необычным для совокупности характеристикам. Например, людям, имена которых не разглашаются, получающим социальную помощь – продовольственные талоны; отдельным группы населения – сексуальным меньшинствам.
Данная выборка применяется также при исследованиях деловых рынков, где контур выборки является ограниченным, например, когда необходимо определить взаимовыгодных партнеров.
Достоинство метода:
-позволяет оценить необычные для совокупности характеристики;
-невысокие затраты.
Недостаток – требует много времени.
Квотная выборка – метод невероятностной выборки, структура которой строится по аналогии с распределением изучаемого признака в генеральной совокупности. Проводится в два этапа. Сначала формируются квоты из элементов ГС в соответствии с каким - либо признаком (обычно пол, возраст, профессия, вид деятельности – эти данные известны из статистических сборников и других исследований). Затем методом удобства или на основе мнений исследователя отбираются респонденты из каждой квоты. Причем квоты устанавливаются таким образом, чтобы доля респондентов в выборке, обладающая определенными характеристиками, соответствовала доле элементов ГС, обладающей такой же характеристикой. Например, если ГС включает 55% женщин и 45% мужчин, то при объеме выборки 400 человек, необходимо опросить 220 женщин и 180 мужчин.
Основное допущение этого метода состоит в том, что если выборка репрезентативна по признаку квотирования, то она будет репрезентативна и относительно распределения мнений по предмету исследования.
64
Достоинство метода:
–низкая стоимость;
–удобство выбора элементов для каждой квоты;
–возможность регулировать выборку по определенным характеристикам; Недостаток – большая вероятность необъективности при отборе. Например,
опрашиваем тех, кто находится рядом и избегаем тех, кто далеко живет, недружелюбен или просто не симпатичен.
Кроме того, следует сказать еще о двух методах, между которыми исследователь может сделать выбор. Это повторная и бесповторная выборка.
Повторная выборка – это метод, согласно которому элементы ГС можно неоднократно включать в выборку. Исследователь выбирает из контура выборки элемент и получает необходимую информацию. Затем возвращает элемент в контур выборки. Таким образом, элемент может неоднократно попадать в выборку.
Бесповторная выборка – это метод, согласно которому элемент совокупности нельзя включать в выборку более одного раза. Другими словами, изученный элемент удаляется из контура выборки.
Статистические выводы при использовании этих двух методов похожи, если контур выборки намного больше конечного объема выборки. Следовательно, различия в результатах важно учитывать только тогда, когда контур выборки ненамного больше объема выборки.
5.3. Определение объема выборки
Объем выборки – это число респондентов, которые вошли в выборку и от которых будет получена информация.
На практике используется несколько методов определения объема выборки:
 произвольный метод основан на применении «правила большого пальца». Бездоказательно принимается, что для получения точных данных достаточно сформировать выборку на уровне 5 – 10% от генеральной совокупности.
Достоинство – прост в исполнении; Недостаток – нельзя установить точность данных, а при больших ГС может быть
дорогим.
 метод, основанный на заранее оговоренных условиях. Заказчик сам задает объем выборки, принимая во внимание тот факт, что обычно социологические исследования общественного мнения охватывают 100, 1000 или 1200 респондентов. В отличие от первого метода здесь имеется определенная логика, но и она может быть уязвима. Ведь исходя из целей исследования не всегда нужна высокая точность, как при проведении опросов общественного мнения, и объем совокупности может быть значительно меньшим.
Достоинство метода – простота;
Недостаток – не принимаются в расчет текущие обстоятельства, что делает его затратным.
 затратный метод основан на размере расходов, которые можно выделить на проведение исследования. Стоимость исследования во многих случаях становится главным аргументом. Используя данный метод представляется разумным учитывать затраты на проведение исследований не абсолютным образом, а по отношению к полезности информации, полученной в ходе исследования. Заказчик и исследователь должны рассмотреть различные объемы выборки, затраты и учесть ценность полученной информации.
Достоинство метода – простота и ясность;
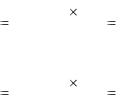
65
Недостаток – не все цели исследования могут быть достигнуты.
 статистический метод расчета считается наиболее точным и основан на определении объема выборки исходя из требований к точности полученных результатов.
Точность результатов регулируется величиной максимальной ошибки выборки (ошибки репрезентативности) и величиной доверительной вероятности, с которой делается заключение о достоверности результатов исследования. Вероятность, с которой можно утверждать, что ошибка выборки не превысит некоторую заданную величину, называется доверительной вероятностью или вероятностью того, что изучаемый параметр совокупности попадает в доверительный интервал.
Доверительный интервал – это диапазон, в который попадает истинное значение параметра совокупности при заданном уровне доверительности.
Рассчитывается объем выборки по следующей формуле:
|
z2 |
pg |
z2 p(1 – p) |
||
n = |
|
|
= |
|
, |
|
|
|
|||
|
e2 |
|
|
e2 |
|
где n – объем выборки;
Z – нормированное отклонение (специальный коэффициент доверия, определяемый исходя из выбранного уровня доверительности). Находится по специальным статистическим таблицам (значение интеграла вероятностей), которые дают возможность определить Z для разных доверительных интервалов;
P – вариация для выборки. Характеризует величину схожести ответов респондентов на определенный вопрос. При высокой схожести ответов говорят о малой вариации, при невысокой схожести – вариация большая. Данная величина берется из ранее проведенных исследований, если их не было, то берется за 50% или 0,5 (грубая оценка или наименее выгодный случай), поскольку при р = 50% объем выборки максимальный;
g – (100 – р);
e – ошибка выборки, характеризует отклонение истинного значения признака в ГС от значения признака в выборке. Планируется исследователем: чем выше значение е, тем больше ошибка.
Показатели Z и е - оговариваются с заказчиком.
Следует учесть, что чем выше уровень доверительности и меньше ошибка выборки, тем больше объем выборки. Например,
n |
1,962 |
(50 |
50) |
96 ; |
||
|
|
102 |
|
|||
|
|
|
|
|
|
|
n |
1,962 |
(50 |
50) |
|
364 . |
|
|
|
52 |
|
|
||
|
|
|
|
|
|
|
Обычно при проведении маркетинговых исследований выбирают два значения уровня доверительности – 95% и 99%. При 95% Z = 1,96, при 99% - 2,58. Если выбирают уровень доверительности 95%, то говорят, что уверены на 95%, что процент членов генеральной совокупности, попавших в диапазон – + е (величина ошибки выборки) равен проценту членов выборки, попавших в тот же диапазон.