Материал: конспект-лекций
176
ний, развивающихся во времени или по любой другой переменной, решает теория случайных про-
цессов.
В качестве универсальной координаты для распределения случайных величин по независи-
мой переменной будем использовать, как правило, переменную "t" и трактовать ее, чисто для удобства, как временную координату. Распределения случайных величин во времени, а равно и сигналов их отображающих в любой математической форме, обычно называют случайными (или стохастическими) процессами. В технической литературе термины "случайный сигнал" и "случай-
ный процесс" используются как синонимы.
В отличие от детерминированных сигналов значения случайных сигналов в произвольные моменты времени не могут быть вычислены. Они могут быть только предсказаны в определенном диапазоне значений с определенной вероятностью, меньшей единицы. Количественные характе-
ристики случайных сигналов, позволяющие производить их оценку и сравнение, называют ста-
тистическими.
В процессе обработки и анализа физико-технических данных обычно приходится иметь де-
ло с тремя типами сигналов, описываемых методами статистики. Во-первых, это информационные сигналы, отображающие физические процессы, вероятностные по своей природе, как, например,
акты регистрации частиц ионизирующих излучения при распаде радионуклидов. Во-вторых, ин-
формационные сигналы, зависимые от определенных параметров физических процессов или объ-
ектов, значения которых заранее неизвестны, и которые обычно подлежать определению по дан-
ным информационным сигналам. И, в-третьих, это шумы и помехи, хаотически изменяющиеся во времени, которые сопутствуют информационным сигналам, но, как правило, статистически неза-
висимы от них как по своим значениям, так и по изменениям во времени. При обработке таких сигналов обычно ставятся задачи:
обнаружение полезного сигнала,
оценка параметров сигнала,
выделение информационной части сигнала (очистка сигнала от шумов и помех),
предсказание поведения сигнала на некотором последующем интервале (экстраполяция).
9.1. СЛУЧАЙНЫЕ ПРОЦЕССЫ И ФУНКЦИИ [1, 2, 25].
Случайный процесс описывается статистическими характеристиками, называемыми мо-
ментами. Важнейшими характеристиками случайного процесса являются его стационарность, эр-
годичность и спектр мощности.
Случайный процесс в его математическом описании Х(t) представляет собой функцию, ко-
торая отличается тем, что ее значения (действительные или комплексные) в произвольные момен-
ты времени по координате t являются случайными. Строго с теоретических позиций, случайный процесс X(t) следует рассматривать как совокупность временных функций xk(t), имеющих опреде-
ленную общую статистическую закономерность. При регистрации случайного процесса на опре-
177
деленном временном интервале осуществляется фиксирование единичной реализации xk(t) из бес-
численного числа возможных реализаций процесса X(t). Эта единичная реализация называется
выборочной функцией случайного процесса X(t). Отдельная выборочная функция не характеризует процесс в целом, но при определенных условиях по ней могут быть выполнены оценки статисти-
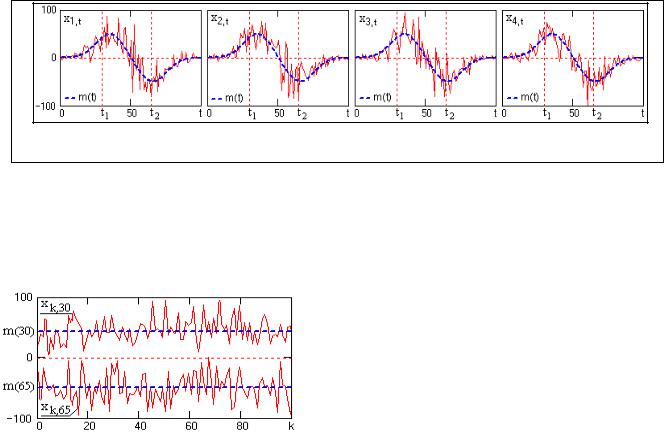
ческих характеристик процесса. Примеры выборочных функций модельного случайного процесса
X(t) приведены на рис. 9.1.1. В дальнейшем при рассмотрении различных параметров и характери-
стик случайных процессов для сопровождающих примеров будем использовать данную модель процесса.
Рис. 9.1.1. Выборочные функции случайного процесса.
Функциональные характеристики случайного процесса.
С практической точки зрения выборочная функция является результатом отдельного экспе-
римента, после которого данную реализацию xk(t) можно считать детерминированной функцией.
Сам случайный процесс в целом должен анализироваться с позиции бесконечной совокупности |
|
|
таких реализаций, образующих статистический ан- |
|
|
|
самбль. Полной статистической характеристикой |
|
процесса является N-мерная плотность вероятностей |
|
р(xn; tn). Однако, как экспериментальное определе- |
|
ние N-мерных плотностей вероятностей процессов, |
|
так и их использование в математическом анализе |
Рис. 9.1.2. Сечения случайного процесса |
представляет значительные математические трудно- |
|
|
X(t). |
сти. Поэтому на практике обычно ограничиваются |
|
|
|
|
одно- и двумерной плотностью вероятностей процессов. |
|
Допустим, что случайный процесс X(t) задан ансамблем реализаций {x1(t), x2(t),… xk(t),…}.
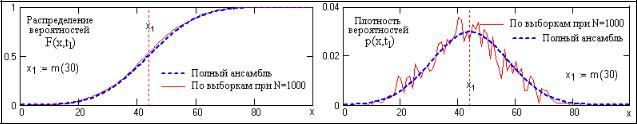
В произвольный момент времени t1 зафиксируем значения всех реализаций {x1(t1), x2(t1),… xk(t1),…}. Совокупность этих значений представляет собой случайную величину X(t1) и является одномерным сечением случайного процесса X(t). Примеры сечений случайного процесса X(t) по
100 выборкам xk(t) (рис. 9.1.1) в точках t1 и t2 приведены на рис. 9.1.2.
Одномерная функция распределения вероятностей F(x, ti) определяет вероятность того,
что в момент времени ti значение случайной величины X(ti) не превысит значения x:
F(x, ti) = P{X(ti)≤x}.
Очевидно, что в диапазоне значений вероятностей от 0 до 1 функция F(x, t) является неубы-
178
вающей с предельными значениями F(- ,t)=0 и F( ,t)=1. При известной функции F(x,t) вероят-
ность того, что значение X(ti) в выборках будет попадать в определенный интервал значений [a, b]
определяется выражением:
P{a<X(ti)≤b} = F(b, ti) – F(a, ti).
Одномерная плотность распределения вероятностей p(x, t) случайного процесса Х(t)
определяет вероятность того, что случайная величина x(t) лежит в интервале {x ≤ x(t) ≤ x+dx}.
Она характеризует распределение вероятностей реализации случайной величины Х(ti) в произ-
вольный момент времени ti и представляет собой производную от функции распределения вероят-
ностей:
p(x, ti) = dF(x, ti)/dx. |
(9.1.1) |
Моменты времени ti являются сечениями случайного процесса X(t) по пространству воз-
можных состояний и плотность вероятностей p(x, ti) представляет собой плотность вероятностей случайных величин X(ti) данных сечений. Произведение p(x, ti)dx равно вероятности реализации случайной величины X(ti) в бесконечно малом интервале dx в окрестности значения x, откуда сле-
дует, что плотность вероятностей также является неотрицательной величиной.
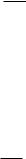
Рис. 9.1.3. Распределение вероятностей и плотность вероятностей сечения случайного процесса
На рис. 9.1.3 приведены примеры распределения вероятностей и плотности вероятностей сечения случайного процесса X(t) в точке t1 (рис. 9.1.1). Функции вероятностей определены по
N=1000 выборок дискретной модели случайного процесса и сопоставлены с теоретическими рас-
пределениями при N .
При известной функции плотности вероятностей вероятность реализации значения X(ti) в
произвольном интервале значений [a, b] вычисляется по формуле:
P(a<X(ti)≤b) = ab p(x,ti) dx.
Функция плотности вероятностей должна быть нормирована к 1, т.к. случайная величина обязана принимать какое-либо значение из числа возможных, образующих полное пространство случайных величин:
p(x, ti) dx =1.
Плотность распределения вероятностей, соответственно, определяет функцию распределе-
ния вероятностей:
180
где xo(t) = x(t)-mx(t).
Функция среднего квадратического отклонения (standard deviation) служит амплитудной мерой разброса значений случайного процесса по временной оси относительно математического ожидания процесса:
x(t) = Dx(t) . |
(9.1.5) |
Учитывая |
последнее выражение, дисперсия |
случайной величины обычно обозначается индексом
2.
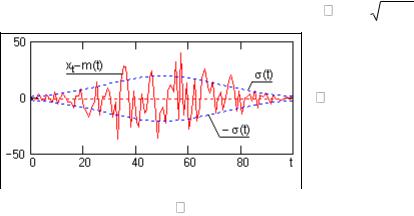
На рис. 9.1.4 приведен пример флюктуацион-
ной составляющей процесса X(t) (рис. 9.1.1) в одной из реализаций в сопоставлении со средним квадра-
тическим отклонением ± случайных величин от математического ожидания m(t).
Одномерные законы плотности распределения вероятностей случайных процессов не несут каких-либо характеристик связи между значениями случайных величин для различных значений
аргументов.
Двумерная плотность распределения вероятностей p(x1,t1; x2,t2) определяет вероят-
ность совместной реализации значений случайных величин Х(t1) и Х(t2) в произвольные моменты времени t1 и t2, что характеризует взаимосвязь случайного процесса в различные моменты времени и дает возможность определить характер изменения случайного процесса, т.е. динамику развития процесса во времени. Распределение описывает двумерную случайную величину {X(ti), X(tj)} в
виде функции вероятности реализации случайной величины X(ti) в бесконечно малом интервале dxi в окрестностях xi в момент времени ti при условии, что в момент времени tj значение X(tj) будет реализовано в бесконечно малом интервале dxj в окрестностях xj:
p(x1,t1; x2,t2) = P{x1 ≤ x(t1) ≤ x1+dx1 x2 ≤ x(t2) ≤ x2+dx2 }.
С помощью двумерной плотности распределения вероятностей можно определить корреля-
ционные функции процесса.
Корреляционные функции случайных процессов. Характеристикой динамики изменения случайной величины X(ti) является корреляционная функция, которая описывает случайный про-
цесс в целом:
RX(ti, tj) = M{X(t1) X(t2)}.
Корреляционная функция представляет собой статистически усредненное произведение значений случайного процесса X(t) в моменты времени ti и tj по всем значениям временных осей ti
и tj, а, следовательно, тоже является двумерной функцией. В терминах теории вероятностей корре-
ляционная функция является вторым начальным моментом случайного процесса.
На рис. 9.1.5 приведены примеры реализаций двух случайных процессов, которые характе-
ризуются одной и той же функцией математического ожидания и дисперсии.