Материал: Методические указания к самостоятельным работам по дисциплине «Моделирование систем и сетей телекоммуникаций» для студентов специальности «Информационная безопасность телекоммуникационных систем». Разинкин К.А
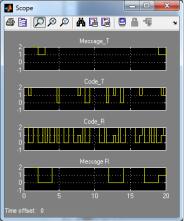
Рис. 17. Результаты моделирования: Ошибка кратности T2=ER=7. Code_T и Code_R не одинаковы. Часть ошибок осталась. Дисплей отображает этот факт числом
со знаком минус (-1)
Инструмент BERTool
В СКМ MATLAB имеется инструмент BERTool (Bit Error Rate Tool), позволяющий автоматизировать расчеты зависимости вероятности ошибок от отношения С/Ш для выбранного модема и канала связи. Окно инструмента содержит закладки:
 Theoretical. Расчеты выполняются по теоретическим формулам.
 Semianalitic. Расчеты выполняются полуаналитическими методами.
 Monte Carlo. расчеты выполняются методами Монте-
Карло.
Каждая закладка содержит средства графического инструмента пользователя для выбора параметров модели.
Контрольные вопросы:
1.Назначение инструмента BERTool.
2.BERTool. Закладка Theoretical.
3.BERTool. Закладка Semianalitic.
4.BERTool. Закладка Monte Carlo.
19

Задание
Выполнить сравнительный анализ модемов и кодеков в заданном диапазоне изменения отношения С/Ш при известном числе кодовых комбинаций М (табл. 3).
Таблица 3
Варианты заданий
№ |
M |
С/Ш в дБ |
0 |
2 |
0…15 |
1 |
4 |
0…16 |
2 |
8 |
0…17 |
3 |
16 |
0…20 |
4 |
2 |
0…22 |
5 |
4 |
0…23 |
6 |
8 |
0…24 |
7 |
16 |
0…26 |
8 |
8 |
0…24 |
9 |
16 |
0…26 |
3.3. Изучение кластеризации как метода многомерного статистического анализа
Пусть X1, X 2 ,..., X n — исходная совокупность объектов,
каждый из которых задан набором р признаков. Задача кластерного анализа состоит в разбиении исходной совокупности объектов на группы схожих, близких между собой объектов. Эти группы называют кластерами или таксонами. Другими словами, кластерный анализ это один из способов классификации объектов по их признакам.
Одна из концепций состоит в построении разбиения исходного множества объектов доставляющего оптимальное значение определенной целевой функции.
Пусть X1, X 2 ,..., X n - объекты, каждый из которых задан
набором р признаков. Распределения объектов по кластерам на однородные в некотором смысле группы должно удовлетворять критерию оптимальности, который выражается в терминах расстояния  X i X j между любой парой объектов
рассматриваемой совокупности.
20
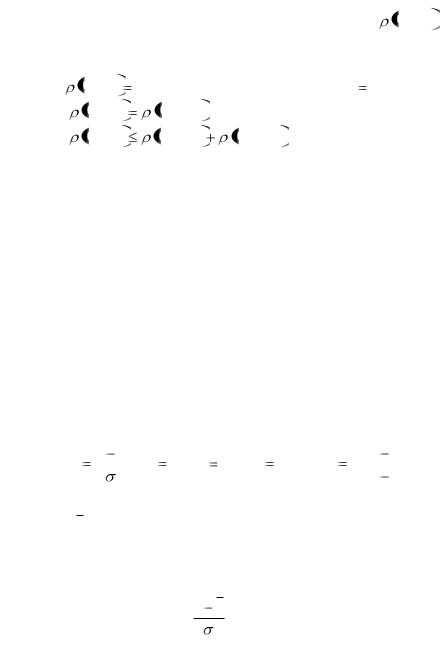
В качестве расстояния (метрики) может быть взята
любая неотрицательная действительная функция |
X i X j , |
|||
определенная на множестве |
X1, X 2 ,..., X n и удовлетворяющая |
|||
следующим условиям: |
|
|
||
а) |
X i X j |
0 тогда и только тогда, когда X i |
X j ; |
|
б) |
X i X j |
X j , X i ; |
|
|
в) |
X i X j |
X j , X i |
X k , X j ; . |
|
Выбор расстояния между объектами неоднозначен и в этом состоит основная сложность.
Наиболее популярной метрикой является евклидова. Эта метрика отвечает интуитивным представлениям близости. При этом на расстояние между объектами могут сильно влиять изменения масштабов (единиц измерения) по осям. Например, если один из признаков измерен в метрах, а затем его значение переведены в сантиметры (т.е. умножены на 100), то евклидово расстояние между объектами сильно изменится и это приведет к тому, что результаты кластерного анализа могут значительно отличаться от предыдущих.
Если признаки измерены в разных единицах измерения, то требуется их предварительная нормировка — такое преобразование исходных данных, которое переводит их в безразмерные величины.
Наиболее известные способы нормировки следующие:
|
|
|
|
|
|
x |
|
|
x |
|
|
|
|
|
|
|
|
|
|
z |
x x |
; z |
|
|
|
; z3 |
, |
z |
|
x |
, z |
|
x x |
, |
|||||
|
|
2 |
|
|
|
x' |
4 xmax |
5 xmax xmin |
|||||||||||
|
|
|
|
||||||||||||||||
1 |
|
|
|
|
x |
|
|
|
|
||||||||||
где zi , , i= l, 2, ..., 5 – нормированное значение; х – исходное
значение, x и  – соответственно среднее и среднее квадратическое отклонение х, х' – эталонное (нормативное) значение, xmax и xmin – наибольшее и наименьшее значение х.
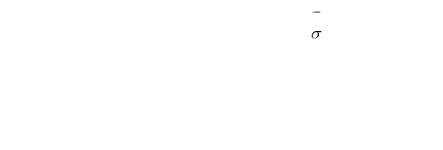
В пакете STATISTICA нормировка любой переменной
выполняется по формуле x x . Для этого нужно щелкнуть
правой кнопкой мыши на имени переменной и в открывшемся
21
меню выбрать: Fill/Standardize Block ->Standardize Columns.
|
|
|
|
|
Нормировка, особенно по формуле |
x x |
, |
сильно |
|
|
||||
искажает геометрию исходного пространства, что может изменить результаты кластеризации.
Выбор метрики для каждой задачи должен производиться с учетом целей кластеризации, свойств признаков анализируемых объектов, вероятностной структуры данных и т. п.
Методы кластерного анализа в пакете STATISTICA
В модуле Cluster Analysis пакета STATISTICA
реализуются следующие методы кластеризации[7]:
•соединения (древовидная кластеризация), Joining (tree clustering);
•метод K -средних (K-means clustering);
•двухвходовое объединение (Two-way joining).
Иерархические алгоритмы
Первая опция (Joining) представляет группу так называемых иерархических алгоритмов кластеризации. В основе этих алгоритмов лежит идея последовательной кластеризации. Пусть исходное множество содержит п объ-
ектов X1, X 2 ,..., X n .
В качестве расстояния между объектами Xt и Xj выбирается некоторая метрика р. Выбор метрики необходимо сделать в опции distance measure панели Joining.
На начальном шаге каждый объект рассматривается как отдельный кластер. На следующем шаге некоторые из ближайших друг к другу кластеров будут объединяться в один новый кластер. В зависимости от выбора меры, по которой определяется расстояние между кластерами, реализуются следующие методы объединения объектов в кластеры (выбор осуществляется в зависимости от меры расстояния между кластерами в опции: Amalgamation (linkage) rule).
1. Метод одиночной связи (Single Linkage). Кластеры
22
объединяются исходя из расстояния, измеряемого по методу «ближайшего соседа». Группы, между которыми расстояния самые маленькие, объединяются. Каждое объединение уменьшает число групп на единицу. Расстояние между группами определяется как расстояние между ближайшими членами групп. Метод приводит к «цепным» кластерам.
2.Метод полной связи (Complete Linkage). Расстояние между группами определяется как расстояние измеряемое по принципу «дальнего соседа». Расстояние между объединяемыми кластерами равно диаметру наименьшей сферы, содержащей оба кластера. Метод создает компактные кластеры в виде гиперсфер, которые плохо объединяются с другими кластерами. Если кластеры имеют удлиненную форму, то метод не работает.
3.Метод невзвешенного попарного среднего
(Unweightedpair-group average). Расстояние между кластерами определяется по принципу «средней связи».
4.Метод взвешенного попарного среднего (Weighted pairgroup average). Расстояние между кластерами определяется по
принципу «средней связи», но с учетом в качестве весов числа объектов, содержащихся в кластерах.
5. Невзвешенный центроидный метод (Unweighted pairgroup centroid). Расстояния между кластерами определяется как расстояние между их «центрами тяжести»
 Sl , Sm

 X ,Y .
6.Взвешенный центроидный метод (Weighted pair-group centroid). Расстояние между классами определяется как расстояние между их «центрами тяжести», но с учетом весов, определяемых по количеству объектов в каждом кластере (т. е.
сучетом размеров кластеров).
7.Метод Уорда (Ward's metod). В этом методе в качестве целевой функции используется сумма квадратов расстояний между каждым элементом и «центром тяжести» класса, содержащего этот элемент. Кластеризация представляет последовательную процедуру, на каждом шаге которой объединяются два таких класса, при объединении которых
23