Материал: Шпори Економіко-математичні методи і моделі
Аналіз якості моделі: довірчі інтервали для оцінок параметрів економетричної моделі.
У задачах регресійного аналізу важливе значення має припущення про нормальний розподіл випадкових величин, що задіяні в даній моделі
Будь-яка функція
має бути перевірена на значущість - за
доп спец критеріїв необхідно встановити,
чи зумовлено значення цієї функції лише
похибками вимірювання, чи вона відображає
якусь суттєву (значущу) інформацію.
Статистичну значущість кожного параметра
моделі можна перевірити за допомогою
t-критерію.
При цьому нульова гіпотеза має вигляд
 ,Альтернативна
 .
Експериментальне
значення t-статистики
для кожного параметра моделі обчислюється
за формулою
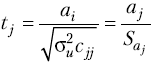 де сjj
– діагональний елемент матриці
 ;
 – стандартизована похибка оцінки
параметра моделі,
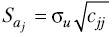 .
Експериментальне значення tj-критерію порівнюється з табличним значенням tтабл з n-m-1 ступенями свободи при заданому рівні значущості α/2 (критична область розбивається на два фрагменти, межі яких задаються квантилем α/2). Якщо значення tj-статистики за абсолютним значенням перевищує tтабл, приймається альтернативна гіпотеза про значущість відповідного параметра - роб в-к про статис незначущість параметра аj, а це означає, що відповідна незалежна змінна не впливає суттєво на змінювання регресанда.
Оскільки tj -статистика є відношенням відповідного параметра моделі до його стандартної похибки (середньоквадратичного відхилення), то на практиці частіше застосовують грубішу оцінку а саме допускають, щоб стандартні похибки становили 45-50 % значення параметра, аби стверджувати про його статистичну значущість.
Довірчі інтервали
для кожного окремого параметра аj
обчислюються на основі його стандартної
похибки та критерію Стьюдента: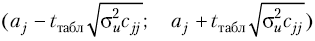 .
Табличне значення
tтабл
, як і
раніше, має n-m-1
ступенів свободи і рівень значущості
α/2
(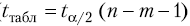 ).
Таким
чином, довірчі інтервали для оцінок
параметрів визначаються межами:
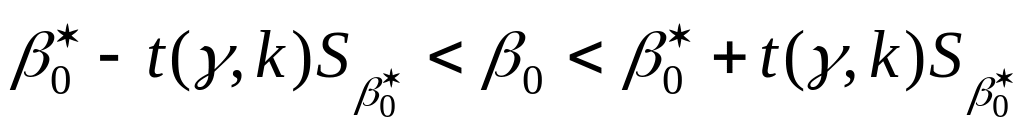
аналогічно для
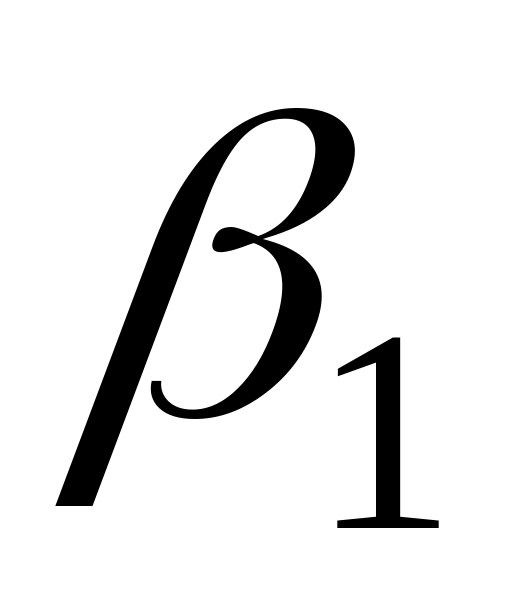 маємо:
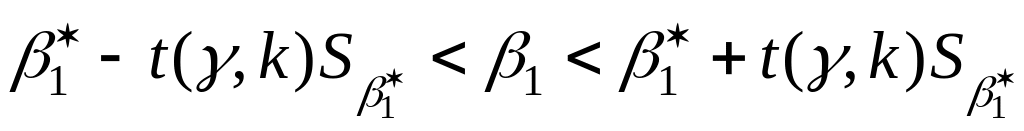
де
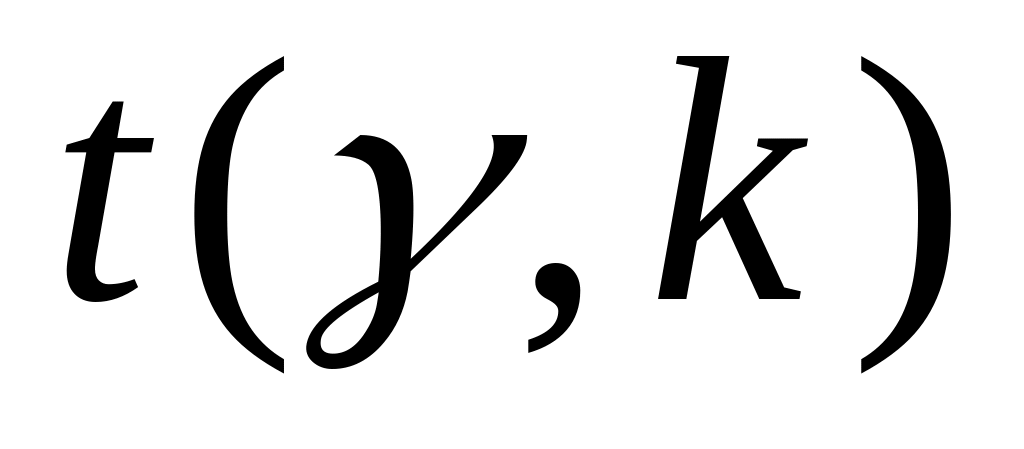 визначається за таблицею розподілу
Стьюдента по заданій надійності
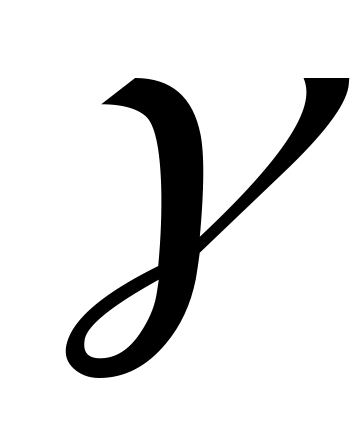 і числу ступенів свободи
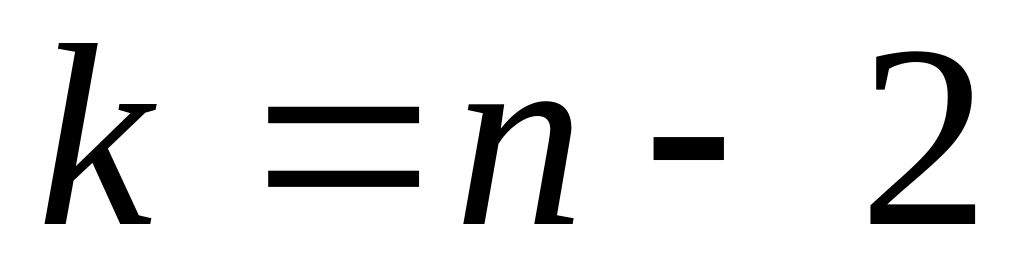 .
Аналіз якості моделі: перевірка загальної якості рівняння регресії.
Для перевірки коректності побудови моделі визначають насамперед: стандартну похибку рівняння;коефіцієнт детермінації;коефіцієнт множинної кореляції;
Стандартна похибка
рівняння (точкова оцінка емпіричної
дисперсії залишків) характеризує
абсолютну величину розкиду випадкової
складової рівняння і обчислюється за
формулою
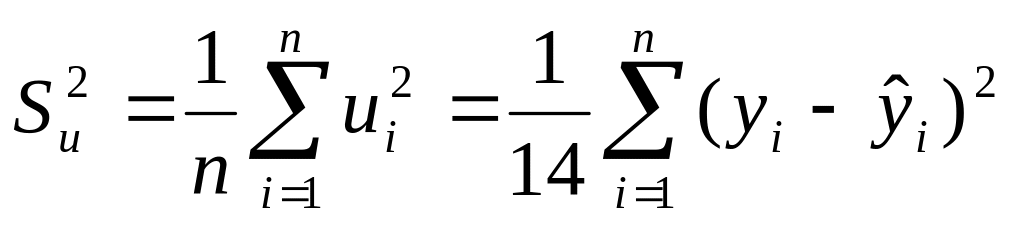 . (2.16)
Поправка на число
ступенів свободи дає незміщену оцінку
дисперсії залишків: 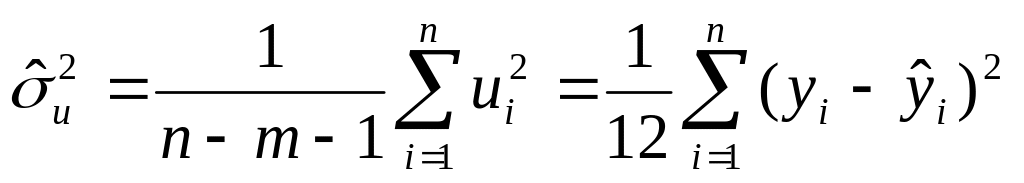 .
Коефіцієнт детермінації показує, якою мірою варіація залежної змінної (результативного показника) у визначається варіацією незалежної змінної (вхідного показника) х.
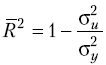
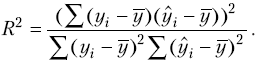
Коефіцієнт
кореляції,
або індекс кореляції, показує, наскільки
значним є вплив змінної хi , на yi і
розраховується так:
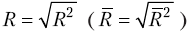
Аналіз якості моделі: перевірка статистичної значущості оцінок параметрів економетричної моделі.
Для перевірки
статистичної значущості коефіцієнта
детермінації R2
висувається
нульова гіпотеза H0
: R2
= 0
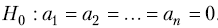 Альтернативною
до неї є HA:
значення хоча б одного параметра моделі
відмінне від 0.
Для перевірки цих гіпотез застосовують F-критерій Фішера з m і n-m-1 ступенями свободи. За отриманими в моделі значеннями коефіцієнта детермінації R2 обчислюють експериментальне значення F-статистики:
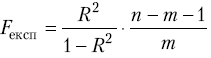 ,яке
порівнюють з табличним значенням
розподілу Фішера при заданому рівні
значущості α
(як правило, α
= 0,05 або α
= 0,01). Якщо Fтабл
< Fексп,
нульова гіпотеза відхиляється, свідчить
про адекватність
побудованої моделі. У протилежному
випадку модель вважається неадекватною.
Коефіцієнт
кореляції, як вибіркова характеристика,
перевіряється на значущість за допомогою
t-критерію
Стьюдента. Фактичне значення t-статистики
обчислюється за формулою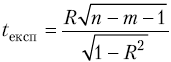 і
порівнюється з табличним значенням
t-розподілу
з n-m-1
ступенями свободи та при заданому рівні
значущості α/2
(такий рівень зумовлений тим, що критична
область складається з двох проміжків).
Якщо абсолютна величина експериментального
значення t-статистики перевищує табличне,
тобто
 ,можна
зробити висновок, що коефіцієнт кореляції
достовірний
(значущий), а зв’язок між залежною
змінною та всіма незалежними факторами
суттєвий.
4. Визначення дисперсій оцінок параметрів та їх стандартних помилок.
Щоб мати загальне судження про якість моделі, визначають стандартну похибку апроксимації:
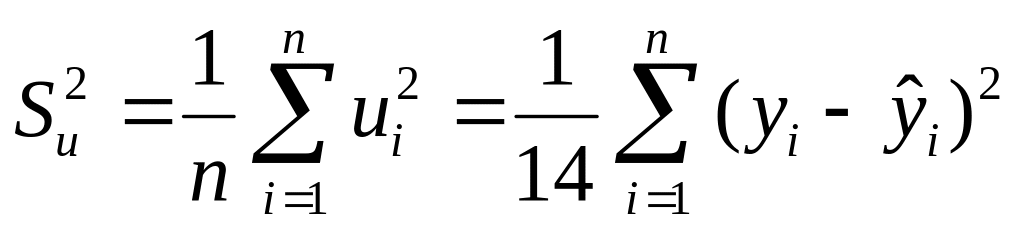 Незміщена
оцінка дисперсії залишків з поправкою
на кількість ступенів свободи:
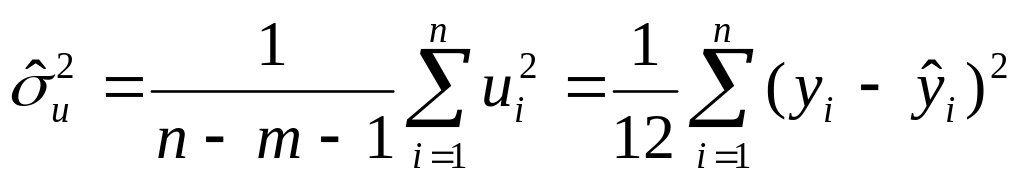
Стандартна похибка коефіцієнта регресії а1 визначається за формулою:
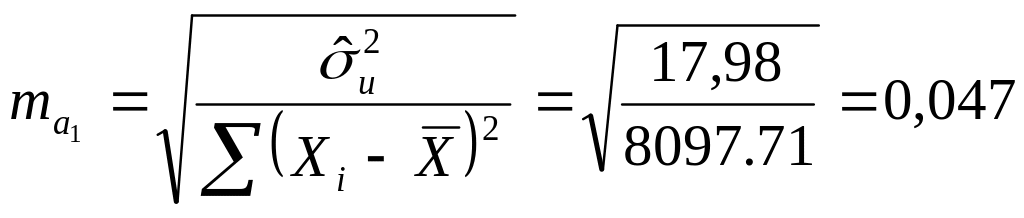 .
Стандартна похибка параметру a0 визначається за формулою:
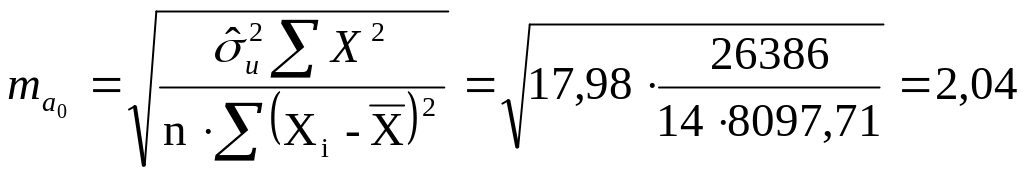 .
Величина стандартної похибки разом з t-розподілом Ст’юдента при n-2 ступенях свободи застосовуються для перевірки значущості коефіцієнтів регресії і для розрахунку їх довірчих інтервалів.
Стандартна похибка рівняння (точкова оцінка емпіричної дисперсії залишків) характеризує абсолютну величину розкиду випадкової складової рівняння і обчислюється за формулою
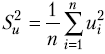 . (2.16)
Поправка на число ступенів свободи дає незміщену оцінку дисперсії залишків:
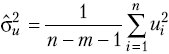 . (2.17)
Зрозуміло, що перевага віддається моделям, у яких стандартна похибка рівняння менша порівняно з іншими моделями. Однак така оцінка якості має суттєвий недолік: через те, що для неї не визначено верхню межу, порівняння різних моделей за цим критерієм досить проблематичне.
5. Визначення коефіцієнта еластичності
Виробнича функція — це економетрична модель, яка кількісно описує зв’язок основних результативних показників виробничо-господарської діяльності з факторами, що визначають ці показники. До основних показників можна віднести дохід, прибуток, рентабельність, продуктивність праці, собівартість і т.ін.
Функція Кобба — Дугласа (CDPF) належить до найвідоміших виробничих функцій, що набули широкого застосування в економічних дослідженнях, особливо на макрорівні. Класична виробнича функція Кобба — Дугласа має вигляд
Y = aFL. (2.5)
де Y — обсяг продукції; F — основн капітал; L — робоча сила.
Альфа показує на скільки % змін обсяг випуску продукції, якщо витрати капіталу змін на 1%, а витрати праці залиш незмінними. Такий показник наз Келастичності випуску за витратами праці.
Сума параметрів ( + ) є масштабом виробництва. Якщо ( + ) > 1, то темпи росту обсягу продукції вищі за темпи росту виробничих ресурсів, тобто зрост масштаб вир-ва, а якщо ( + ) < 1, то, навпаки, темпи росту продукції нижчі за темпи росту ресурсів.
6. Визначення параметрів вибраного рівняння.
Економічний зміст параметрів рівняння лінійної парної регресії:
параметр
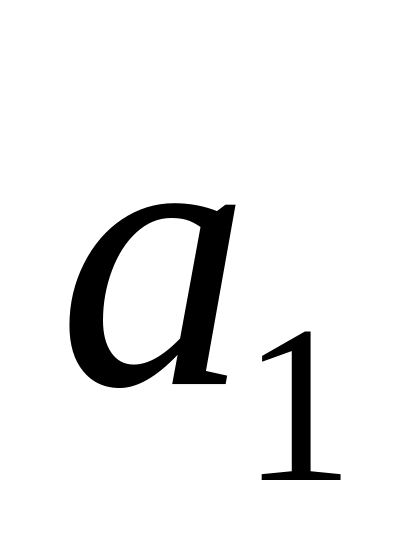 характеризує середню зміну результату
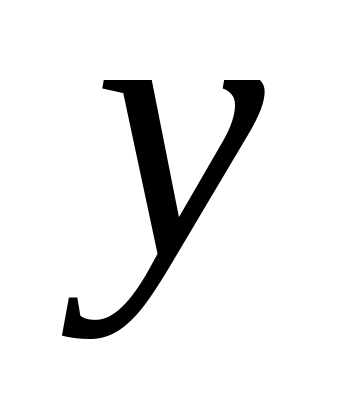 із зміною фактору
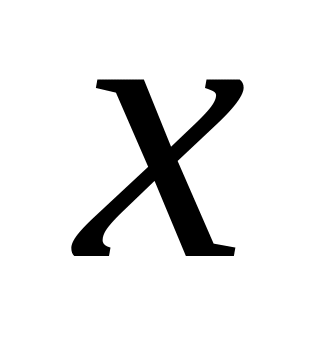 на одиницю. Параметр
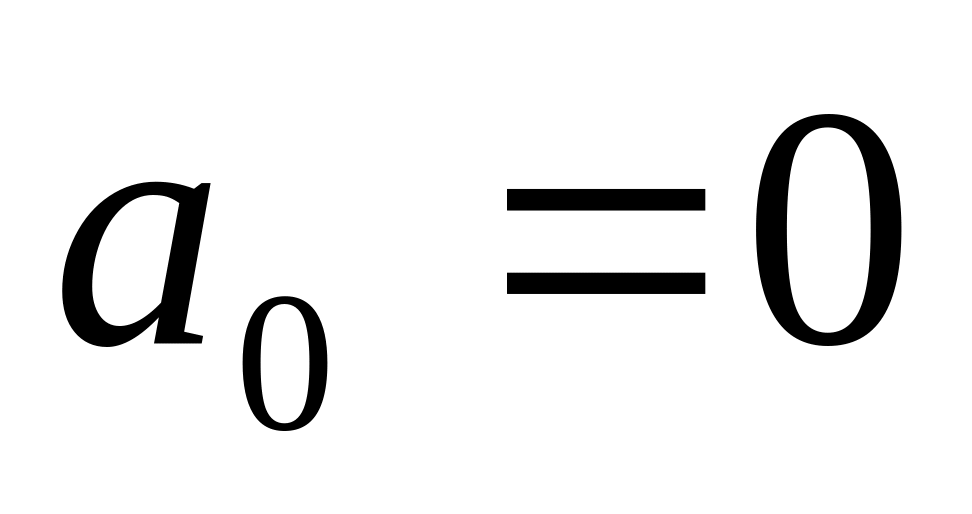 при
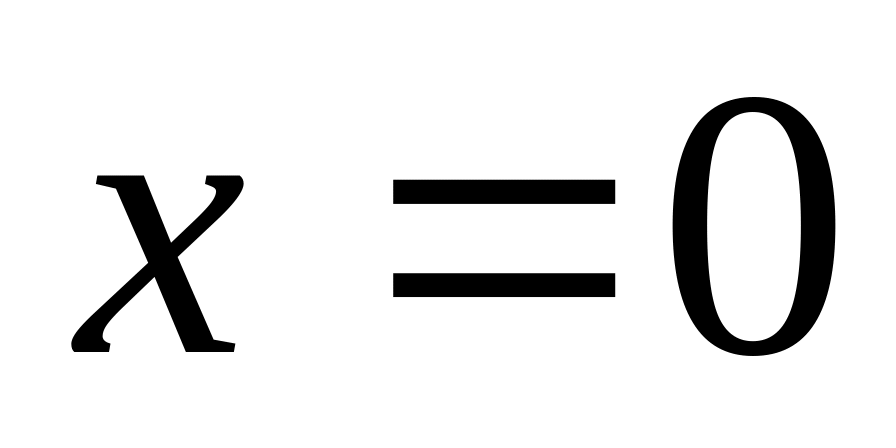 .
Якщо
не може бути рівним нулю, то параметр
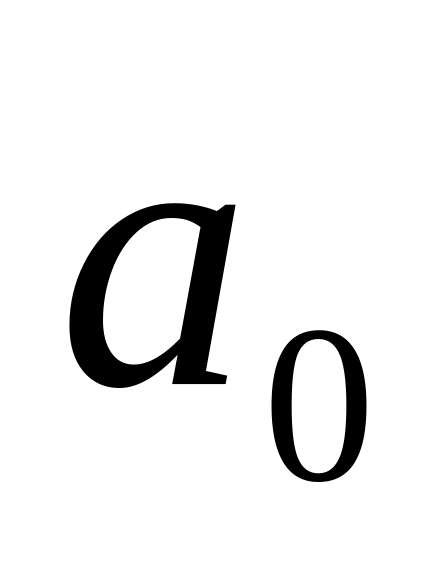 не має економічного змісту. Інтерпретувати
можна лише знак при
:
якщо
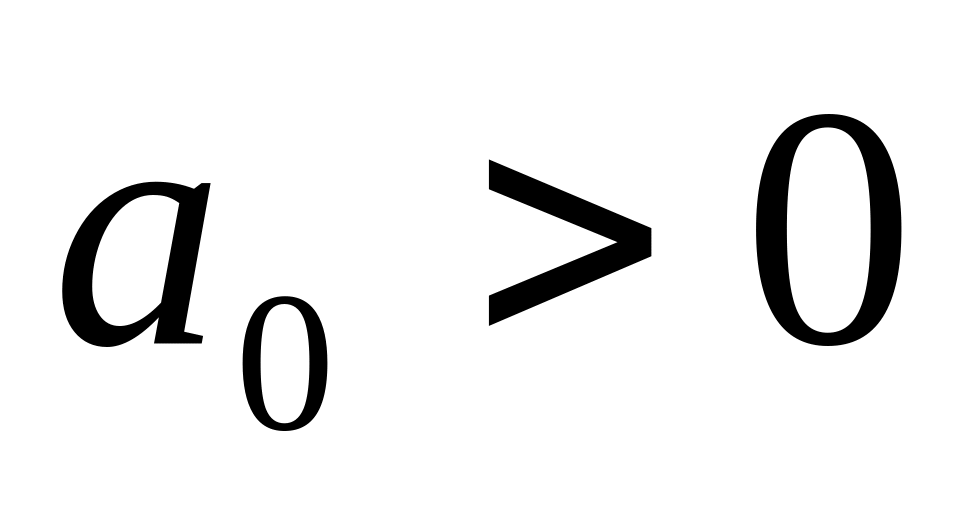 ,
то відносна зміна результату відбувається
повільніше, ніж зміна фактора і навпаки,
якщо
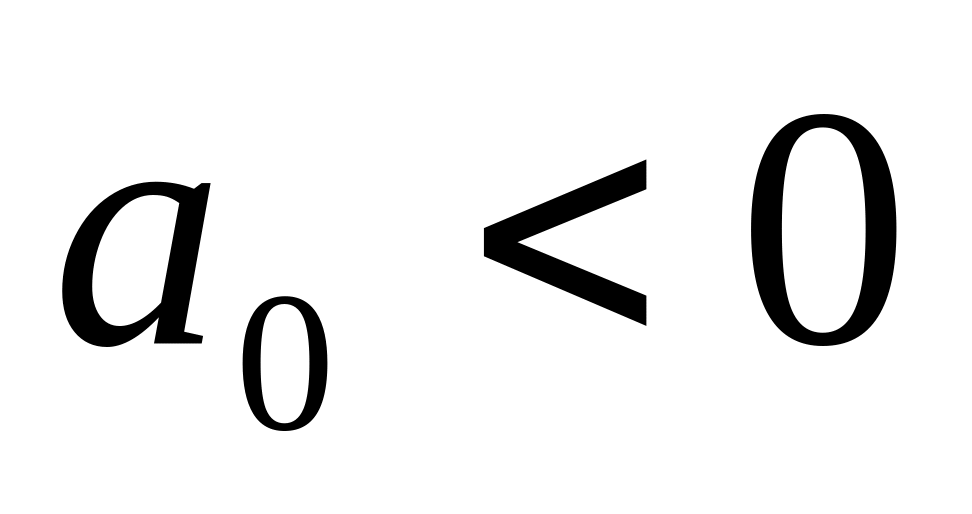 ,
то відносна зміна результату відбувається
швидше, ніж зміна фактора. Численні
значення параметрів лінійного
програмування регресійного рівняння
можуть бути отримані й за допомогою
графічного подання рівняння регресії.
Параметр а0
визначає
точку перетину прямої Уt
з віссю ординат, а другий параметр
рівняння а1-
це тангенс кута нахилу прямої до осі
абсцис, що визначає наскільки сильно
буде нахилена ця пряма до осі абсцис.
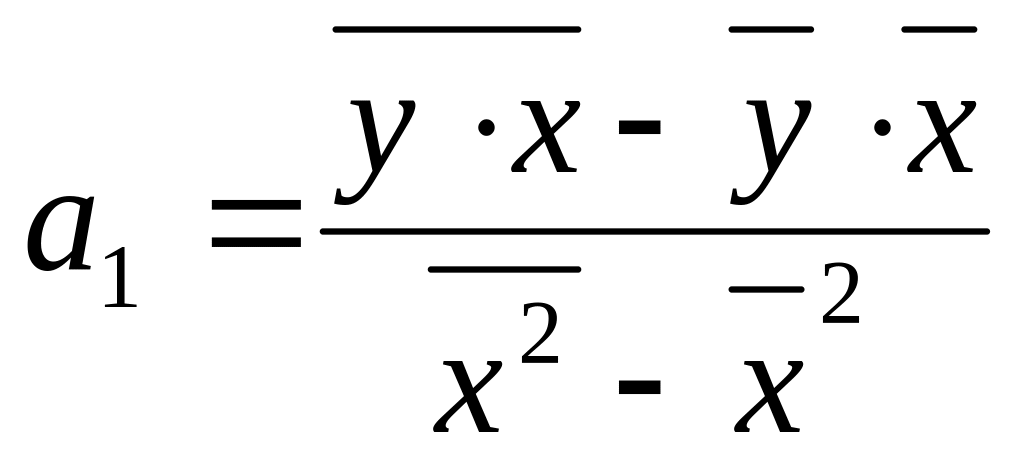
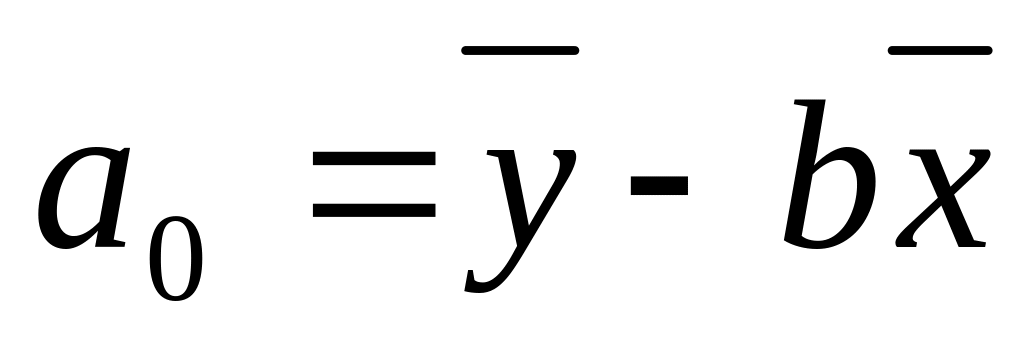
7. Визначення часткових коефіцієнтів еластичності.
Визначивши окремі коефіцієнти еластичності для виробничої функції Кобба — Дугласа, дістанемо:
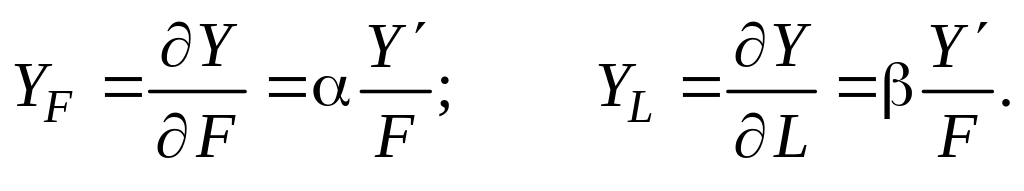 Це
означає, що граничний приріст продукції
за рахунок приросту кожного ресурсу
визначається як добуток коефіцієнта
еластичності на середню ефективність
ресурсу. Параметр a
у функції Кобба — Дугласа залежить од
вибраних одиниць вимірювання Y,
F,
L;
водночас числове значення цього параметра
визначається також ефективністю
виробничого процесу. У цьому можна
переконатись, порівнявши дві виробничі
функції, які відрізняються одна від
одної лише значенням параметра a.
Для
фіксованих значень F
і L
тій функції, в якої більше числове
значення параметра a,
відповідає більше значення Y.
Отже, і виробничий процес, який описується
цією функцією, буде ефективнішим. Другі
похідні функції Кобба — Дугласа мають
такий вигляд: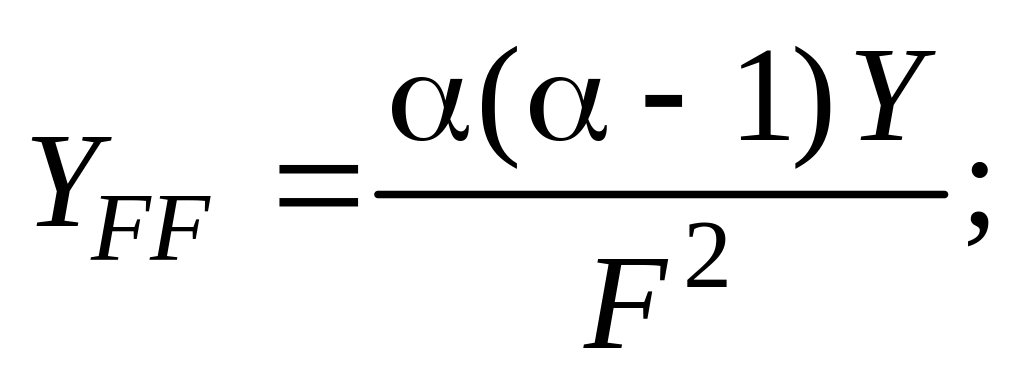
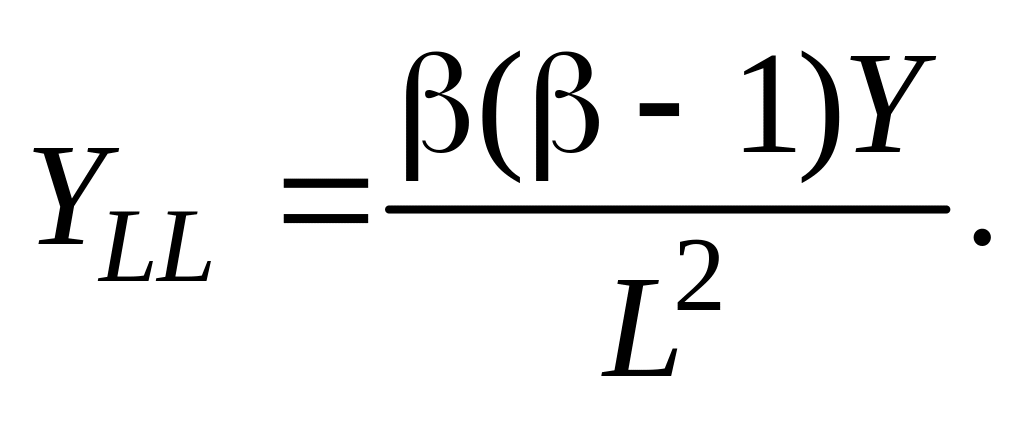
Узявши
до уваги, що 0 < < 1
і 0<<1,
YFF < 0
і YLL < 0,
дійдемо висновку: при збільшенні ресурсів
граничний приріст обсягу продукції
зменшуватиметься. Якщо обсяг продукції
у функції Кобба — Дугласа вважати сталим
(таким, що дорівнює const), то можна обчислити
граничні норми заміщення ресурсів: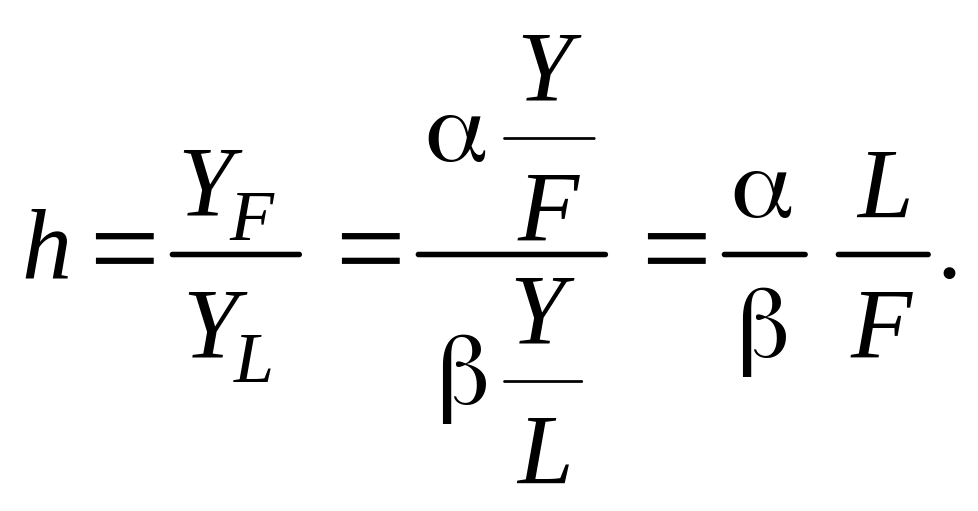 Звідси
бачимо, що гранична норма заміщення
ресурсів у функції
Кобба
— Дугласа визначається як добуток
співвідношень величин ресурсів та їх
коефіцієнтів еластичності.
8.Випадкові збудники в рівнянні лінійної регресії.
Щоб урахувати наявність впливу факторів, які не входять до економ. моделі, ввод. стохаст. складова U. Математ. аналіз цієї складової дає змогу зробити висновок про те чи можна її вваж. випадковою, чи містить вона системат част. відхилень, яка може бути зумовлена наявністю тих чи інших помилок у моделюванні. У клас. лінійній економ. моделі змінна u інтерпрет. як випадк. змінна, що має розподіл з мат сподів, яке =0, і пост. дисперсією. Це дає змогу розгляд змінну u як стохастичне збурення ( помилку, відхилення). Згідно з цент. Гоаничн. теоремою стохаст. складова економ. моделі розподілена за норм. законом.
Ut- випадкові збурювання ( помилки) , що характеризують відхилення фактичних значень ендогенної змінної від рівняння регресії ( теоретичної залежності). Джерелами виникнення помилок виступають труднощі у вимірювання у вимірі даних (помилки вимірів ендогенних і екзогенних змінних моделі), основна особливість процесу моделювання, яка полягає у тому, що будь-яка модель є спрощенням дійсності, та помилки специфікації моделі( включення несуттєвих регресорів у модель, включення істотних незалежних факторів і т.п).
Причини, що спонук. появу:
1)будь-яка економ. модель. є спрощення реальн. ситуації, яка є переплетінням різних ф-цій, багато яких не можливо врахувати в моделі.2) неправ. вибрана ф-ціон. залежн. внаслілок недостат. дослідження процесу. Так виробн. Ф-ція описує залежність У від Х може бути: У=β0+β1*х, та насправді не лінійна.3)не вірно вибрані пояснювальні змінні.
4) Складна форма зв’язку між цілими компон. подібн. величин.5)помилки при обробці та аналізі стат. даних.
6)будь-ка стат. функція обмежена, опис не перерв. факторами, але при використ. вибірк. даних з дискр. структурою.
7)людський фактор, який не можливо врахувати.