Дипломная (вкр): Статистическое исследование химической отрасли Российской Федерации
Значение
первого лага автокорреляционной функции остатков полученной модели выходит за
пределы доверительного интервала (рис.11), следовательно, автокорреляция в
остатках отсутствует. Полученные значения функции ACF не
демонстрируют зависимости от временных лагов и распределены хаотично,
следовательно, в остатках есть белый шум, полученная модель адекватна.
Адекватность модели подтверждается результатами теста Льюинга-Бокса (см.
приложение 2). В этом тесте принимается гипотеза Н0: гипотеза о том, что в
остатках есть белый шум, при альтернативной гипотезе Н1: данные не являются
случайными. После проведения теста на автокорреляцию получим: 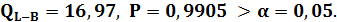 Следовательно,
нулевая гипотеза Н0 не отклоняется, остатки модели взвешенного скользящего
среднего обладают свойствами белого шума на уровне значимости 95%. Значит,
можем сделать вывод о том, что модель адекватна.
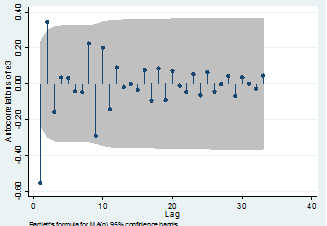
Рисунок
11. Автокорреляционная функция остатков модели взвешенного скользящего среднего
Представим
эту модель в математической форме. Мы делали сглаживание по полиному 2-ого
порядка, т.е. функция имеет такой изначальный вид: 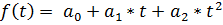 . После
«подставления» в эту функцию найденных значений параметров она принимает
следующий вид:
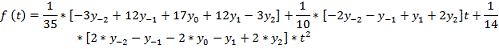
Для дальнейшего анализа временного ряда построим модель ARIMA(p, d, q), Auto Regressive Integrated Moving Average. Из анализа графиков функций автокорреляции и частной
автокорреляции индекса промышленного производства предприятий найдем значения
параметром p и q (рис. 11 и рис. 12).
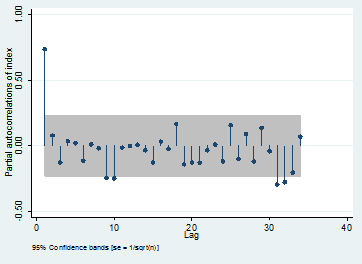
Рисунок
12. Частная автокорреляционная функция индекса промышленного производства
предприятий химической отрасли
Значения графика ACF снижаются, уходя в ноль после лага q, где q - параметр MA(q) процесса. При анализе этой совокупности данных значения автокорреляционной функции уходят в 0 после 2-ого лага. Таким образом, из графика ACF можно сделать вывод, что q=2. Значит, при построении моделей необходимо будет подбирать до 2 порядка.
Значения графика PACF уходят в ноль после лага p, где р - параметр AR(p) процесса. Исходя из построенного графика частной автокорреляционной функции для индекса промышленного производства химической отрасли, можно сказать, что значим только первый лаг, все остальные незначимы. Значит, параметр p=1. Возможна модель ARIMA (1, d, q). Из найденных значений p и q получается, что модель ARIMA примет вид: ARIMA (1, d, 2).
Для полного построения модели ARIMA(p, d, q) осталось определить порядок интеграции d. Для расчета этого значения необходимо проверить ряды на стационарность, мы сделаем это с помощью теста Дики-Фуллера. Если окажется, что анализируемый ряд не стационарен, то мы будем брать разность и проверять на стационарность ряд с разностью, будем проводить эти действия, пока не получим стационарный ряд. Количество взятых разностей для получения стационарного временного ряда и будет значением d - порядка интеграции.
Идея проверки AR(1) процесса на стационарность заключается в тестировании его
уравнения на единичный корень:
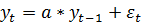 (2.2)
Следовательно,
берутся две гипотезы: Н0: a=1, с альтернативной гипотезой H1: a<1.
Изначальное уравнение для AR(1) можно преобразовать и представить в виде: 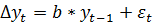 , где
 ,
 -
оператор разности первого порядка
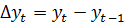 [14].
Проверка
гипотезы о единичном корне в данном представлении означает проверку нулевой
гипотезы о равенстве нулю коэффициента  при
альтернативной гипотезе, что коэффициент меньше
нуля: Н0: = 0, Н1: < 0.
Если = 0, то
 обладает
единичным корнем и является I(1), при условии, что ∆y- стационарный.
Если < 0, то y - стационарный: I(0).
С
помощью МНК-метода находят оценку коэффициента и стандартные ошибки. Затем на
их основе вычисляют 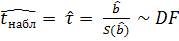 .
Описанный
тест является односторонним, т.к. случай «взрывных» процессов не
рассматривается. Статистика теста (DF-статистика) - это  -статистика для проверки значимости коэффициентов
линейной регрессии, распределение которой называется распределением
Дики-Фуллера.
Существует три версии теста (тестовых регрессий):
. Без константы и тренда
(2.3)
2. С константой, но без тренда:
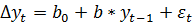 (2.4)
3. С константой и линейным трендом:
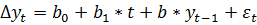 (2.5)
Для каждой из трёх тестовых регрессий существуют свои
критические значения DF-статистики, которые находятся из таблицы Дики - Фуллера
(МакКинона). Если при определенном уровне значимости значение статистики лежит
левее критического значения, то нулевая гипотеза о единичном корне отклоняется
и процесс стационарен. В противном случае гипотеза не отвергается и процесс
может содержать единичные корни, то есть может быть нестационарным временным
рядом.
Таблица 2. Результаты теста Дики-Фуллера для индекса промышленного производства предприятий химической отрасли
|
|
Тест без константы |
Тест с константой |
Тест с константой и трендом |
|
Модель |
модель: (1-L)y = (a-1)*y(-1) + e |
модель: (1-L)y = b0 + (a-1)*y(-1) + e |
модель: (1-L)y = b0 + b1*t + (a-1)*y(-1) +... + e |
|
Тестовая статистика |
tau_nc(1) = 0, 0571 |
tau_c(1) = -3, 1377 |
tau_ct(1) = -3, 2405 |
|
tкр для 5% уровня значимости |
tкр= -1, 95 |
tкр= -2, 89 |
tкр= -3, 45 |
|
P-значение |
0, 701 |
0, 0239 |
0, 0766 |
Результаты теста Дики-Фуллера на стационарность исследуемого временного ряда приведены в таблице 2. Примем нулевую гипотезу Н0 о том, что ряд не стационарен, при конкурирующей гипотезе Н1: ряд является стационарным.
Для теста без константы и теста с константой и трендом наблюдаемая тестовая статистика больше, чем критическое значение. Значит, в случае этих тестов нулевая гипотеза не отклоняется, т.е. исходный ряд не стационарен. Для теста с константой тестовая статистика лежит левее, чем критическое значение. Значит, в этом случае нулевая гипотеза отвергается, т.е. по результатам такой версии теста временной ряд исходных данных стационарен. Однако учитывая результаты для двух версий теста, необходимо проверить первую разность, для того чтобы найти порядок интеграции, который приведет исходный ряд данных к стационарному виду во всех вариациях теста.
Возьмем первую разность и проверим ее на стационарность. Результаты
приведены в таблице 3.
Таблица 3. Результаты теста Дики-Фуллера для первой разности индекса промышленного производства предприятий химической отрасли
|
|
Тест без константы |
Тест с константой |
Тест с константой и трендом |
|
Модель |
модель: (1-L)y = (a-1)*y(-1) + e |
модель: (1-L)y = b0 + (a-1)*y(-1) +... + e |
модель: (1-L)y = b0 + b1*t + (a-1)*y(-1) +... + e |
|
Тестовая статистика |
tau_nc(1) = -3, 7511 |
tau_c(1) = -3, 7258 |
tau_ct(1) = -3, 8789 |
|
tкр для 5% уровня значимости |
tкр= -1, 95 |
tкр= -3, 00 |
tкр= -3, 60 |
|
P-значение |
0, 00018 |
0, 0038 |
0, 0129 |
При взятии первой разности мы получили, что для всех версий теста Дики-Фуллера тестовая статистика находится левее критического значения. Также P-значение меньше, чем "=0, 05. Значит, нулевая гипотеза о нестационарности ряда отвергается. Следовательно, ряд первых разностей стационарен на уровне значимости 95%. Для временного ряда индекса промышленного производства химической отрасли порядок интеграции d=1.
Таким образом, после проведенного анализа мы пришли к тому, что параметры модели ARIMA p=1, d=1, q=2. Как известно, чем проще построенная модель, тем она удобнее для интерпретации и дальнейшего применения. Значит, мы будем подбирать модель, адекватно объясняющую исходные данные, и с наименьшим количеством параметров. Мы будем осуществлять выбор качества модели, основываясь на информационных критериях, кроме них, будем принимать в расчет статистические свойства модели.
Информационные критерии используются для сравнения качества моделей. Эти критерии не принято содержательно интерпретировать. Чем меньше значение данных критериев, тем выше относительное качество модели.
Одним из информационных критериев является критерий Акаике (AIC). Он имеет следующий вид:
AIC=2k-2l, (2.6)
где l - значение логарифмической функции правдоподобия построенной модели, k-количество использованных параметров.
Также среди информационных критериев существует
информационный критерий Шварца (BIC).
Он разработан на основе байесовского подхода. Этот критерий является самым
часто используемым преобразованием AIC:
BIC=k*ln(n)-2l (2.7).
При построении моделей временных рядов мы опирались, главным образом, на полученный порядок интеграции, который по результатам нашего анализа равен 1. Среди проанализированных моделей: ARIMA(1, 1, 3), ARIMA(2, 1, 3), ARIMA(3, 1, 2), ARIMA(3, 1, 2) - модель ARIMA(3, 1, 2) является наиболее точной.
|
|
Коэффициент |
Ст. ошибка |
|
|
0, 418* |
0, 706 |
|
|
−0, 504*** |
0, 123 |
|
|
−0, 899*** |
0, 088 |
|
|
−0, 233* |
0, 125 |
|
|
0, 384*** |
0, 048 |
|
|
1*** |
0, 071 |
|
Ст. ошибка модели, σ |
6, 563 |
|
|
Тест Льюинга-Бокса |
P-значение = 0, 843 |
|
|
Тест Харке-Бера |
|
|


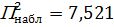
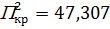
Значения рассчитанных параметров модели приведены в таблице 4. Результаты, рассчитанные по другим моделям, приведены в приложении 3.
Математическая форма модели ARIMA (3, 1, 2) имеет следующий вид:
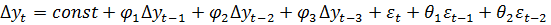 (2.8)
Для данной модели все значения параметров получились значимыми на уровне значимости 90%. Стандартная ошибка модели ARIMA(3, 1, 2) меньше, чем этот показатель в моделях ARIMA(1, 1, 3), ARIMA(2, 1, 3). Также выбранная модель обладает большим относительным качеством, т.к. ее информационные критерии: AIC=486, 270, BIC=502, 115 - меньше аналогичных показателей других моделей.
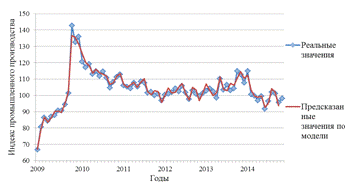
Значения анализируемого показателя - индекс промышленного производства
предприятий - рассчитаем с помощью модели и сравним предсказанные значения с
реальными данными (рис. 13).
Рисунок
13. Реальные и предсказанные значения индекса промышленного производства
предприятий химической отрасли, январь 2009 - декабрь 2014гг. (% к предыдущему
году)
Предсказанные по модели значения показателя и его реальные достигнутые уровни находятся довольно близко друг к другу. Безусловно, есть некоторые расхождения в значениях, но в целом модель хорошо описывает исходный временной ряд показателя. Например, показатель декабря 2014 года отличается от реального значения индекса на 4, 4п. п.: 93, % и 98, 1% соответственно. Ошибка предсказанных значений составляет 0, 0702.
Значения автокорреляционной и частной автокорреляционной функции для остатков данной модели не выходят за пределы доверительного интервала (рис.14), следовательно, остатки обладают свойствами белого шума. Значит, модель является адекватной.
Проверим выбранную модель на адекватность, используя тесты. Полученная
модель будет являться адекватной, если в ее остатках присутствует белый шум.
Нормальность распределения остатков проверим с помощью теста Харке-Бера. Для
выявления отсутствия или наличия автокорреляции остатков проведем тест
Льюинга-Бокса.
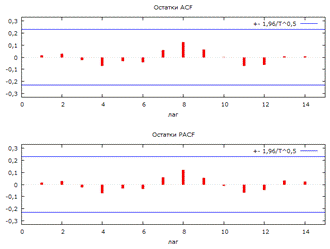
Рисунок
14. Автокорреляционная и частная автокорреляционная функции остатков модели
ARIMA (3, 1, 2).
В
тесте Харке-Бера в качестве нулевой гипотезы примем гипотезу о том, что остатки
распределены нормально. Тест Харке-Бера основан на сравнении коэффициентов
асимметрии и эксцесса исходного ряда с коэффициентами нормального
распределения. В данном критерии принимаются такие гипотезы: H0: S=0, K=3, H1: S≠0,
K≠3. В данной модели 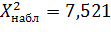 ,
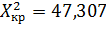 .
Наблюдаемое значение меньше критического, следовательно, нулевая гипотеза о
нормальности распределения остатков не отвергается, остатки распределены
нормально.