Дипломная (вкр): Статистическое исследование химической отрасли Российской Федерации
Рисунок
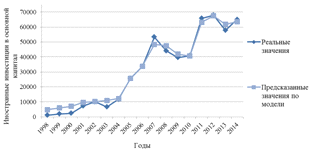
18. Реальные и предсказанные значения иностранных инвестиций в основной капитал
предприятий химической отрасли, 1998 - 2014гг.(млн. руб.)
Модель успешно описывает исходный временной ряд, поскольку предсказанные по модели значения показателя и его реальные достигнутые уровни находятся довольно близко друг к другу, несмотря на некоторые расхождения в значениях.
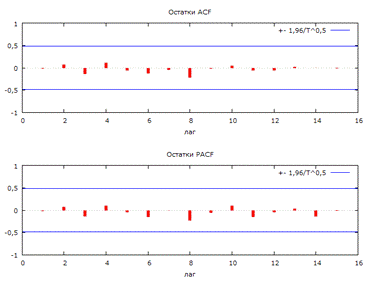
Значения автокорреляционной и частной автокорреляционной функции для остатков данной модели находятся в пределах доверительного интервала (рис.19), следовательно, остатки обладают свойствами белого шума. Модель является адекватной.
Подтвердим этот вывод, используя тесты. Нормальность распределения остатков проверим с помощью теста Харке-Бера. Для выявления отсутствия или наличия автокорреляции остатков проведем тест Льюинга-Бокса.
В
тесте Харке-Бера в качестве нулевой гипотезы примем гипотезу о том, что остатки
распределены нормально H0: S=0, K=3, при альтернативной гипотезе H1: S≠0,
K≠3. В данной модели 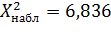 ,
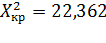 .
Наблюдаемое значение меньше критического, значит, нулевая гипотеза о не
отвергается, следовательно, остатки распределены нормально.
Рисунок
19. График автокорреляционной и частной автокорреляционной функций остатков
модели ARIMA (2, 1, 1)
С
помощью теста Льюинга-Бокса определим, наличие белого шума в остатках данного
временного ряда. Примем гипотезу Н0: остатки являются случайными, при
конкурирующей гипотезе Н1: данные не являются белым шумом. После проведения
теста на автокорреляцию получим: 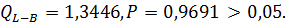 Следовательно,
нулевая гипотеза Н0 не отклоняется, остатки модели ARIMA(2, 1, 1) обладают
свойствами белого шума на уровне значимости 95%, автокорреляции в них нет.
Значит, можем сделать вывод о том, что модель адекватна.
Остатки построенной модели ARIMA(2, 1, 1) распределены нормально, автокорреляции в них нет, т.е. модель является адекватной, значит, можем использовать данную модель для построения прогноза.
Построим
прогноз объема инвестиционных поступлений в основной капитал предприятий
химической отрасли на 3 года, используя описанную модель. По полученным
результатам модельных значений показателя можно говорить об ожидаемом
увеличении объема инвестиций в основной капитал (табл. 9).
Таблица 9. Прогнозные значения и доверительный интервал объема иностранных инвестиций в основной капитал химической отрасли России, 2015-2020гг.
|
Набл. |
Прогнозное значение, млн. руб. |
Ст. ошибка |
95% доверительный интервал |
|
2015 |
75999, 2 |
2, 456 |
(63345, 5, 88652, 8) |
|
2016 |
82165, 4 |
3, 004 |
(68438, 3, 95892, 5) |
|
2017 |
84674, 8 |
3, 251 |
(70464, 0, 98885, 6) |
В 2015 году объем иностранных инвестиций в основной капитал возрастет по сравнению с 2014 годом на 10912, 5 млн. рублей, составив 75999, 2 млн. рублей. Темп прироста показателя будет равен 16, 77 п. п. В дальнейшие годы изменение объема инвестиционных поступлений будет происходить более медленными темпами, не превышающими 10 п. п. (рис. 20). К 2016 году анализируемый индикатор достигнет уровня в 82165, 4 млн. рублей, показав положительный темп прироста в 8, 11 п. п.
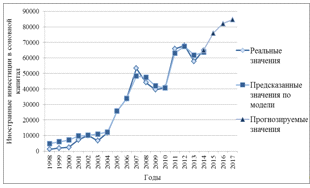
Рисунок
20. Прогнозные значения объема иностранных поступлений в основной капитал
предприятий химической отрасли, 2015- 2017гг. (млн. руб.)
Выбранная модель является адекватной, что было подтверждено результатами тестов, поэтому полученный по ней прогноз может считаться достоверным.
Спрогнозированный показатель на 2017 год очень высок, и достижение этого уровня непременно благотворно сказалось бы на предприятиях химической отрасли.
Такой уровень инвестирования из иностранных источников позволил бы
усовершенствовать методы производства. Это помогло бы повысить
конкурентоспособность российских производителей и занять большую долю рынка и в
России, и за рубежом. Однако с учетом непростой экономической ситуации в
стране, ухода некоторых инвесторов с рынка, остается надеяться на лучшее и
стремиться к достижению близких к спрогнозированным результатов.
Глава 3. Анализ деятельности предприятий химической отрасли Российской Федерации
.1 Исследование дифференциации предприятий химической отрасли
На сегодняшний день в химической отрасли функционирует немало предприятий. В данной работе мы рассмотрим наиболее крупные предприятия этого сектора обрабатывающей промышленности. В нашу выборку вошло 50 крупных предприятий, информация по которым наиболее полная и находится в открытом доступе. Из отчетности компаний была получена информация по показателям, характеризующим объем имеющихся активов, обязательств, а также уровень выручки, прибыли, амортизации. На основе этих показатели были рассчитаны рентабельность активов (Х1), рентабельность продаж (Х2), доля основных средств (Х3), оценены размер компаний (X4), не долговой налоговый щит (X5).
Значения этих переменных подчиняются нормальному закону распределения, об этом свидетельствуют результаты теста Колмогорова-Смирнова. Для всех переменных двусторонняя асимптотическая значимость статистики превышает значение "=0, 05. Следовательно, гипотеза Н0 о том, что данные распределены равномерно не отвергается на уровне значимости 95%.
При анализе аномальных наблюдений в совокупности предприятий было выявлено, что у четырех компаний уровень не долгового налогового щита является чересчур высоким. Для того чтобы избежать исключения этих предприятий из анализа и не уменьшать и без того небольшой объем выборки предприятий химического сектора, было принято решение заменить аномальные уровни показателя на его средние значения. После этого выбросов в совокупности не наблюдалось.
При построении дендрограмм различными способами, например, методом межгрупповых связей, методом внутригрупповых связей, методом ближайшего соседа, методом дальнего соседа, методом Варда и др., - были выявлены немного отличающиеся разбиения совокупности компаний на кластеры, поскольку каждый из методов кластеризации данных имеет свои особенности при построении. При большинстве рассмотренных методов было выявлено разбиение совокупности предприятий на 3 кластера.
С
помощью метода k-средних можно представить средние значения каждого
кластера графически, а также рассмотреть состав кластеров наиболее наглядным и
удобным образом. Однако для рационального применения метода к-средних
необходимо нормировать данные. Нормировку произведем по формуле:  =
 , где
 - это
исходное значение признака;
 - это
среднее значение нормируемого показателя; - это
нормированное значение показателя.
Из
результатов дисперсионного анализа можно сделать вывод, что на уровне
значимости 95% значимы все признаки, кроме признака Х5 (табл.10).
Следовательно, нулевая гипотеза о равенстве средних по группам не может быть
отклонена по этой переменной. Рассмотрим дальнейший анализ разбиения наблюдений
на кластеры без учета этого признака.
Таблица 10. Результаты дисперсионного анализа полученных кластеров
|
ANOVA |
||||||
|
|
Кластер |
Ошибка |
F |
Знч. |
||
|
|
Средний квадрат |
ст.св. |
Средний квадрат |
ст.св. |
|
|
|
Х1 |
9, 473 |
2 |
0, 661 |
47 |
14, 338 |
0, 000 |
|
X2 |
9, 154 |
2 |
0, 674 |
47 |
13, 575 |
0, 000 |
|
X3 |
18, 032 |
2 |
0, 297 |
47 |
60, 816 |
0, 000 |
|
Х4 |
15, 228 |
2 |
0, 416 |
47 |
36, 623 |
0, 000 |
|
Х5 |
0, 005 |
2 |
0, 003 |
47 |
1, 720 |
0, 190 |
При пересчете значений дисперсионного анализа без учета признака Х5 были
получены следующие результаты (табл. 11). Из анализа полученных результатов
следует, что все рассматриваемые признаки являются значимыми на уровне ошибки
5%. Следовательно, можно перейти к анализу полученных конечных центров
кластеров (табл. 12).
Таблица 11. Результаты дисперсионного анализа полученных кластеров без учета признака Х5
|
ANOVA |
||||||
|
|
Кластер |
Ошибка |
F |
Знч. |
||
|
|
Средний квадрат |
ст.св. |
Средний квадрат |
ст.св. |
|
|
|
Х1 |
9, 473 |
2 |
0, 661 |
47 |
14, 338 |
0, 000 |
|
Х2 |
9, 154 |
2 |
0, 674 |
47 |
13, 575 |
0, 000 |
|
Х3 |
18, 032 |
2 |
0, 297 |
47 |
60, 816 |
0, 000 |
|
Х4 |
15, 228 |
2 |
0, 416 |
47 |
36, 623 |
0, 000 |
При рассмотрении значений конечных центров кластеров заметим, что нулевая
гипотеза о равенстве средних значений кластеров отвергается в трех группах,
исходя из рассчитанных значений конечных центров кластеров (табл. 12). Конечные
центры полученных при анализе кластеров отличаются друг от друга.
Таблица 12. Значения конечных центров кластеров без учета признака Х5
|
|
Кластер |
||
|
|
1 |
2 |
3 |
|
Х1 |
0, 3836 |
0, 2315 |
-1, 1525 |
|
Х2 |
0, 1192 |
0, 5956 |
-1, 0722 |
|
Х3 |
0, 6167 |
-1, 2918 |
0, 4162 |
|
Х4 |
0, 8010 |
-0, 5853 |
-0, 9496 |
Анализ средних значений переменных для каждого кластера позволяет сделать вывод о том, что по признаку Х1, рентабельность активов, кластер 1 имеет наибольшее значение, а кластер 3 - наименьшее. Значения первого и второго кластеров находятся ближе друг к другу, а значения третьего кластера находится дальше от них. По признаку Х2, рентабельность продаж, наибольшее среднее значение находится во втором кластере, наименьшее - в третьем.
По признаку Х3, доля внеоборотных активов, наибольший уровень показателя наблюдается в первом кластере, наименьший - во втором. Среднее значения показателя достигается в группе 3 и находится ближе к характеристике первого кластера, чем второго. По признаку Х4, размер предприятий, аналогично наибольшее среднее значение находится в первом кластере. Наименьшее значение конечного центра кластера по признаку Х4 также принадлежит третьему кластеру.
Расстояния между кластерами (табл. 13) свидетельствуют о том, что первый
и второй кластеры находятся друг к другу ближе всего, расстояние между ними
равно 2, 411. Наблюдения первого и третьего кластеров имеют большее количество
различий, расстояние между центрами этих кластеров равно 2, 624. Второй и
третий кластеры являются наиболее далеко отстоящими друг от друга - расстояние
между центрами этих кластеров равняется 2, 783.
Таблица 13. Расстояния между конечными центрами кластеров
|
Кластер |
1 |
2 |
3 |
|
2, 411 |
2, 624 |
|
2 |
2, 411 |
|
2, 783 |
|||
|
3 |
2, 624 |
2, 783 |
|
Из приведенного графика групповых средних (рис. 21) видим, что центры кластеров отличаются друг от друга. Наблюдается существенное различие у объектов, принадлежащих к каждому из кластеров, по уровню значений признаков X1, X2, Х3, X4. Каждому кластеру можно дать название, помимо его номера, в соответствие с преобладающим в нем признаком.
Например, в первом кластере наибольшее значение принадлежит признаку X4, назовем первый кластер «X4*», в нем собраны предприятия самые
большие по своему размеру, по объему продаж. Аналогичным образом присвоим
названия второму и третьему кластеру.
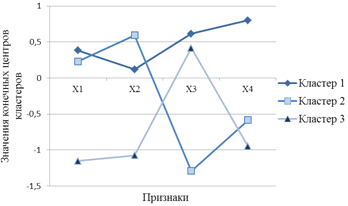
Рисунок
21. Значения конечных центров кластеров для признаков X1, X2,
Х3, X4
Получим, что вторую группу можно назвать «X2*», поскольку Х2 является преобладающим признаком в этом кластере. А в третьем кластере преобладающее значение имеет фактор Х3, поэтому назовем кластер 3 «Х3**». Получаем, что для предприятий второй группы характерен самый большой уровень рентабельности продаж. Компании третьего кластера объединены высокой долей внеоборотных средств в составе своих активов.
Таким образом, такие признаки, как рентабельность активов, рентабельность продаж, доля внеоборотных активов и размер предприятий играют наиболее значимую роль в разбиении на группы предприятий химической отрасли.
Наблюдения распределены довольно равномерно по кластерам (табл. 14). 24 предприятия составляют первый кластер, на долю этой группы приходится 48% от всей совокупности. 15 компаний находятся во втором кластере, 11 - в третьем. Вторая и третья группы составляют 30% и 22% соответственно от общего количества предприятий, включенных в анализ.