Материал: Строительство высотных зданий. оценка эффективности проектов в условиях рисков. Околелова Э.Ю., Трухина Н.И
Наиболее распространенный способ группировки объектов по ряду признаков – кластерный анализ. Параметром кластеризации в данном случае является цена риска. Диапазон изменения цены риска – [22,5; 0,5]. Определим три основные группы рисков.
Данные таблицы 2.4 располагаем в порядке возрастания цены риска и формируем кластерные группы (табл. 2.5).
Таблица 2.5
Формирование кластеров по цене риска.
Код |
Вероятность возникновения |
Максимальный ущерб, % от стоимости строительства |
Цена риска, % от стоимости строительства |
233 |
0,1 |
5 |
0,5 |
211 |
0,15 |
10 |
1,5 |
212 |
0,15 |
10 |
1,5 |
Окончание таблицы 2.5 |
|||
Код |
Вероятность возникновения |
Максимальный ущерб, % от стоимости строительства |
Цена риска, % от стоимости строительства |
213 |
0,2 |
10 |
2 |
232 |
0,2 |
10 |
2 |
231 |
0,2 |
15 |
3 |
602 |
0,4 |
10 |
4 |
403 |
0,3 |
20 |
6 |
302 |
0,3 |
25 |
7,5 |
103 |
0,1 |
80 |
8 |
101 |
0,1 |
90 |
9 |
102 |
0,1 |
90 |
9 |
303 |
0,6 |
15 |
9 |
221 |
0,5 |
20 |
10 |
301 |
0,5 |
20 |
10 |
222 |
0,4 |
30 |
12 |
402 |
0,5 |
25 |
12,5 |
503 |
0,3 |
50 |
15 |
304 |
0,8 |
20 |
16 |
401 |
0,7 |
25 |
17,5 |
501 |
0,3 |
60 |
18 |
502 |
0,3 |
60 |
18 |
601 |
0,75 |
30 |
22,5 |
Предлагается сформировать три основные группы рисков и ввести новую групповую классификацию с точки зрения качественного и количественного анализа (табл. 2.6).
Таблица 2.6
Кластеры рисков
Кластер рисков |
Характеристика |
Диапазон цены риска |
Консервативные риски |
Риски, имеющие низкую вероятность возникновения и влекущие незначительный ущерб (1) |
[0,5; 7,5] |
Умеренные риски |
Риски, имеющие либо средний показатель вероятности наступления, либо среднюю величину ущерба (2) |
[8; 15] |
Окнчание таблицы 2.6 |
||
Кластер рисков |
Характеристика |
Диапазон цены риска |
Агрессивные риски |
Риски с высокой вероятностью наступления и незначительным ущербом или риски с низкой вероятностью наступления, но высокой величиной ущерба (3) |
[16; 22,5] |
Примечание: на рис. 2.3. кластеры рисков выделены следующими цветами:
( 1)
- - консервативные риски
( 2)
- - умеренные риски
( 3)
- - агрессивные риски
На основании данных табл. 2.5 и 2.6 построена матрица рисков, которая показывает риски, несущие наибольшую угрозу проекту (рис.2.3).
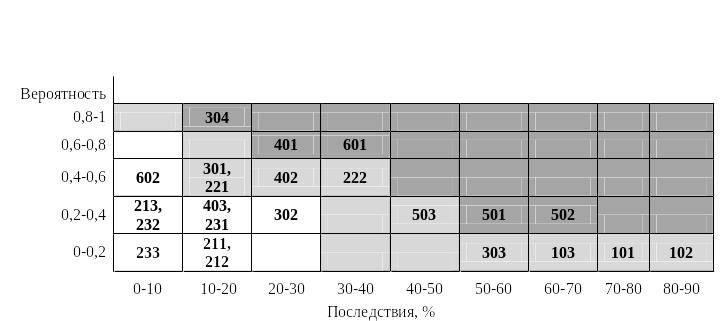
Рис. 2.3. Матрица рисков
Выявлены риски, которые имеют высокую вероятность наступления и при этом несут значительный ущерб проекту. Задача состоит в определении каждого вида риска и степени его влияния на инвестиционный процесс независимо от природы возникновения риска. Высотное строительство – относительно новое направление, поэтому всесторонний анализ перспектив, проблем, возможностей и угроз является одним из наиболее значимых вопросов исследования.
Все виды возможных рисков сгруппированы в кластеры по отдельным характерным признакам. Задача состоит в определении влияния каждой группы риска на развитие нового для данной страны направления - строительства зданий повышенной этажности.
2.4. Моделирование факторного пространства рисков и оценка воздействия
Следующий этап – определение влияния рисков на реализацию проекта строительства высотного здания. Иными словами, необходимо определить, какова величина наиболее вероятного ущерба, который будет иметь инвестор при строительстве объектов повышенной этажности, в случае наступления неблагоприятных ситуаций. Это могут быть и техногенные катастрофы, и неблагоприятные климатические условия, и инфляция, и политические протесты общества и множество других факторов, которые в конечном итоге могут существенно повлиять на доходность проекта.
Кластеры сформированы таким образом, что в кластер попадают риски независимо от природы возникновения, но приблизительно одинаковые по количественным характеристикам. Таким образом, выделены три основных кластера, которым даны новые групповые определения.
Необходимо оценить влияние каждой кластера на результат реализации проекта. Использован метод определения кластерного расстояния [98].
Для определения близости пары точек в многомерном пространстве используется евклидово расстояние
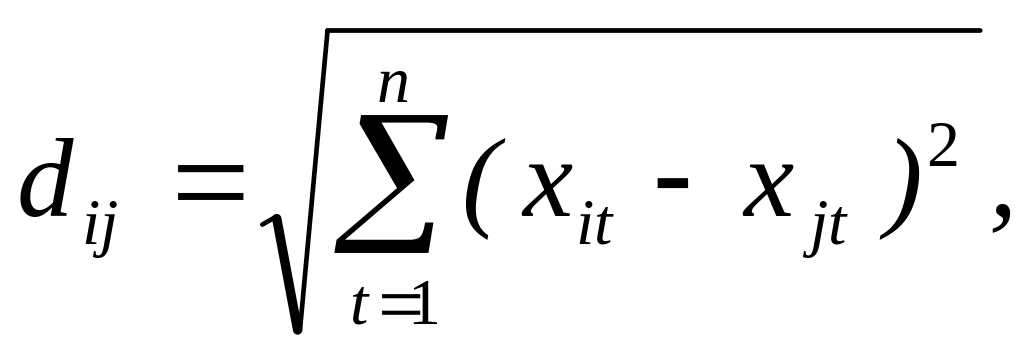 I,j
= 1, …, n.
(2.10)
где dij - евклидово расстояние между i-м и j-м объектами; xit, - значение i-то показателя для i-го объекта.
На основании полученных значений цены риска вычислим расстояние между каждой парой объектов по формуле (2.9), получим квадратную матрицу D, имеющую размеры nxn (по числу объектов); эта матрица симметрична, т.е. dij = dij (i,j=1,…,n).
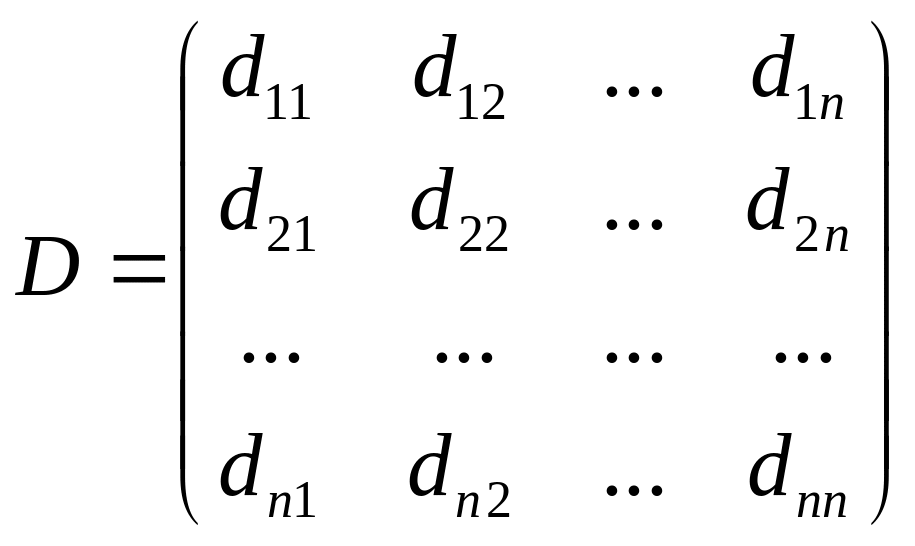 (2.11)
Матрица расстояний D служит основой при реализации методов кластерного анализа, в том числе и агломеративно-иерархического метода, который часто используется для многомерной классификации объектов в социально-экономических исследованиях. Основная идея этого метода заключается в последовательном объединении группируемых объектов - сначала самых близких, затем более удаленных друг от друга. Процедура построения классификации состоит из последовательности шагов, на каждом из которых производится объединение двух ближайших групп объектов (кластеров).
В результате формализуется кластер рисков, наиболее активно влияющих на прогноз доходности проекта. Все виды возможных рисков сгруппированы в кластеры по отдельным характерным признакам. Характер распределения объектов внутри каждой группы предполагает построение многомерной классификации на основе методов кластерного анализа. Такой подход позволяет идентифицировать группу рисков, наиболее существенно влияющих на прогноз развития проекта, и позволяет своевременно проработать механизм нейтрализации рисков и мер по снижению его воздействия.
Существуют различные способы определения расстояния между группами объектов (различающие методы кластерного анализа). Обычно близость двух кластеров определяется как средний квадрат расстояния между всеми такими парами объектов, где один объект пары принадлежит к одному кластеру, а другой - к другому:
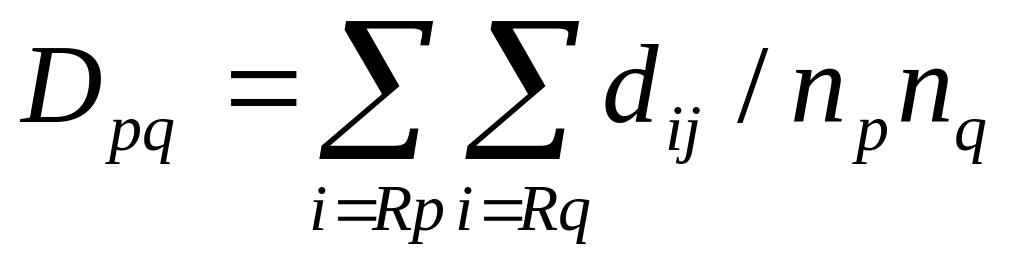 (2.12)
где Dpq - мера близости между р-м и q-м кластерами; Rp - р-й кластер; Rq - q-й кластер; nq- число объектов в p-м кластере; nq- число объектов в q -м кластере.
На первом шаге процедуры агломеративно-иерархического метода кластерного анализа рассматривается начальная матрица расстояний между объектами и по ней определяется минимальное число di1j1; далее, наиболее близкие объекты с номерами i1 и j1 объединяются в один кластер, в матрице вычеркиваются строки и столбец с номером j1 , а расстояния от нового кластера (он получает номер i1 ) до всех остальных кластеров (на первом шаге - объектов) вычисляются по формуле (2.11); в данном случае квадраты таких расстояний равны полусуммам квадратов расстояний от i1-го и j1-го объектов до каждого из остальных. Эти вновь вычисленные значения расстояний заносятся в i1-ю строку и i1-й столбец матрицы D.
На втором шаге процедуры по матрице D, содержащей уже n-1 строк и столбцов, определяют минимальное число di2j2 и формируют новый кластер с номером i2. Этот кластер может быть построен в результате объединения либо двух объектов, либо одного объекта с i1 -м кластером, построенным на первом шаге. Далее, в матрице D вычеркиваются строка столбец с номером j2, а строка и столбец с номером i2 перечитываются, и т.д.
Таким
образом, метод кластерного анализа
включает п-1
аналогичных шагов. При этом после
выполнения k-го
шага (k
 n-1)
число кластеров равно n-k
(некоторые из них могут быть отдельными
объектами), а матрица D имеет размеры
(n-k)x
(n-k).В
конце этой процедуры, на (n-1)-м
шагe, получится кластер, объединяющий
все n
объектов.
Результаты классификации, построенной изложенным методом, можно изобразить в виде дерева иерархической структуры (дендрограммы), содержащего n уровней, каждый из которых соответствует одному из шагов описанного процесса последовательного укрупнения кластеров.
В кластерном анализе существенным является выбор необходимого числа кластеров. В некоторых случаях число кластеров может быть выбрано из априорных соображений, однако чаще это число определяется в процессе формирования кластеров на основе значений некоторых показателей их однородности и степени удаленности друг от друга (например, показателей внутригрупповой дисперсии или вариации).
Таким образом, алгоритм решения предполагает несколько этапов. Первый этап – идентификация рисков по качественным и количественным признакам на основе кластерного анализа, что позволит группировать риски не только по источникам их возникновения, но и по вероятности возникновения и величине ущерба.
Необходимо выделить риски по степени значимости, которая предполагает максимально возможный ущерб при реализации инвестиционного проекта. Риски характеризуются вероятностью наступления и ценой риска.
Вторым этапом оценки кластеров риска предлагается измерение весового фактора или влияния их на результат реализации проекта. При анализе рисков и величине возможного ущерба от его наступления невозможно оперировать детерминированными величинами. Для более точных оценок воспользуемся задачей в стохастической постановке.
Так как случайные величины могут определяться как реализациями, так и их количественными характеристиками и законами их распределения, то на этапе планирования, как правило, неизвестны, и поэтому пользуются только характеристиками случайных величин и законами их распределения. Кроме того, говоря о рисках, необходимо учесть возможность различных временных интервалов их наступления.
Задача стохастического программирования может быть сформулирована в M- или P-постановках.
При M-постановке целевая функция, означающая максимизацию (минимизацию) математического ожидания, записывается в виде:
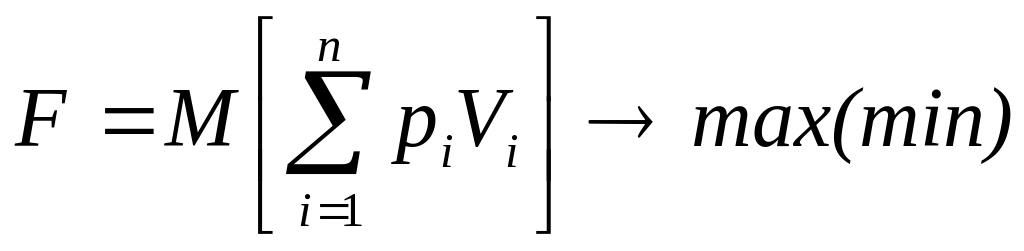 .
(2.13)
Если
от математического ожидания целевой
функции перейти к математическим
ожиданиям случайных величин
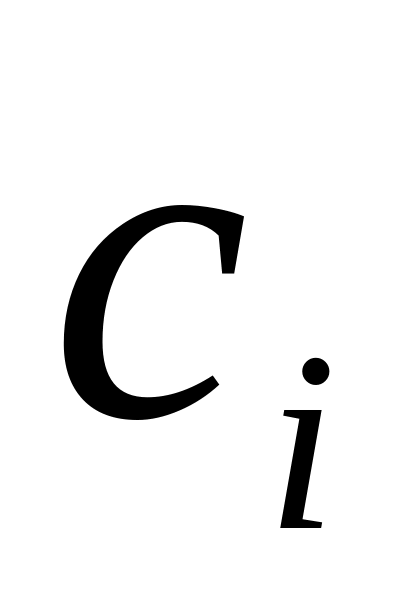 ,
то получим:
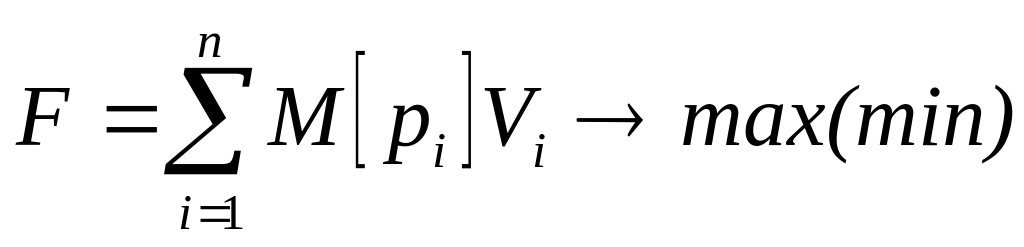 .
(2.14)
Таким
образом, при M-постановке
задачи стохастического программирования
для ее решения требуется найти такие
значения искомых переменных
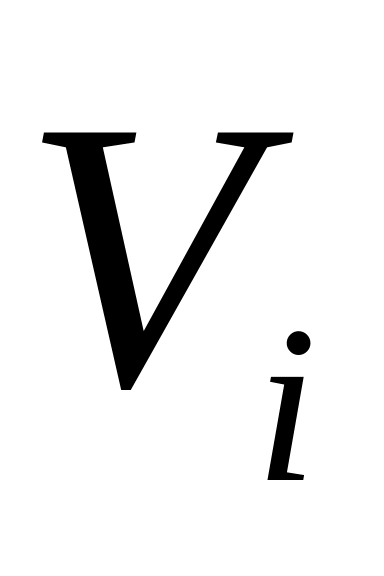 ,
при которых математическое ожидание
целевой функции имеет оптимальное
(минимальное, максимальное) значение.
При
P-постановке
задача стохастического программирования
формулируется несколько иначе. Прежде
всего, должно быть задано предельно
допустимое наихудшее значение целевой
функции. При максимизации задается
минимально допустимое значение
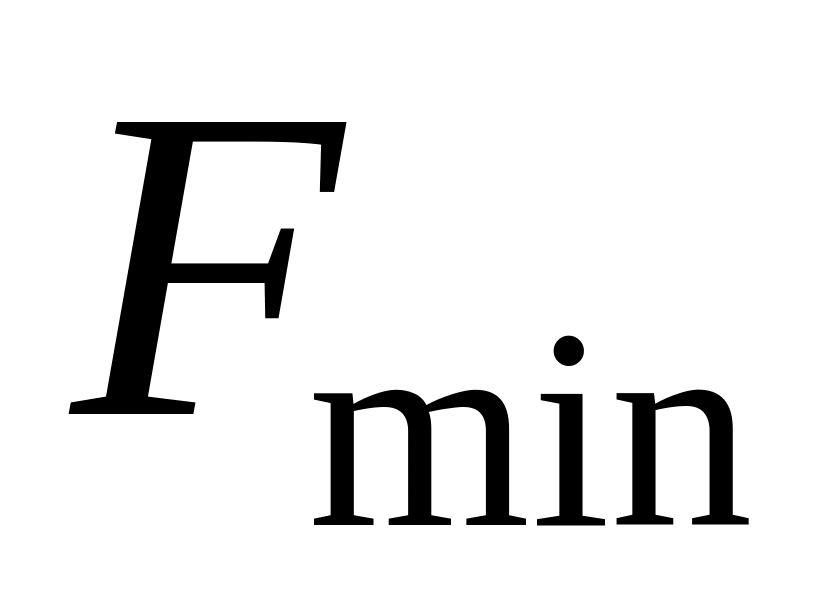 и требуется выполнение условия
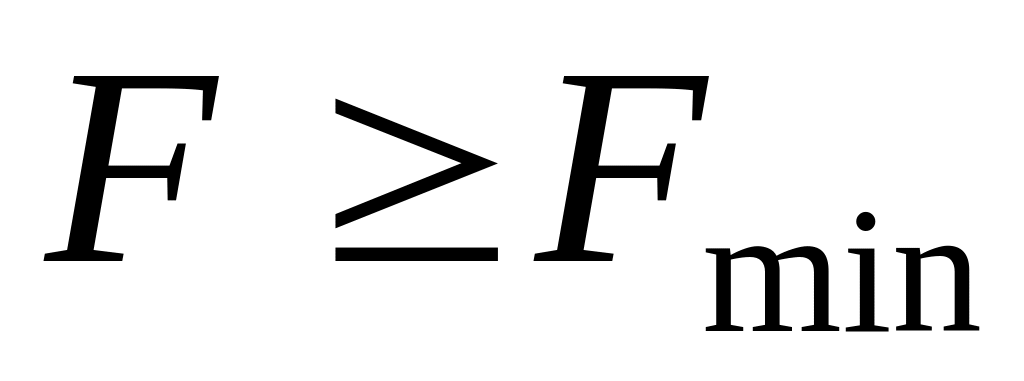 .
При минимизации задается максимально
допустимое значение
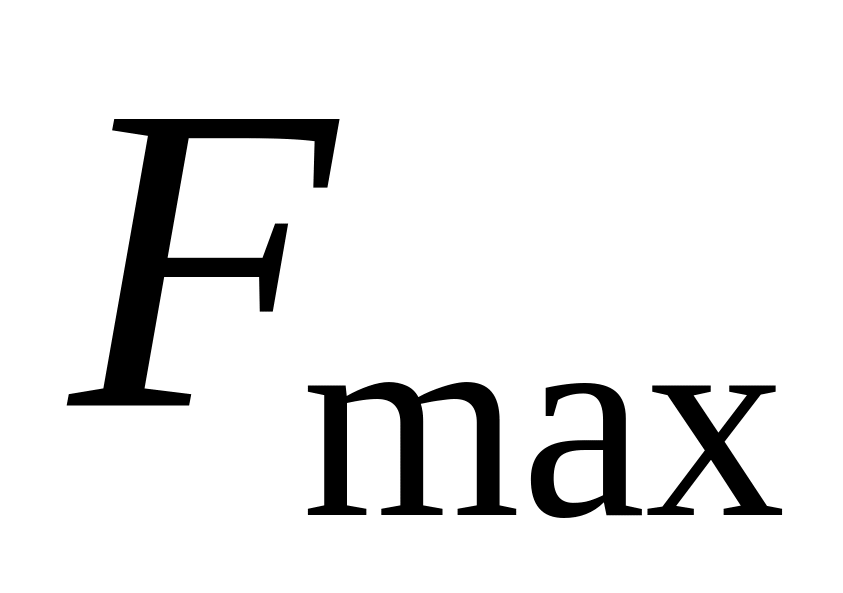 и требуется выполнение условия
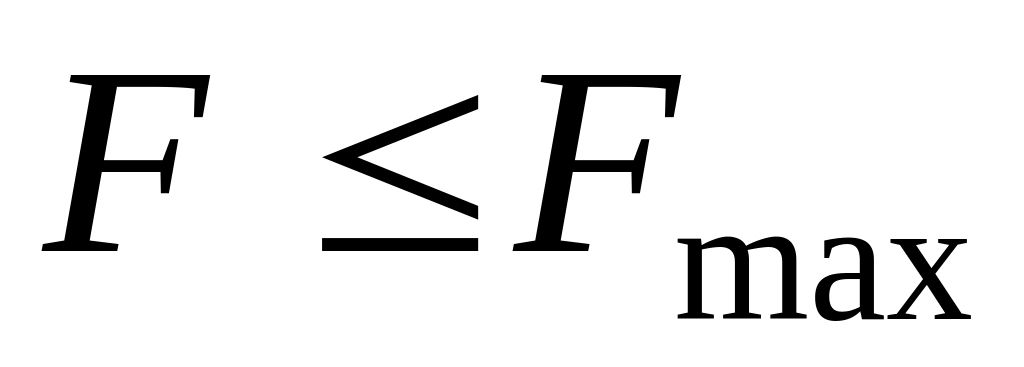 .
Суть P-постановки заключается в том, что необходимо найти такие значения , при которых максимизируется вероятность того, целевая функция будет не хуже предельно допустимого значения.
Целевая функция при P-постановке задачи стохастического программирования имеет вид:
а) при максимизации
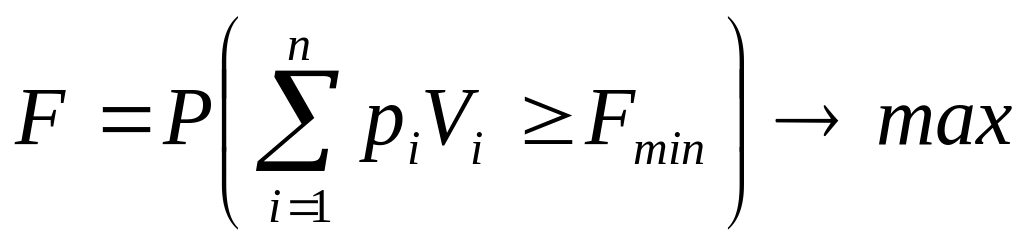 ;
(2.15)
б) при минимизации
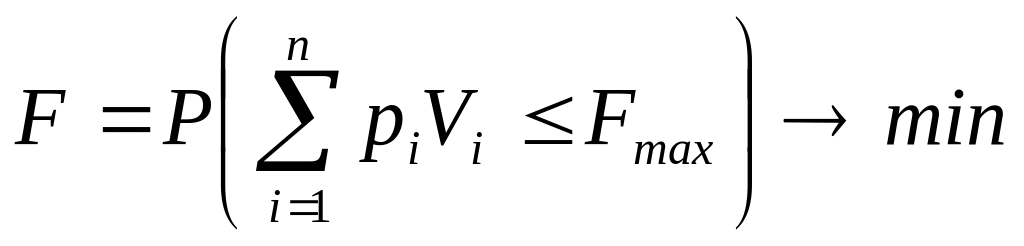 .
(2.16)
Следует отметить, что в обоих случаях, как при минимизации, так и при максимизации, целевой функции следует стремиться к максимизации вероятности.
Пусть задана некоторая конкретная область возможных значений вариации величины возможных потерь Vi, значения которых есть случайные величины, принадлежащие интервалу [0; Vmax], где значение Vmax определяется для каждого вида риска. Заданную область обозначим через . При этом необходимо выполнение условия:
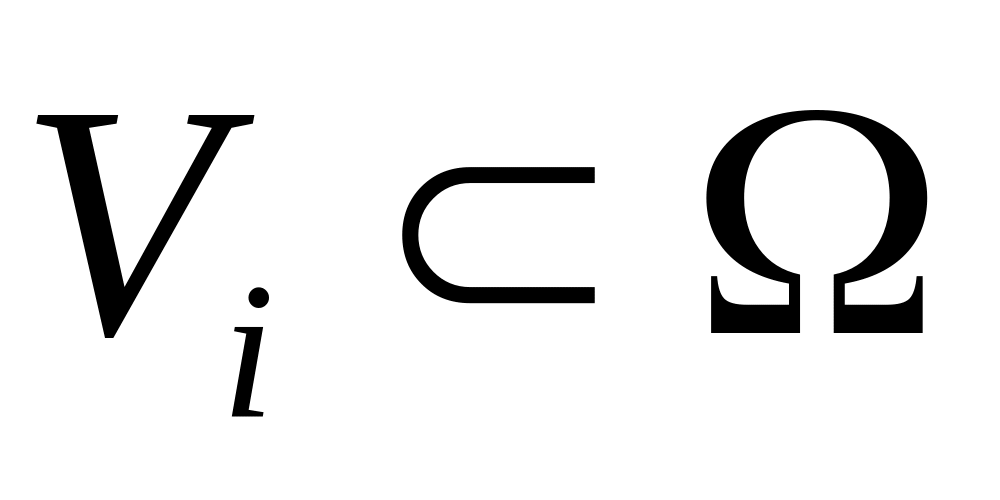 ,
(2.17)
где - значение i-той величины возможных потерь.
Возникает вопрос: какова вероятность наступления события A с числовым значением ? В данном случае воспользуемся понятием геометрической вероятности и вычислим ее с помощью меры Лебега [2]. Условно разобьем на n частей одинаковой меры Лебега. Пусть событие A таково, что оно целиком состоит из множества k таких частей. Тогда эксперимент случайного выбора точки из множества может быть описан с помощью классической схемы. Всего n равновозможных исходов. При этом вероятность события A равна отношению числа частей, составляющих A, к общему числу частей. Символом mes обозначим меру Лебега [2]: