Магистерская работа: История французской языковой политики
Эта таблица также позволяет перейти к конкретным примерам совместной встречаемости двух взятых слов в корпусе текстов. Программа также способна отображать гистограммы с процентными соотношениями частоты совместного употребления слов.
Для вывода данных карт или таблиц вычисляется индекс ассоциации (index
d'association). Индекс ассоциации (или схожести) используется для анализа
совместной встречаемости лексических единиц (ЛЕ) внутри элементарных контекстов
(ЭК). Программа T-Lab включает три типа индекса ассоциаций, чьи формулы
выглядят следующим образом (рис. 4), где a - количество ЭК, в которых
присутствуют обе рассматриваемые ЛЕ, b - количество ЭК, в которых присутствует
ЛЕ-1, но отсутствует ЛЕ-2, а с - количество ЭК, в которых присутствует ЛЕ-2, но
отсутствует ЛЕ-1.
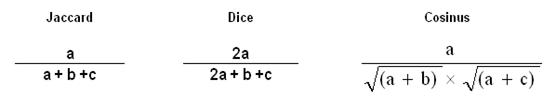
Рисунок
4. Формулы индексов ассоциации, используемых программой T-Lab
В нашем исследовании мы ориентировались на индекс Cosinus, именно этот индекс ассоциации представлен на приводимых в исследовательской части графиках и в таблицах.
Процедура определения совместно встречаемых слов состоит из двух этапов. Вычисления первого порядка затрагивают синтагматическую ось, то есть определяют слова, находящиеся в отношениях комбинации и близости. Это слова, линейно находящиеся рядом друг с другом в рамках данного предложения. В то же время коэффициенты второго порядка работают с парадигматической осью (ассоциации и схожесть in absentia, то есть отношения квази-синонимии между двумя или более терминами, употребляемыми одним автором в схожих окружениях).
Таким образом, данные инструменты анализа совместной встречаемости позволяют по-новому взглянуть на лингвистический анализ текста и применить к нему новые методы с разными целями. В нашей работе анализ визуальных карт ассоциаций слов позволит определить, как меняется со временем окружение ключевых понятий (таких как французский язык, английский язык и др.) в единообразных документах - докладах Национальному собранию Франции на протяжении девятнадцати лет. Визуально отображенные изменения помогут определить разницу тематик и контекстов, в которых идёт речь о данных ключевых понятиях, а также, отношение автора к данным ключевым словам. Данные методы исследования позволяют делать выводы, основанные не на субъективном впечатлении, полученном от личного чтения документа, а на объективных математических вычислениях.
Однако в ходе исследования мы столкнулись с тем, что полученных в
программе T-Lab данных оказалось недостаточно для того, чтобы выявить тенденции
изменения языковой политики на объёмном массиве изучаемых нами текстов. Это
понудило нас прибегнуть к методам математической статистики.
2.2 Математическая статистика. Коэффициент ранговой корреляции Спирмена
Математику часто используют как инструмент в целом ряде наук, как технических, так и естественно-научных и гуманитарных. Благодаря таким методам, предмет исследования может быть не только описан, но и объективно измерен, то есть используется количественный анализ. Всем этим занимается математическая статистика, позволяющая разбираться в сложном экспериментальном материале, обобщать данные экспериментов, находить зависимости между экспериментальными данными и многое другое. Также методы математической статистики помогают избегать логических и содержательных ошибок, вероятность появления которых велика при традиционных методах исследования.
Содержанием математической статистики является разработка приемов статистического наблюдения и анализа статистических данных, а ее основной задачей - выяснение вероятностных свойств генеральной совокупности (распределение, числовые характеристики и т. п.), но, как правило, исследовать такую совокупность целиком практически невозможно, и поэтому производится выборка, то есть изучению подвергаются лишь некоторые объекты совокупности. Математическая статистика использует те же методы и приемы, что теория вероятностей.
Одним из таких понятий является корреляция, определяемая как «статистическая зависимость между случайными величинами, не имеющими строгого функционального характера, при которой изменение одной из случайных величин приводит к изменению математического ожидания другой».
Понятие корреляции было введено в XIX веке в работах английского антрополога и психолога Фрэнсиса Гальтона и математика Карла Пирсона.
Рассматриваемые величины могут быть независимыми или связанными функциональной или вероятностной (стохастической) зависимостью. Основной задачей корреляционного анализа является выявление тесноты связи между этими величинами, а также количественная оценка тесноты этой связи.
Корреляционная связь показывает лишь тенденцию изменения одной величины под действием другой, а значит, на ее основании мы можем утверждать о степени связи между переменными.
Корреляционная связь различается по силе (тесноте) связи: связь может быть функциональной, тесной (сильной), средней (умеренной), слабой и нулевой (отсутствующей). Также она различается по направлению: бывает положительной и отрицательной.
Оценка тесноты корреляции производится с помощью различных корреляции. Коэффициент корреляции (ρ) - это безразмерная величина, изменяющаяся в пределах от -1 до 1. При ρ=±1 корреляционная связь представляет собой линейнуюфункциональную зависимость.
«Прямая», положительная связь наблюдается, когда ρ > 0; отрицательная связь - при ρ < 0.
Приведём таблицу оценки корреляционной связи в зависимости от величины
коэффицента корреляции:
Таблица 2. Оценка тесноты корреляционной связи в зависимости от значения коэффициента корреляции
|
Значение коэффициента корреляции |
Оценка тесноты корреляционной связи |
|
| ρ | = 1 |
величины связаны линейной функциональной зависимостью |
|
0,95 ≤ | ρ | < 1 |
связь очень сильная, практически функциональная |
|
0,75 ≤ | ρ | < 0,95 |
связь тесная (сильная) |
|
0,5 ≤ | ρ | < 0,75 |
связь средняя (умеренная) |
|
0,2 ≤ | ρ | < 0,5 |
связь слабая |
|
0 ≤ | ρ | < 0,2 |
практически нет связи |
Приведённую классификацию значений коэффицента корреляции следует считать информативной и приблизительной.
Однако М. А. Харченко отмечает, что если коэффицент корреляции равен нулю, это ещё не означает независимость случайных величин, а только указывает на отсутствие линейной корреляционной зависимости между данными величинами, но не отсутствие корреляционной зависимости вообще
Существует несколько способов вычисления коэффициентов корреляции, однако они не универсальны. В случаях, когда нужно проанализировать переменные, которые нельзя измерить в интервальной или реляционной шкалах, но которые, тем не менее, можно проранжировать по возрастанию или убыванию признака, прибегают к ранговой корреляции. Как отмечает О. Ю. Ермолаев, в таком случае не требуется никаких предположений о характере распределений признаков в генеральной совокупности. Таким образом, это непараметрический метод.
Коэффициент ранговой корреляции определяет связь тесноты между признаками, выраженными рангами. Одной из разновидностей коэффицентов ранговой корреляции является коэффицент ранговой корреляции Спирмена. Его величина также лежит в интервале от -1 до +1, и в целом его значения поддаются тем же принципам интерпретации, как описано выше для неранговой корреляции.
Рассчитывается коэффициент ранговой корреляции Спирмена по следующей
формуле:
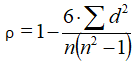 ,
где n - количество ранжируемых признаков,
а d - разность рангов для каждой пары.
Для применения данного коэффициента необходимо, чтобы сравниваемые переменные были записаны в ранговой шкале, а число варьирующих признаков в сравниваемых переменных X и Y было одинаковым.
Поскольку коэффицент ранговой корреляции Спирмена вычисляет тесноту связи между двумя переменными, он является парным, то есть его нельзя применять для более чем двух рядов переменных сразу, а надо разбить их на пары.
Н. Н. Кошелева отмечает, что использование коэффициента ранговой корреляции Спирмена позволяет быстро найти приближенную оценку коэффициента корреляции даже в случае двумерного нормального распределения генеральной совокупности. Коэффициент Спирмена прост в расчётах, а точность оценки даже при больших объёмах выборки составляет порядка 91% от точности оценки по коэффициенту корреляций точно измеренных значений признаков. Она также пишет, что данный коэффициент применяется для оценки устойчивости тенденции динамики, и именно с этой целью коэффициент ранговой корреляции Спирмена применяется в нашей работе. Наконец, эта исследовательница обращает внимание на то, что применение данного коэффициента возможно лишь при наличии не менее 5 наблюдений в каждом ряде значений, а при большом количестве одинаковых рангов коэффициент дает несколько огрубленные значения, что, впрочем, не мешает выявлять тенденции.
Ранговая корреляция находит свое применение во многих науках. Впервые коэффициент Спирмена был разработан для исследований в области психологии (сам Чарльз Спирмен был психологом), но ныне применяется также и в социологических исследованиях (в частности, при анкетированиях и опросах населения), и в экономике, и в педагогике. Ничего не препятствует его использованию и в лингвистическом исследовании, ведь его основная функция - установить связь между явлениями, не поддающимися количественной оценке, но которые можно подвергнуть оценке сравнительной и присвоить ранги.
Несмотря на то, что в нашем исследовании мы получим конкретные цифровые значения индексов ассоциации, вычисленных программой T-Lab, мы решили довольствоваться сравнением ранговых значений, так как ими значительно легче оперировать, нежели абсолютными значениями индексов ассоциации, и при этом сохраняется смысл исследования (выявить общие тенденции на объёмном массиве изучаемых документов) и принцип использования объективных статистических методов.
Наконец, к методам исследования, нашедшим применение в этой работе, можно отнести использование программы Adobe Reader, позволяющей читать документы в формате PDF, не только для чтения этих самых документов, но и для обработки информации. А именно, с помощью функции «Поиск по тексту» мы подсчитали количество упоминаний закона Тубона в каждом из доступных докладов Делегации. Само по себе подсчитанное количество малоинформативно, однако вкупе с общим количеством слов, доступным после создания корпуса каждого доклада в программе T-Lab, позволяет вычислить относительную частоту употребления. А программа Microsoft Office Excel, в которую мы внесли полученные данные, имеет встроенную функцию построения графиков, что привносит в подобные исследования наглядность, куда большую, чем при описании словами.
Все вышеописанные методы, программы и приемы были недоступны для лингвистических исследований ещё 10-20 лет назад. Они позволяют использовать современные информационные технологии в лингвистических исследованиях. Неоспоримое преимущество машинной обработки текста заключается в ее объективности (однако сохраняется фактор субъективности самого исследователя в тех выводах, которые он делает, и в том, как направляет ход исследования), а также в значительном упрощении работы с текстом, ведь при использовании программ, подобных T-Lab, возможно исследование текста, не требующее предварительного полного и внимательного прочтения рассматриваемых документов.
Математические методы также вносят объективность в силу своей доказательности. Цифры и числа, за которыми скрываются результаты экспериментов и исследований, более наглядны, чем пространные описания тех же самых результатов словами.
Таблицы и графики, в которые вносятся данные результаты, также позволяют
существенно сократить объем интерпретирующего текста. Все это придает научному
исследованию некоторую лаконичность и доказательную наглядность.
Глава 3. Исследовательская часть. Анализ докладов об использовании французского языка Главной делегации по французскому языку и языкам Франции
3.1 Анализ словарей наиболее употребительных слов
Анализ Докладов Главной делегации по французскому языку и языкам Франции об использовании французского языка был произведён в несколько этапов.
Хотя анализу в программе T-Lab были подвергнуты все 19 рассматриваемых докладов, нами были отобраны доклады за 2000, 2005, 2010 и 2015 года по принципу равномерного шага в 5 лет, с отсчётом от последнего к настоящему моменту доклада. Это позволило существенно сократить все аналитические процедуры (ведь проанализировать нужно лишь 4 доклада, а не 19), но сохранило возможность пронаблюдать определенные тенденции в изменениях данных.
На первом этапе исследования все доклады с 1997 по 2015 года были проанализированы программой T-Lab, которая представила каждый доклад в виде текстового корпуса и составила частотный словарь каждого корпуса. Мы отобрали из этих словарей по 25 наиболее употребительных полнозначных слов, а также подсчитали относительную частоту их употребления (разделив количество употреблений каждого слова на суммарное количество слов в корпусе), так как доклады различаются по объёму и абсолютная частота употребления была бы здесь непоказательна. Словари наиболее употребительных полнозначных слов в докладах за 2000 и 2005 гг. приведены в табл. 3; за 2010и 2015 гг. - в табл. 4.
К сожалению, в этих таблицах, извлечённых из корпуса программы, не
приводится общее количество употреблений одной леммы, а только каждой отдельной
словоформы, поэтому мы видим здесь существительные и прилагательные отдельно в
единственном числе, и отдельно - во множественном. В дальнейших частях нашего
исследования все данные учитывают лемматизацию, и такой проблемы более не
возникает.
Таблица 3. Словари наиболее употребительных слов в докладах за 2000 и 2005 гг
|
|
доклад за |
общее количество слов |
|
доклад за |
общее количество слов |
||
|
|
2000 |
70839 |
|
2005 |
57720 |
||
|
№ |
лексема |
Абсолютная частота употреблений |
Относительная частота употреблений |
№ |
лексема |
Абсолютная частота употреблений |
Относительная частота употреблений |
|
1 |
français |
575 |
0,81% |
1 |
français |
581 |
1,01% |
|
2 |
langue |
552 |
0,78% |
2 |
langue |
495 |
0,86% |
|
3 |
langues |
393 |
0,55% |
3 |
langues |
439 |
0,76% |
|
4 |
française |
295 |
0,42% |
4 |
anglais |
328 |
0,57% |
|
5 |
france |
260 |
0,37% |
5 |
française |
223 |
|
|
6 |
anglais |
216 |
0,30% |
6 |
traduction |
169 |
0,29% |
|
7 |
loi |
197 |
0,28% |
7 |
france |
163 |
0,28% |
|
8 |
enseignement |
169 |
0,24% |
8 |
travail |
156 |
0,27% |
|
9 |
information |
162 |
0,23% |
9 |
organisation |
138 |
0,24% |
|
10 |
emploi |
149 |
0,21% |
10 |
pays |
132 |
0,23% |
|
11 |
ministère |
148 |
0,21% |
11 |
formation |
120 |
0,21% |
|
12 |
radio |
137 |
0,19% |
12 |
officielles |
119 |
0,21% |
|
13 |
services |
125 |
0,18% |
13 |
conseil |
104 |
0,18% |
|
14 |
notamment |
116 |
0,16% |
14 |
site |
102 |
0,18% |
|
15 |
publics |
106 |
0,15% |
15 |
total |
91 |
0,16% |
|
16 |
communication |
104 |
0,15% |
16 |
documents |
90 |
0,16% |
|
17 |
produits |
102 |
0,14% |
17 |
francophones |
89 |
0,15% |
|
18 |
traduction |
102 |
0,14% |
18 |
fonctionnaires |
87 |
0,15% |
|
19 |
linguistiques |
101 |
0,14% |
19 |
loi |
87 |
0,15% |
|
20 |
public |
99 |
0,14% |
20 |
enseignement |
86 |
0,15% |
|
21 |
travail |
98 |
0,14% |
21 |
européenne |
86 |
0,15% |
|
22 |
étrangères |
97 |
0,14% |
22 |
linguistique |
86 |
0,15% |
|
23 |
recherche |
97 |
0,14% |
23 |
réunions |
85 |
0,15% |
|
24 |
générale |
94 |
0,13% |
24 |
emploi |
84 |
0,15% |
|
25 |
nombre |
94 |
0,13% |
25 |
cour |
83 |
0,14% |