Магистерская работа: История французской языковой политики
Помимо этого, DGLFLF опирается на широкую сеть межминистерских органов, в том числе ответственных за соблюдение существующих законов о языке, комиссии по терминологии и неологии, в том числе высоких чиновников, призванных распространять наработки терминологических комиссий.
К приоритетам Главной делегации относятся:
· забота о том, чтобы все граждане страны имели право на французский язык, поддержание и развитие уровня его использования, а также обеспечение его обогащения;
· внимание к языкам Франции: наблюдение за их использованием, забота об их сохранении и повышение их престижности;
· продвижение многоязычия и укрепления языкового разнообразия во Франции и во всём мире.
При этом, Делегация ссылается на французскую Конституцию, статья 2 которой гласит, что языком Республики является французский, и именно поэтому следит за соблюдением права на язык "в обстоятельствах, предусмотренных законом", ради равного доступа к информации и знанию.
Под эгидой DGLFLF трудятся 18 специальных терминологических комиссий, задачей которых является предложение новых терминов для описания реалий современного мира, то есть поддержание функциональности французского языка. Данная политика издавна осуществляется как практически прямая борьба с засильем английских неологизмов, чья особенно высокая концентрация наблюдается в наиболее быстро развивающихся отраслях промышленности и общественной жизни, в первую очередь в сфере компьютерных и информационных технологий. В связи с этим особое внимание Делегация уделяет работе с "мощными цифровыми устройствами", чтобы как облегчить терминологические исследования и эффективнее распространять вводимые термины среди пользователей, а также собирать их собственные мнения и предложения на этот счёт. Отмечается также, что цифровая сфера позволяет обеспечивать присутствие французского в информационном обществе, поддерживать использование языков, находящихся под угрозой исчезновения, а также обеспечить доступ к культурным ресурсам, как на французском, так и на других языках.
Говоря о распространении французского языка, в Делегации не забывают и про остальные языки, используемые на территории страны: и о "местных языках" заморских регионов и департаментов, и о политике в отношении внутреннего языкового разнообразия, причём вновь следует ссылка на Конституцию, согласно которой региональные языки являются частью национального достояния Франции. Действия DGLFLF должны способствовать увеличению присутствия этих языков «повсюду, где Конституция это позволяет», например, в СМИ и культуре.
Работы и исследования в том, что касается права французов на французский язык, основаны прежде всего на Законе 94-665 от 4 августа 1994 года о использовании французского языка, «законе Тубона».
Делегация призвана следить за соблюдением и применением всех законодательных актов, связанных с французским языком, главным из которых по-прежнему является закон Тубона. Согласно этому законодательному акту, правительство (в лице Делегации) должно ежегодно, в срок до 15 сентября, предоставлять парламенту (Национальной ассамблее) отчёт о применении этого закона.
Данные доклады, послужившие основным материалом нашего исследования, общедоступны как на сайте Делегации, так и на других сайтах, в редакциях с 1997 по 2015 гг. Мы предполагаем, что докладов за период с появления закона и документов, касающихся его применения (например, декрет 95-240 от 3 марта 1995 о применении закона 94-665 от 4 августа 1994 года касательно использования французского языка), до появления первого общедоступного (на сегодня в Интернете) доклада в конце 1997 года написано и выпущено не было.
Любопытно, что до 2001 года включительно доклады были озаглавлены «Доклад Парламенту о применении закона от 4 августа 1994 года о использовании французского языка», а с 2002 года по сей день изменили своё название на «Доклад Парламенту об использовании французского языка».
Как правило, подобный доклад представляет из себя документ объёмом в
120-240 страниц. Он содержит предисловие, которое пишет либо действующий
премьер-министр, либо министр культуры. Начиная с 2002 года (года
переименования) доклады обретают достаточно стабильный формат: в первой части
речь идёт непосредственно о применении закона и языковых практиках внутри
страны (основные разделы повествуют о присутствии французского в общественной
жизни, о ситуации в образовании и о языковом разнообразии внутри страны), а во
второй - о том, как французский язык представлен в различных международных организациях
(Европейский союз, ООН, Международная организация Франкофонии и другие) и какие
шаги предпринимаются для его распространения.
Глава 2. Методы исследования
2.1 История статистических методов. Описание функционала программы T-Lab
В данной выпускной квалификационной работе широко используются статистические методы исследования языкового материала.
Статистические, или количественные, методы для изучения текстового материала начали появляться в начале XX века. Первым к изучению истории (которая представляет из себя, как правило, изучение исторических текстов) стал систематично и последовательно использовать статистические методы Н. А. Морозов.В рамках лингвистики данные методы предварило появление структурной лингвистики (начало XX века), а на математизацию лингвистики в свое время указывали еще Фердинанд де Соссюр и И. А. Бодуэн де Куртенэ. Л. С. Выготский и вовсе утверждает, что первым, кто в математике увидел мышление, происходящее из языка, был Рене Декарт.
Статистическую лингвистику можно определить как дисциплину, изучающую количественные закономерности естественного языка, проявляющиеся в текстах. В основе этой дисциплины лежит предположение, что некоторые численные характеристики и функциональные зависимости между ними, полученные для ограниченной совокупности текстов, характеризуют язык в целом или его функциональные стили.
Многочисленные ученые, занимавшиеся проблематикой квантитативной лингвистики, не всегда сходились во мнении относительно целей и задач математического направления в лингвистике. Однако в современной лингвистике как количественные, так и неколичественные математические методы приобретают все более широкое применение, что связано как с более глубоким пониманием устройства и функционирования языка, так и с появлением прикладных дисциплин (социолингвистика, психолингвистика и др.) и задач, связанных с автоматической обработкой текста. Немаловажно и стремление объективизировать результаты научных исследований в области изучения языка, чему, несомненно, способствуют математические методы.
Использование подобных методов возможно не только в рамках сугубо математической лингвистики. В данной выпускной квалификационной работе важнейшая роль отведена компьютерной программе T-Lab, над которой с 2001 года работает группа итальянских учёных. В нашем исследовании использовалась лицензионная программа T-Lab версии 9.1.Lab это программа, которая состоит из комплекса лингвистических, статистических и графических инструментов анализа текста. Главными типами доступного в программе анализа являются:
· анализ совместной встречаемости;
· тематический анализ;
· сравнительный анализ.
Анализу можно подвергнуть как отдельный текст, так и некую совокупность текстов (от ряда интервью или веб-страниц до корпуса сообщений в социальной сети Twitter). В самом интерфейсе программы доступна функция создания корпуса из ряда разных текстовых файлов.
При импортировании любой текст рассматривается в программе как корпус. В процессе импорта T-Lab осуществляет следующие процессы:
· нормализация корпуса - техническая процедура, разбивающаяся на следующие отдельные процессы: удаление лишних пробелов, выделение знаков препинания, добавление пробела до и после каждого знака препинания (чтобы они не воспринимались как часть слова);
· определение неизменяемых имен собственных (выделяются в отдельную группу), мультислов (multiwords) и «пустых» слов (stop-words, mots vides). Мультислова - это совокупности двух или более слов (словосочетания), функционирующих как одно на уровне означаемого: это могут быть составные имена (например, Ministère de la Justice) или выражения (например, au fur et à mesure, afin de, à l'instar de). Под «пустыми» словами программа определяет неполнозначные слова, не несущие своей собственной семантики, такие как предлоги, артикли, неопределенные наречия и прилагательные, междометия, местоимения, вспомогательные и модальные глаголы (при необходимости, набор «пустых» слов может быть задан пользователем);
· сегментация на элементарные контексты, которыми, по выбору пользователя, могут быть отдельные высказывания, фрагменты, чья длина соответствует длине одного или нескольких высказываний (T-Lab отделяет их следующим образом: новый элементарный контекст начинается после каждого перехода на новый абзац при условии, что длина фрагмента не превышает 400 символов; в случае, когда в пределах 400 символов не происходит перехода на красную строку, программа автоматически отыскивает первый знак препинания (? ! ; : ,) и отделяет фрагмент), абзацы длиной не более 2000 символов или краткие тексты длиной не более 2000 символов. Опцией по умолчанию, которой воспользовались и мы, является разделение на фрагменты;
· автоматическая лемматизация: подобно тому, как в словарях каждая словарная единица соответствует лемме, которая вбирает в себя все результаты склонения или спряжения слова; лемма - это, можно сказать, начальная форма слова: инфинитив для глагола, единственное число у существительных, единственное число мужского рода у прилагательных и т. д. Все слова корпуса распределяются программой на следующие классы: неклассфицированные слова (NCL, non classifiés, как правило, это имена собственные, не входящие в общепринятые словари) и классифицированные, которые включают в себя лемматизированные (LEM, lemmatisés), то есть которым найдена начальная форма, омографы (HOM, homographes) и дифференцированные (DIS, différenciés, à distinguer), к которым не применяется стандартная лемматизация, чтобы не потерять различение смысла в разных формах (например, bien и biens, savoir и savoirs). Приведенные трехбуквенные сокращения применяются в составляемых программой словарях;
· построение словаря: приведём в качестве примера начало
словаря, построенного программой по докладу за 2000 год(табл. 1), чтобы
проиллюстрировать в том числе принцип работы лемматизации:
Таблица 1. Фрагмент словаря корпуса доклада за 2000 год, созданного программой T-Lab
|
WORD |
OCC |
LEMMA |
|
a |
371 |
avoir |
|
à |
1081 |
à |
|
à_bon_escient |
1 |
à_bon_escient |
|
à_condition |
2 |
à_condition |
|
a_été |
106 |
être |
|
à_l_encontre |
2 |
à_l_encontre |
|
à_l_instar_de |
1 |
à_l_instar_de |
|
à_la |
327 |
à_la |
|
à_laquelle |
2 |
à_laquelle |
|
à_partir_de |
13 |
à_partir_de |
В таблице видим словоформу (WORD), количество ее употреблений в корпусе (OCC), лемму, к которой относится данная словоформа (LEMMA). В данном примере иллюстрируется, как формы глагола (a и a été) отнесены к инфинитивам соответствующих глаголов, а устойчивые выражения, в том числе союзные, восприняты как единое мультислово (à bon escient, à condition и т.д.);
· определение ключевых слов, под которыми понимаются все лексические единицы, включенные в таблицы анализа; из этого списка исключаются «пустые» слова; доступна также функция персонализации словаря ключевых слов.
После импорта корпуса пользователь получает доступ ко всем доступным в программе функциям и методам анализа данных.
В сущности, программа состоит, помимо пользовательского интерфейса, из базы данных, в которой рассматриваемый корпус представлен как совокупность таблиц с единицами анализа; и алгоритмов, то есть совокупности операций, которые можно производить с исходными данными.
Единицами анализа программы T-Lab являются:
· лексические единицы - слова, классифицированные в таблицы с двумя столбцами: словоформа (то есть непосредственно тот вид, в котором слово появляется в данном тексте) и лемма (то есть каноническая форма лексемы). Стоит отметить, что программа осуществляет автоматическую лемматизацию текстов на 6 основных европейских языках;
· контекстуальные единицы - это отрезки текста, на которые может быть подразделён корпус. Среди них различают первичные документы (в случае составления корпуса из нескольких файлов), элементарные контексты (соответствующие синтагматическим единицам) и подкорпуса (разделение на которые можно осуществить автоматически с помощью инструментов программы или вручную по своим собственным критериям).
Остановимся подробнее на основных способах использования включенных в программу инструментов анализа текста. Все они направлены на получение таблиц и графиков, отображающих существенные отношения между единицами текста и позволяющих выводить определённые заключения (в зависимости от цели исследования). Графики и таблицы можно экспортировать для работы в программах группы Microsoft Office.
В данном исследовании использовались преимущественно инструменты анализа совместной встречаемости. Они позволяют анализировать различные типологии отношений между словами. Среди них выделяются следующие функции:
· Ассоциации слов: программа отображает визуальную карту слов, схожих по своей совместной встречаемости (co-occurrence), которая вычисляется из элементарных контекстов этих слов (т.е. исходных предложений, либо можно выставлять свои критерии вычислений). На этом типе анализа мы подробнее остановимся ниже, так как именно он в основном использовался в наших исследованиях.
· Сравнения пар (рис. 1): этот инструмент позволяет сравнивать
совокупности элементарных контекстов (то есть контекстов совместной
встречаемости), в которых присутствуют оба элемента из выбранной пары ключевых
слов. График отображает, с какими леммами встречается отдельно элемент А (из
пары), элемент В или оба элемента (АВ) и в каких количественных соотношениях.
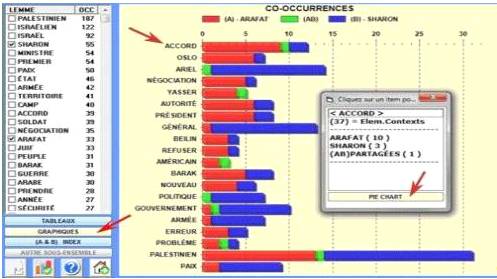
Рисунок
1. Сравнение совместной встречаемости пары лексем "Sharon" и
"Arafat" (пример взят из руководства пользователя программы T-Lab)
· Анализ ассоциированных слов и Карты концептов по тематическим
ядрам (кластерам). Получаемые результаты (по методу Сэммона) внешне напоминают
технологии «облака» используемых слов, в которых наиболее употребительные слова
изображены крупнее, чем редкие (рис. 2).
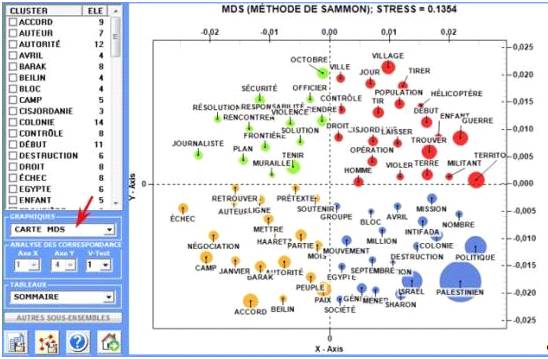
Рисунок
2. Пример кластерного анализа (взято из руководства пользователя программы
T-Lab)
· Анализ последовательностей (sequence), построенный по
принципу марковских цепей: посредством анализа всех предыдущих и следующих для
некоторой лексической единицы слов T-Lab вычисляет матрицу переходных
вероятностей, что отображается в виде графиков (рис. 3), где самые близкие
(будь то до или после рассматриваемой единицы - это два вида получаемых
графиков) слова оказываются ближе к ключевому слову.
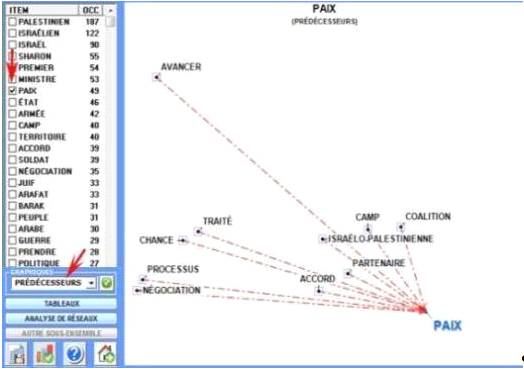
Рисунок
3. Анализ последовательностей лексем, предшествующих лексеме "paix"
(пример взят из руководства пользователя программы T-Lab)
А теперь подробнее о методе ассоциации слов. Он позволяет установить и проверить, как отношения совместной встречаемости и схожести определяют его местное значение в пределах корпуса (или какой-то из его частей), то есть с какими словами ассоциируется и как через них определяется рассматриваемое понятие. По умолчанию расчёт совместной встречаемости и ассоциации слов ведется в элементарных контекстах, рассчитанных для данного корпуса. При выводе карты ассоциаций работа ведётся с таблицей наиболее употребительных слов (с указанием количества употреблений). По умолчанию служебные слова (предлоги, союзы, артикли, а также другие типы неполнозначных слов), которые объективно используются чаще всего, из этой таблицы легко исключаются. При клике на каждое из слов отображается визуальная карта ассоциаций выбранного слова. При этом, чем чаще какое-то слово встречается в одном контексте со словом-ядром данной визуальной карты, тем ближе оно находится на схеме. Таким образом, вычисления ведутся попарно для отношений слова-ядра с каждым из остальных, представленных в таблице. Доступны также таблицы, где отображены цифровые данные по совместной встречаемости взятых слов и коэффициентам их совместной встречаемости.