Материал: Управление сложными социально-экономическими системами. Мищенко В.Я., Баркалов С.А
При формировании новой матрицы расстояний, выбираем наименьшее значение из значений объектов №1,2,9 и №5.
В результате имеем 6 кластера: S(1,2,9,5), S(3), S(4), S(6,10), S(7), S(8).Из матрицы расстояний следует, что объекты 4 и 8 наиболее близки P4;8 = 11.4 и поэтому объединяются в один кластер.
Таблица 8
Расчёт к Задаче 2
№ п/п |
1,2,9,5 |
3 |
[4] |
6,10 |
7 |
[8] |
1,2,9,5 |
0 |
38.59 |
31.02 |
53.04 |
18 |
42.38 |
3 |
38.59 |
0 |
23.77 |
29.73 |
33.06 |
27.59 |
[4] |
31.02 |
23.77 |
0 |
52.2 |
15.56 |
11.4 |
6,10 |
53.04 |
29.73 |
52.2 |
0 |
56.65 |
57.31 |
7 |
18 |
33.06 |
15.56 |
56.65 |
0 |
26.08 |
[8] |
42.38 |
27.59 |
11.4 |
57.31 |
26.08 |
0 |
При формировании новой матрицы расстояний, выбираем наименьшее значение из значений объектов №4 и №8. В результате имеем 5 кластера: S(1,2,9,5), S(3), S(4,8), S(6,10), S(7). Из матрицы расстояний следует, что объекты 4,8 и 7 наиболее близки P4,8;7 = 15.56 и поэтому объединяются в один кластер.
Таблица 9
Расчёт к Задаче 2
№ п/п |
1,2,9,5 |
3 |
[4,8] |
6,10 |
[7] |
1,2,9,5 |
0 |
38.59 |
31.02 |
53.04 |
18 |
3 |
38.59 |
0 |
23.77 |
29.73 |
33.06 |
[4,8] |
31.02 |
23.77 |
0 |
52.2 |
15.56 |
6,10 |
53.04 |
29.73 |
52.2 |
0 |
56.65 |
[7] |
18 |
33.06 |
15.56 |
56.65 |
0 |
При формировании новой матрицы расстояний, выбираем наименьшее значение из значений объектов №4,8 и №7. В результате имеем 4 кластера: S(1,2,9,5), S(3), S(4,8,7), S(6,10). Из матрицы расстояний следует, что объекты 1,2,9,5 и 4,8,7 наиболее близки P1,2,9,5;4,8,7 = 18 и поэтому объединяются в один кластер.
Таблица 10
Расчёт к Задаче 2
№ п/п |
[1,2,9,5] |
3 |
[4,8,7] |
6,10 |
[1,2,9,5] |
0 |
38.59 |
18 |
53.04 |
3 |
38.59 |
0 |
23.77 |
29.73 |
[4,8,7] |
18 |
23.77 |
0 |
52.2 |
6,10 |
53.04 |
29.73 |
52.2 |
0 |
При формировании новой матрицы расстояний, выбираем наименьшее значение из значений объектов №1,2,9,5 и №4,8,7. В результате имеем 3 кластера: S(1,2,9,5,4,8,7), S(3), S(6,10)
Таблица 11
Расчёт к Задаче 2
№ п/п |
1,2,9,5,4,8,7 |
3 |
6,10 |
1,2,9,5,4,8,7 |
0 |
23.77 |
52.2 |
3 |
23.77 |
0 |
29.73 |
6,10 |
52.2 |
29.73 |
0 |
Результаты иерархической классификации объектов представлены на рис. в виде дендрограммы (Рис. 1).
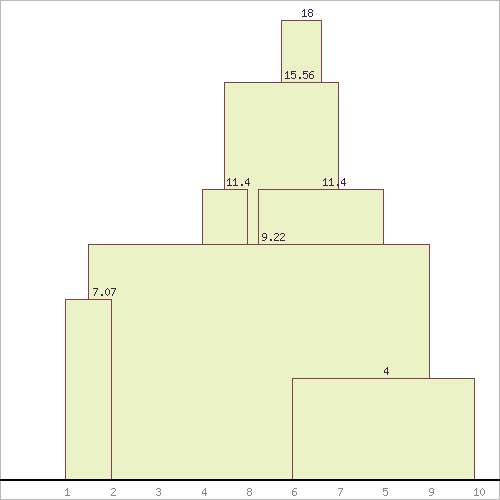
Рис. 1. Дендрограмма к Задаче 2
Таким образом, стоит отметить, что 1 группа (кластер) составляют те строители, которые явно недовольны своей заработной платой и их стоит поощрять к труду, следовательно, им требуется повысить з/п, им же необходим соц.пакет. Возможно. Это новые рабочие или рабочие, работающие не на полную ставку. Вторая группа, пожалуй, самая довольная. В неё вошёл только один рабой (по списку третий). Его з/п составляет 90 т.р. И в итоге третий кластер – это рабочие под номером 6 и 10. Эти рабочие вероятнее всего будут довольны своей заработной платой и дополнительные поощрения им не требуются.
Строительство является одной из наиболее важных отраслей экономики. По общему объему производимой продукции и количеству занятых работников на строительную отрасль приходится приблизительно десятая часть всей экономики страны. Однако мировой финансовый кризис привел к сложной ситуации на жилищно-строительном рынке России. Увеличение стоимости банковских кредитов, а так же сокращение продаж жилья повлияло негативно на данный сектор. Привело к дефициту средств для финансирования и снизило рентабельность компаний, занимающихся строительным бизнесом [9, 10]. По сравнению с докризисным периодом уменьшилось количество выдаваемых кредитов. Это связано с риском невозврата денег и крупными задолженностями перед банками строительных организаций. Иногда строительные организации идут на мошеннические операции, чтобы получить кредит и подделывают документацию, скрывая реальное положение дел на фирме. Следующая задача, рассмотренная нами, основывается на теории эволюции (задача 3). Этот подход кластерного анализа помогает сгруппировать интересующие нас объекты по определённым признакам и выявить закономерности для последующих группировок. Помогает отличить оригиналы от подделок, выявить скрытые схемы и фиктивную документацию. Далее попробуем объяснить основные этапы группировки.
Формируется случайная популяция группированных решений (рис. 2). Каждая группа представляет собой вид последовательности целых чисел длины N, кодирующих номера кластеров. Для каждой последовательности определяется свой критерий качества.
2 |
2 |
2 |
1 |
1 |
3 |
3 |
3 2 |
2 |
2 |
1 |
1 |
1 |
1 |
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
1 |
1 |
1 |
1 |
2 |
2 |
33 |
3 |
3 |
1 |
1 |
2 |
2 |
2 |
|
|
|
|
|
|
|
... |
|
|
|
|
|
|
|
3 |
3 |
3 |
3 |
3 |
1 |
1 |
1 1 |
1 |
1 |
2 |
2 |
2 |
2 |
2 |
Рис. 2. Популяция хромосом; число классов K=3, число объектов N=1
Затем путём внедрения эволюционных операторов генерируем последующую популяцию. Оператор селекции служит для случайного выбора «родительских» хромосом, самых выгодных с точки зрения критерия качества. Рекомбинация служит для образования из отобранных хромосом новых группировок с новыми последовательностями. Существует популярный оператор рекомбинации «кроссовер». Этот оператор для каждой пары «родительских» хромосом образует пару хромосом-копий с помощью перестановки одного или нескольких сегментов (Рис.3).
Существует правило, благодаря которому оператор мутации случайным образом меняет последовательность (как пример, можно заменить в случайно отобранном сегменте один номер группы на другой). Для получившейся популяции вычисляются следующие значения критерия.
Шаг 2 повторяется, пока не будет выполняться заданное условие остановки.
2
2
2
1
1
3
3
3 2 2 2 1 1 1 11
точка
кроссовера
1
1
1
1
1
2
2
3
3
3
3
1
1
2
2
2

продукт 2
2 2 2 1 1 3 3 3 3 3 3 1 1 2 2 2
1 1 1 1 1 2 2 3 2 2 2 1 1 1 1 1
Рис. 3. Оператор кроссовера
Описанный оператор рекомбинации имеет несколько существенных недостатков, среди которых можно отметить недействительность группированных решений и восприимчивость к определённым контекстам. Недействительность решений может возникнуть тогда, когда образуются копии с наименьшим числом кластеров. Например, после применения оператора кроссовера к последовательностям (2 2 1 1 3 3) и (3 3 1 2 1 2) в точке между вторым и третьим элементами, возникают две новые последовательности (3 3 1 1 3 3) и (2 2 1 2 1 2), у которых только два кластера [6]. Восприимчивость к контексту проявляется, когда одно и то же группированное решение кодируется разными последовательностями. Например, последовательности (1 1 1 2 2 2) и (2 2 2 1 1 1) представляют одно и то же разбиение объектов на группы. При этом копии этих последовательностей (1 1 1 1 1 1) и (2 2 2 2 2 2) значительно отличаются от продуктов-оригиналов [4].
Таким образом, мы рассмотрели 3 примера, связанные с кластерным анализом. Это иерархический кластерный анализ, эволюционный (генетический) подход и принцип «ближайшего соседа» в кластерном анализе. Следовательно, можно сделать вывод, что, несмотря на достаточно огромное количество существующих способов группировки, кластерный анализ остаётся самой актуальной методологией, используемой для группировки в строительстве и других сферах.