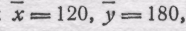Материал: Введение в статистические методы управления качеством. учебное пособие. Пентюхов В.И., Мищенко Е.В
Предположим теперь, что события А и В несовместны при данном опыте и что этот опыт повторяется п раз.
Допустим, что нам безразлично, какое событие появится: А или В. Иными словами, нас интересует сложное событие, которое заключается в том, что появится или событие А, или событие В, безразлично, какое именно.
Например, предположим, что опыт состоит в том, что мы покупаем один билет денежно-вещевой лотереи и нас интересует выигрыш автомобиля или мотоцикла.
Пусть событие А представляет собой выигрыш автомобиля, а событие В — выигрыш мотоцикла.
В данном случае нас интересует сложное событие, которое состоит в том, что мы выиграем транспортное средство, безразлично, какое именно: автомобиль или мотоцикл.
Очевидно, что в данном случае события А и В несовместны, так как на один билет можно получить только один выигрыш.
Предположим, что в результате п опытов появилось т раз событие А иl раз событие В. Следовательно, интересующее нас сложное событие «A или В» появилось т+ l раз и его частота равна
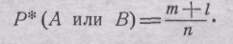
Но частоты событий А и В в данном случае равны соответственно m/n и l/n.
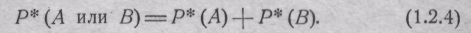 Следовательно,
предыдущее равенство можно переписать
в виде
Эта формула выражает теорему сложения частот:
частота появления одного из двух несовместных событий, безразлично, какого именно, равна сумме частот этих событий.
Сложное событие, представляющее собой появление хотя бы одного из нескольких событий А1, А2, ..., Ап, называется суммой или объединением этих событий.
На основании определения суммы событий событие «А или В» можно также записать в виде А+ В и предыдущее равенство, выражающее теорему сложения частот, можно переписать в виде
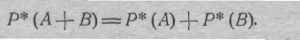
Теорема сложения частот справедлива для любого числа несовместных событий.
События A1 ..., Ап называются несовместными, если никакие два из них не могут появиться вместе.
Если события А1, ..., Ап несовместны, то
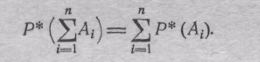
Эта формула легко доказывается непосредственно, так же как для случая двух несовместных событий, или же методом математической индукции.
Полученная формула выражает общую теорему сложения частот: частота появления какого-нибудь одного из несовместных событий, безразлично, какого именно, равна сумме частот этих событий.
В некоторых случаях возникает необходимость рассматривать несколько событий в их взаимосвязи, например, когда необходимо определить, как влияет появление или не появление одного события на частоту появления другого.
В этом случае, кроме частоты события А для всей серии произведенных опытов, вычисляют также частоту события А, учитывая только те из произведенных опытов, в результате которых появилось другое интересующее нас событие В.
Иными словами, перед определением частоты события А отбирают только те из произведенных опытов, в которых появилось событие В, а остальные опыты не учитывают.
Частота
события
А,
вычисленная
только для тех из произведенных опытов,
в
которых появилось событие В,
называется
условной
частотой
события
А
относительно
события В
и
обозначается

Если при п опытах событие В появилось l раз, а событие А появилось совместно с событием В k раз, то условная частота события А относительно В равна
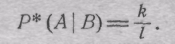 :
Или
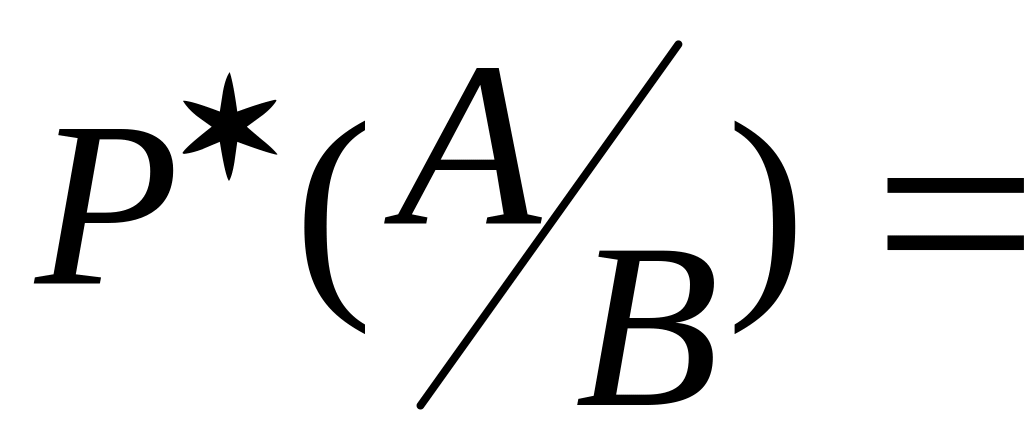
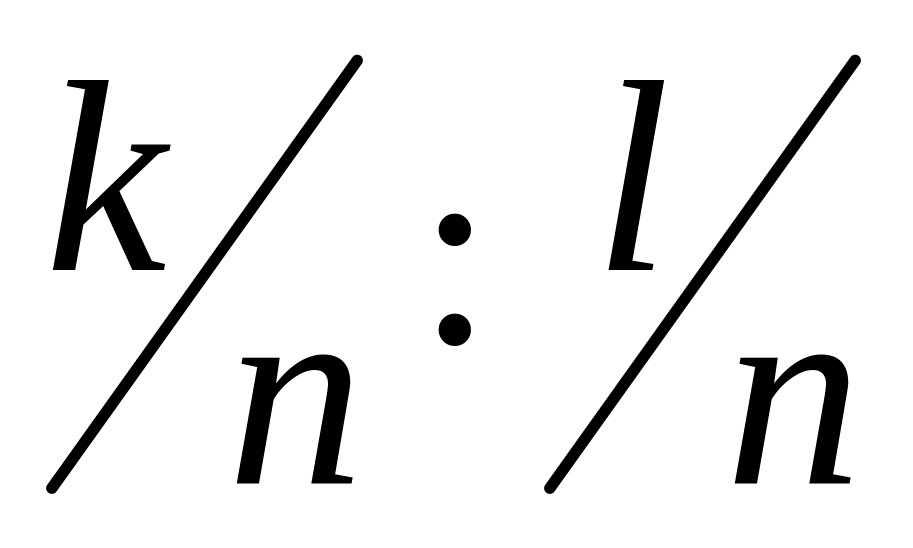
Так как дроби l/n и k/n представляют собой соответственно частоту события В и частоту совместного появления событий А и В, то предыдущую формулу можно переписать в виде
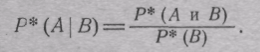
Совершенно аналогично определяется условная частота события В относительно А как частота события В, вычисленная с учетом только тех опытов, в которых появилось событие А:
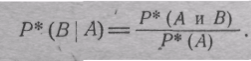
п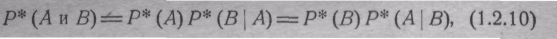 олученные
формулы выражают теорему
умножения частот:
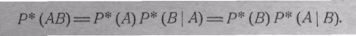
частота совместного появления двух событий равна частоте одного из них, умноженной на условную частоту другого относительно первого.
 Событие,
представляющее собой совместное
появление нескольких событий, часто
называется произведением
или
пересечением
этих
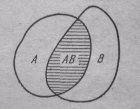
событий. На рис. 1.1
произведение событий А
и
В
для
иллюстрации показано как общая часть
(заштрихованная)
Рис. 1.1
соответствующих областей.
 Пользуясь
определением произведения
событий, можно событие «А и В»
записать
в виде произведения
АВ.
Тогда
теорема умножения частот, запишется
в виде
Сравнивая условную частоту события А относительно события В с частотой события А во всей серии произведенных опытов (называемой обычно безусловной), можно судить о взаимосвязи событий А и В.
Если при большом числе опытов условная частота события А относительно В приблизительно равна безусловной частоте события А, то это означает, что полное число появлений события А делится приблизительно пропорционально между теми опытами, в которых событие В появилось, и теми опытами, в которых событие В не появилось. Это может служить признаком отсутствия зависимости события А от события В.
Если же условная частота события А относительно В значительно отличается от безусловной частоты события А, то это может служить признаком наличия некоторой связи между событиями А и В.
Применяя метод математической индукции, можно распространить теорему умножения частот на произвольное число событий. В результате получим
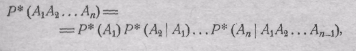
причем порядок нумерации событий не имеет значения и может быть установлен произвольно.
Перейдем теперь к вопросу об экспериментальном изучении случайных величин.
Согласно данному общему определению случайной величиной называется любая величина, которая в результате опыта принимает одно и только одно какое-нибудь значение, а в результате разных опытов может принимать различные значения.
Каждое значение, которое может принять случайная величина в результате опыта, называется ее возможным значением.
Мы будем обозначать случайные величины большими буквами, преимущественно последними буквами латинского алфавита, а их возможные значения — соответствующими малыми буквами. Например, случайные величины будем обозначать буквами X, Y, Z, а их возможные значения — соответственно буквами х, у, z.
С любой случайной величиной X можно связать событие А, представляющее собой выполнение неравенства Х<х, где х — данное число.
Тогда можно определить частоту события А для различных значений х. В результате получим функцию
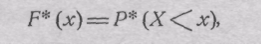
которая
обычно называется статистической
функцией распределения
случайной
в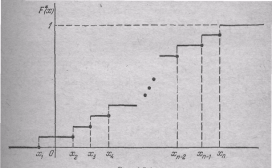 еличины
X.
Для
изучения свойств статистической функции
распределения предположим, что в
результате
п
опытов
случайная величина X
приняла некоторые
значения, которые мы пронумеруем в
порядке не убывания:
x1,
х2,…хп
(рис.
1.2).
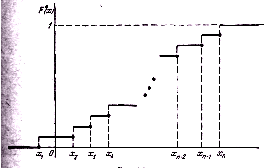
Рис. 1.2.
Очевидно, что для любого значения х в интервале xk<x,<xk+1 число опытов, в которых было выполнено неравенство Х<х, равно k.
Следовательно,
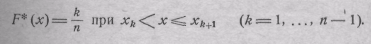
При
любом
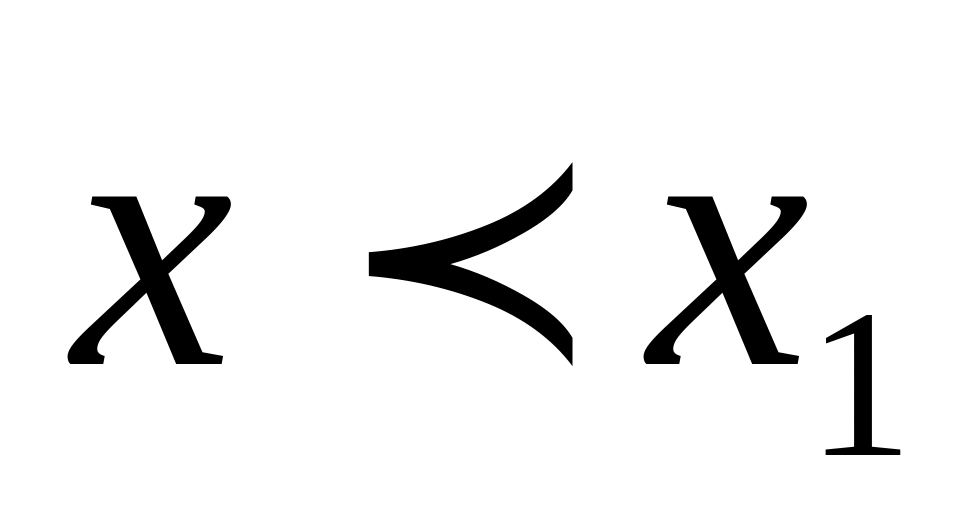 число опытов, в которых было выполнено
неравенство Х<х,
равно
нулю, а при любом х>хп
число
опытов, в которых было выполнено
неравенство Х<х,
равно
п.
Таким образом, статистическая функция распределения случайной величины X представляет собой ступенчатую функцию, равную нулю во всех точках числовой оси, лежащих левее всех точек x1 ..., хп, соответствующих значениям, которые приняла случайная величина X в результате произведенных опытов, и единице во всех точках числовой оси, лежащих правее всех точек x1 хn (рис. 1.2).
При переходе точки х через любую из точек x1, ..., хп, не совпадающую ни с какими другими из этих точек, статистическая функция распределения увеличивается скачком на 1/n. Если какие-нибудь l из точек x1 ..., хn совпадают, то при переходе точки х через эту «l-кратную» точку статистическая функция распределения увеличивается скачком на l/n.
Статистическая функция распределения является полной характеристикой результатов наблюдения случайной величины в данной серии опытов.
Однако иногда целесообразно ограничиться более простой, хотя и неполной характеристикой случайной величины при помощи нескольких чисел.
Простейшей числовой характеристикой случайной величины X в данной серии опытов является ее среднее арифметическое значение
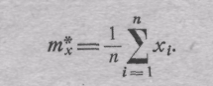
В случае, когда какие-нибудь l из значений x1 ..., хп, принятых случайной величиной X в результате п опытов, совпадают, коэффициент при этом общем значении xi равен частоте появления этого значения l/n. Так, например, если x1 = ... = xl1 = a1 xl1+1 = .-..==xl1+l2 =a2, ..., xl1 + .., + ik-l + 1= ..=xl2 + .._. + lk=xn= ak, то последняя формула принимает вид
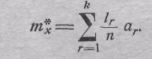
Проведём теперь это же рассуждение .
Вспомним:
если частотность появления
значения величины
 равна
 ,
то
это означает, что в серии из
 операций
это значение
 будет
наблюдаться примерно
 раз,
где

откуда
 ;
аналогично, значение
 при
этом встретится
примерно
 раз,
и т. д.
Таким
образом, серия
из
 операций
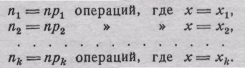
будет в среднем содержать
Сумма
значений величины
 во
всех п
произведенных
операциях
будет поэтому примерно равна
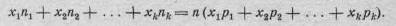
Поэтому
среднее значение
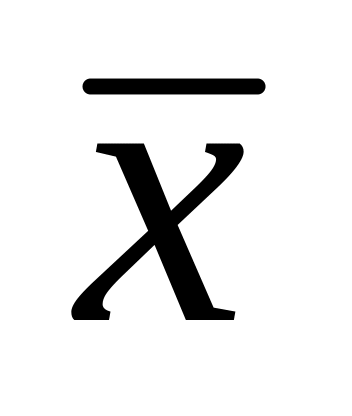 случайной величины, соответствующее
отдельной операции и получаемое из
только что
написанной суммы делением на число
 операций
в
данной
серии, будет равно
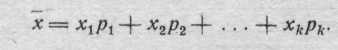
Мы приходим, таким образом, к следующему важному правилу: для получения среднего значения случайной величины надо каждое из её возможных значений помножить на соответствующую ему вероятность и сложить между собою все полученные произведения.
Таким образом, среднее значение случайной величины в данной серии опытов равно сумме всех принятых этой величиной значений, умноженных на частоты этих значений. Иными словами, среднее значение случайной величины представляет собой ее взвешенное среднее значение, причем веса принятых случайной величиной значений равны соответствующим частотам.
Весьма важно, что для вычисления среднего значения суммы во всех случаях достаточно знать средние значения слагаемых и что
среднее значение суммы всегда равно сумме средних значений слагаемых.
Таким образом, если х и у — две совершенно произвольные случайные величины, то
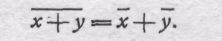
В вышеприведённом примере х — число изделий одного только первого предприятия, у — число изделий второго предприятия: и значит