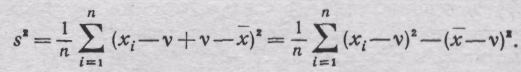Материал: Введение в статистические методы управления качеством. учебное пособие. Пентюхов В.И., Мищенко Е.В
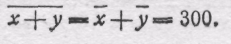
Рассмотрим пример. Представим себе, что испытываются на урожайность два сорта пшеницы, В зависимости от случайных обстоятельств (количество осадков, распределение удобрений, солнечная радиация и пр.) урожай с квадратного метра подвержен значительным колебаниям и представляет собой случайную величину. Предположим, что при одинаковых условиях средний урожай для каждого сорта один и тот же —G граммов с квадратного метра.
Можно ли судить о качестве испытываемого сорта только по значению среднего урожая?
Очевидно, что нет, так как наибольший хозяйственный интерес представляет тот сорт, урожайность которого меньше подвержена случайным влияниям метеорологических и других факторов, иными словами, для которого «рассеяние» урожайности меньше.
Мы видим, таким образом, что при испытании того или иного сорта пшеницы на урожайность не меньшее значение, чем средняя урожайность, имеет размах возможных её колебаний.
Для характеристики разброса значений случайной величины X в данной серии опытов можно пользоваться средним значением какой-нибудь положительной меры отклонения случайной величины от ее среднего значения.
В качестве положительной меры отклонения случайной величины от ее среднего значения удобнее всего пользоваться квадратом разности между значением случайной величины и ее средним значением. Тогда получим в качестве характеристики разброса значений случайной величины X в данной серии опытов величину
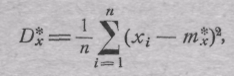
которая обычно называется статистической дисперсией случайной величины X.
Очевидно, что статистическая дисперсия имеет ту же размерность, что и квадрат данной случайной величины. Однако практически удобнее пользоваться для характеристики разброса величиной, имеющей ту же размерность, что и данная случайная величина. Чтобы получить такую характеристику, достаточно извлечь квадратный корень из статистической дисперсии. Таким образом, практической мерой разброса значений случайной величины X в данной серии опытов может служить ее статистическое среднеквадратическое отклонение, представляющее собой положительный квадратный корень из ее статистической дисперсии:
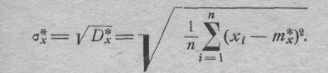
Если некоторые из значений xt принятых случайной величиной X, совпадают, то соответствующие слагаемые в полученных формулах совпадают и их можно объединить. В результате статистическая дисперсия выразится через значения а1,……ак, принятые случайной величиной, и их частоты формулой
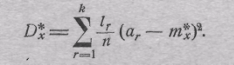
Пусть мы имеем несколько случайных величин x1,…xn со среднеквадратическими отклонениями s1,….sn,
тогда дисперсия суммы взаимно независимых случайных величин равна сумме их дисперсий, т.е.
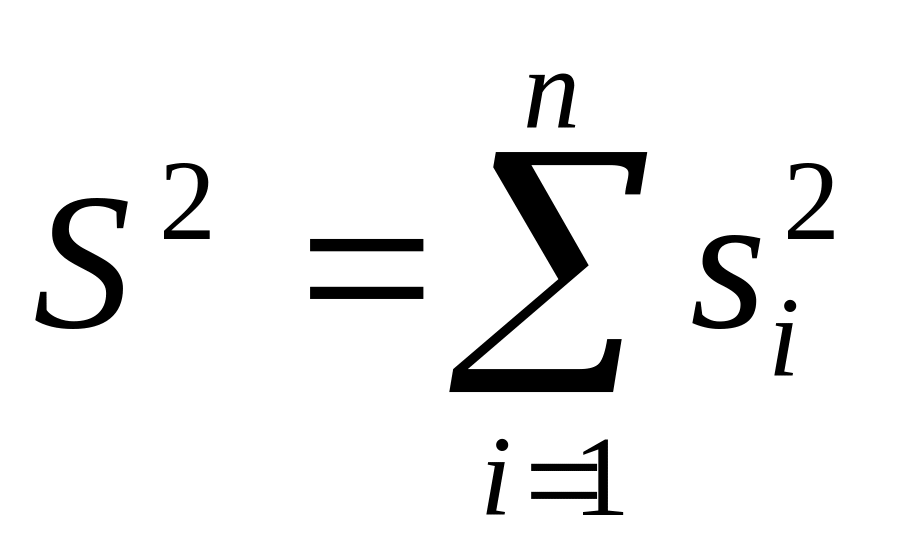
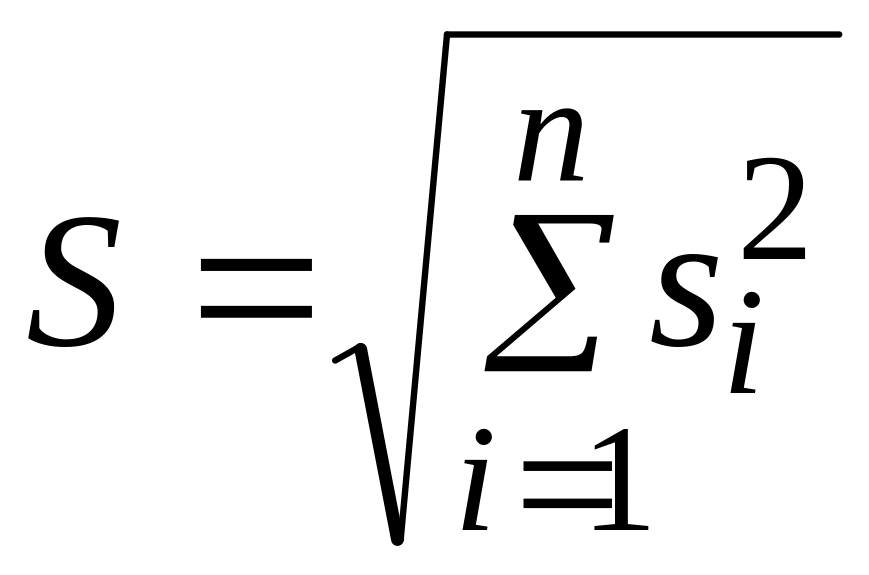
В случае взаимно независимых случайных величин к правилу сложения средних значений присоединяется весьма важное правило сложения дисперсий
Эта возможность просто выразить среднеквадратическое отклонение суммы через среднеквадратические отклонения её слагаемых в случае их взаимной независимости и представляет собою одно из важнейших преимуществ среднеквадратических отклонений сравнительно со средними, срединными и другими отклонениями.
Пример 1. Найдем при п выстрелах с одной и той же вероятностью попадания р среднее значение числа попаданий и среднеквадратическое отклонение.
Чтобы ориентировочно оценить, сколь большим может оказаться отклонение фактического числа попаданий от этого среднего значения, найдём среднеквадратическое отклонение числа попаданий по вышеприведенной формуле.
В самом деле, число попаданий при п выстрелах можно рассматривать как сумму чисел попаданий при отдельных выстрелах, а так как эти числа мы считаем взаимно независимыми случайными величинами, то по правилу сложения дисперсий мы для вычисления среднеквадратического отклонения S общего числа попаданий можем воспользоваться вышеприведенной, где s1,…….sn означают среднеквадратические отклонения чисел попадания при отдельных выстрелах.
Но попадание xi при i-ом выстреле определяется таблицей
Значение xi |
1 |
0 |
вероятность |
р |
1-р= =q |
Тогда
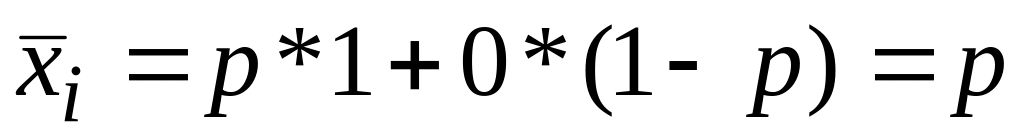
и
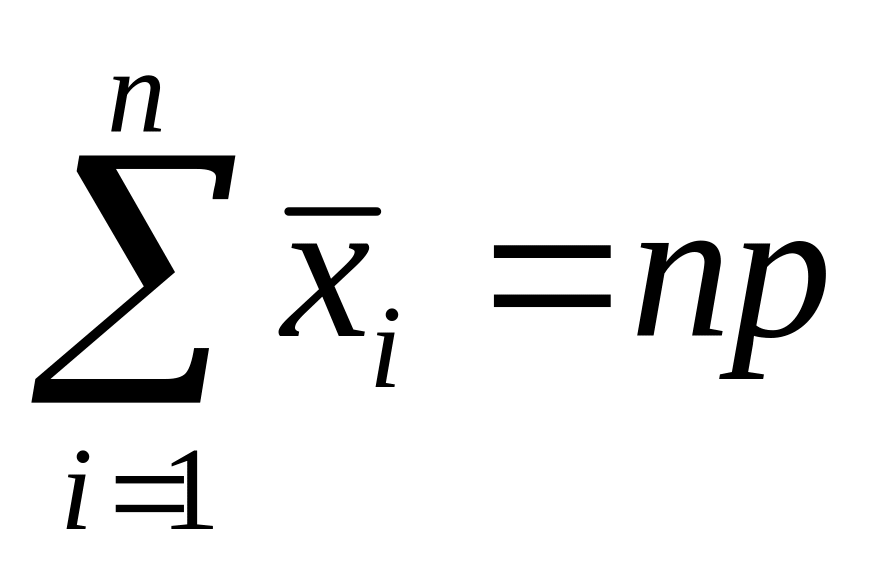
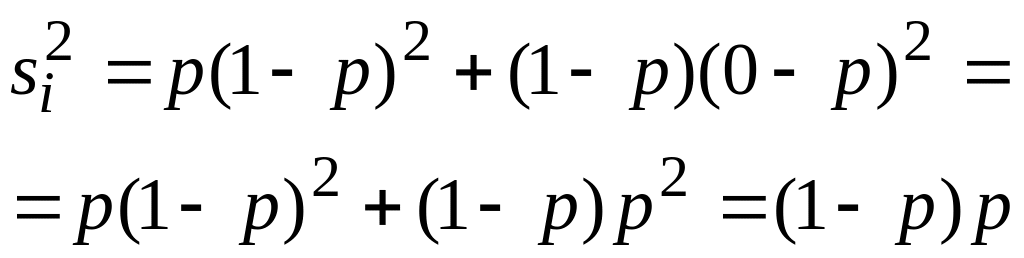
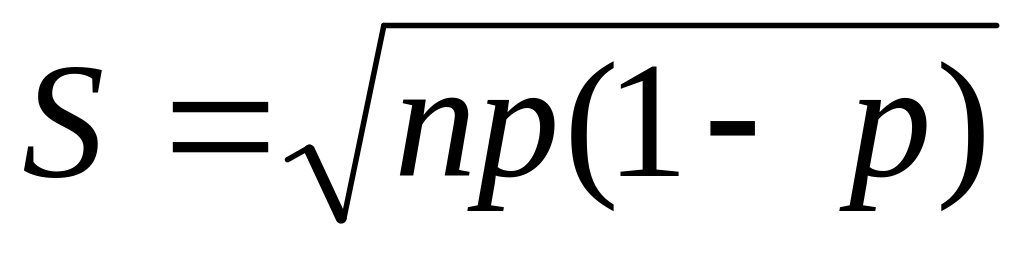
Этим поставленная задача решена.
Сопоставляя
среднее значение числа
попаданий с его среднеквадратическим
отклонением
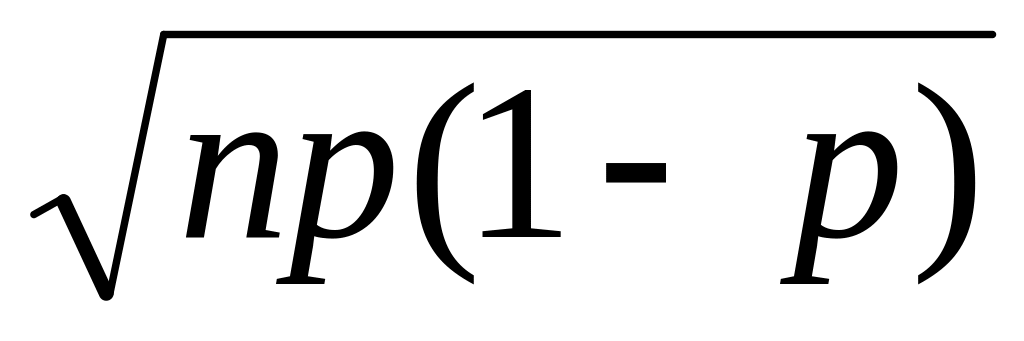
мы видим, что при больших значениях n (т.е. при большом числе выстрелов) последнее значительно меньше первого и составляет лишь небольшую долю его.
Так,
при
 среднее
значение числа попаданий
равно
 а
среднеквадратическое уклонение
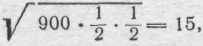 так
что фактическое число попаданий
ориентировочно лишь на 3—4°/0
будет отклоняться от своего среднего
значения.
Пример
2.
Представим себе, что производится сборка
некоторого
механизма, состоящего из деталей,
прикладываемых
вплотную одна к другой вдоль некоторой
оси и охватываемых
с концов некоторой объемлющей деталью
(рис.
1.3).
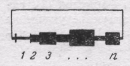
Рис. 1.3.
Длина каждой детали может несколько отличаться от соответствующего стандарта, и есть поэтому случайная величина. Предположим, что эти случайные величины являются не зависимыми. Если средние длины деталей и их среднеквадратические отклонения этих длин равны соответственно
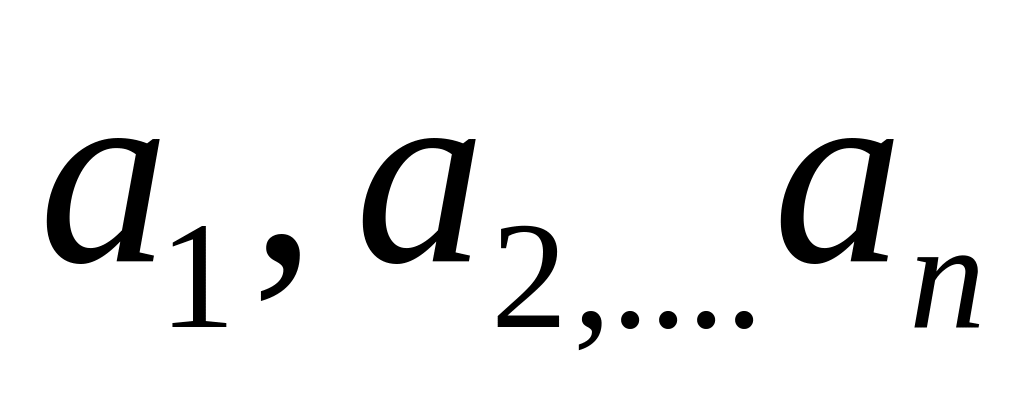 и
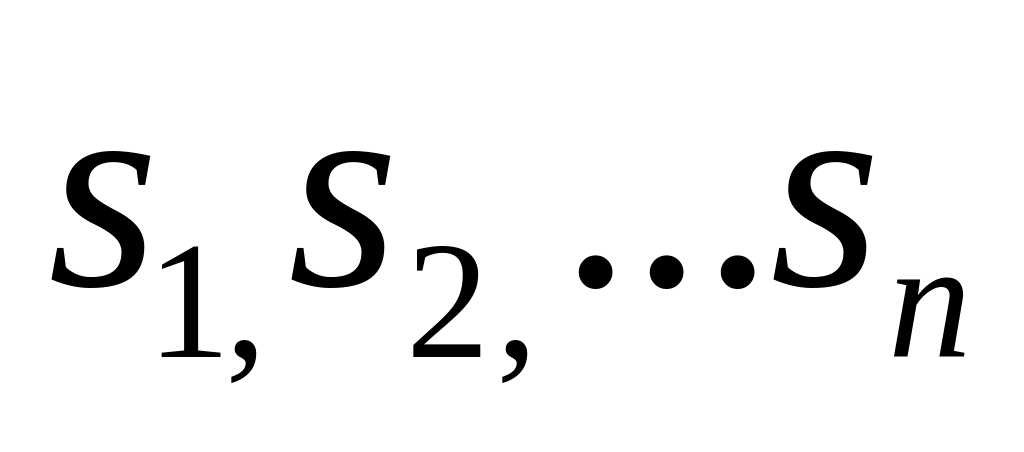 ,
то среднее значение и дисперсия длины цепи из п деталей равны
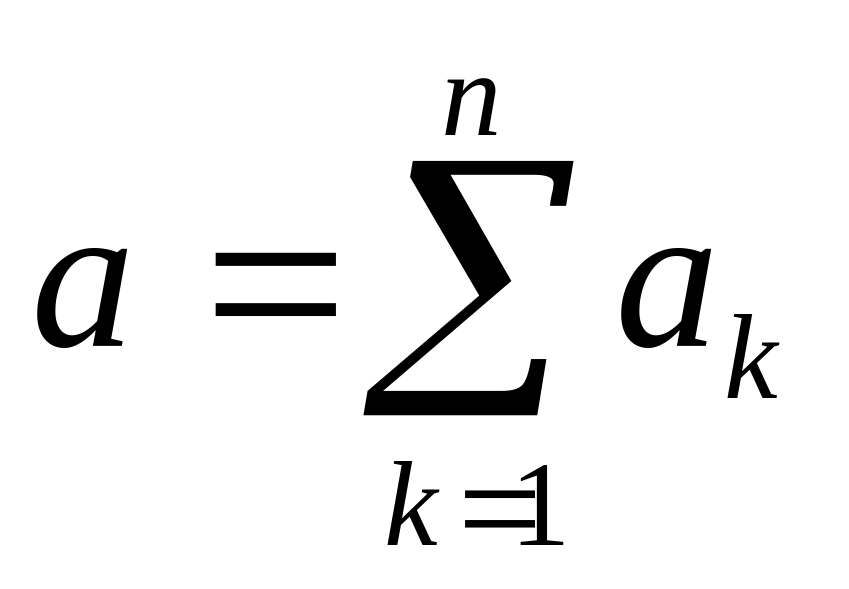 и
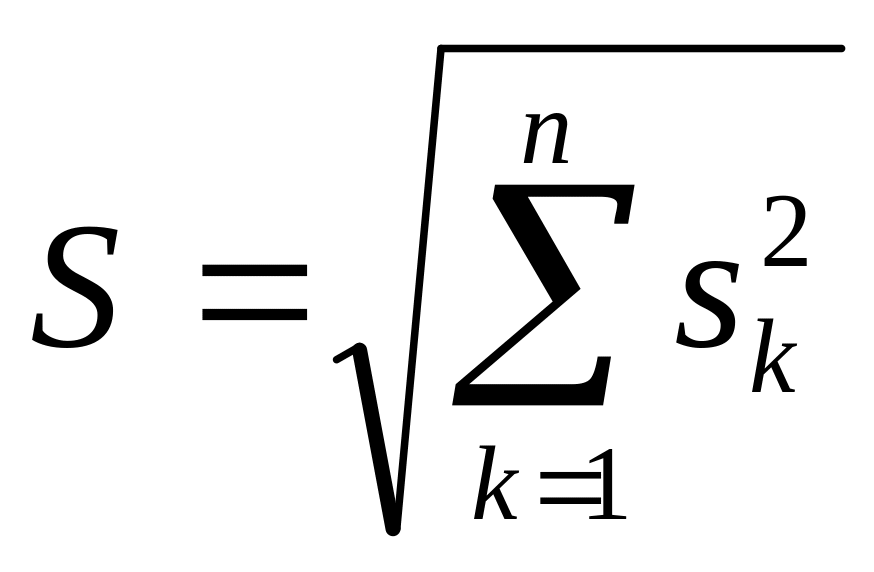
В
частности, если
 и
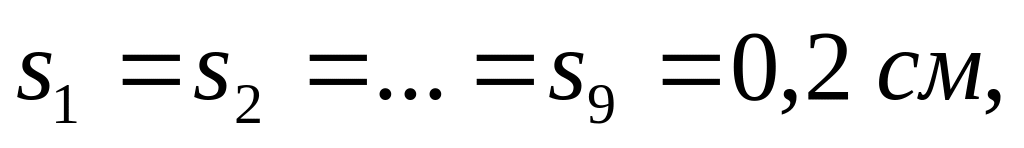 то a=90
см и
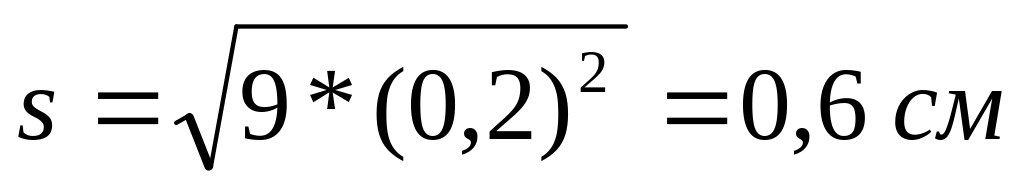
М ы
видим, таким образом, что если в среднем
длина каждой
отдельной детали уклоняется от своего
среднего значения на 2°/0,
то длина цепи из этих деталей отличается
от
своего среднего значения примерно лишь
на 2/3°/0.
Это обстоятельство — уменьшение относительной ошибки при сложении случайных величин — играет значительную роль при сборке точных механизмов.
Действительно, если бы не было взаимной компенсации отклонений размеров отдельных деталей от заданных нормальных размеров, то при сборке механизмов постоянно встречались бы случаи, когда объемлющие детали не охватывали бы объемлемой цепи или, напротив, при этом оставались бы чрезмерно большие зазоры.
В обоих случаях получался бы явный брак.
Бороться с этим браком путем уменьшения допустимых отклонений фактических размеров детали от заданных нецелесообразно. Ибо сравнительно небольшое увеличение точности обработки значительно повышает её стоимость.
Пример 3. Допустим, что в неизменных условиях производятся п измерений некоторой величины.
В результате целого ряда обстоятельств (положения прибора, наблюдателя, колебания в состоянии воздуха, наличия в нём пылинок и пр.) различные измерения будут давать, вообще говоря, различные результаты — имеют место случайные ошибки измерений.
Будем
обозначать результаты измерений через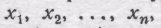 приписывая
каждому х
в
качестве индекса
(значка) номер измерения.
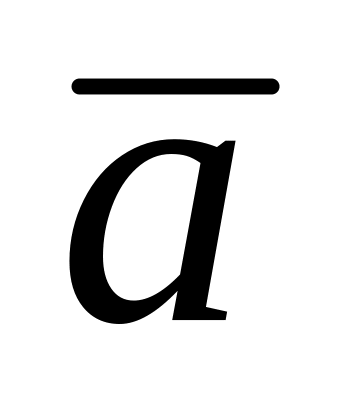
Среднее
значение для всех
этих случайных величин одно и то же —
 .
Среднеквадратическое
отклонение
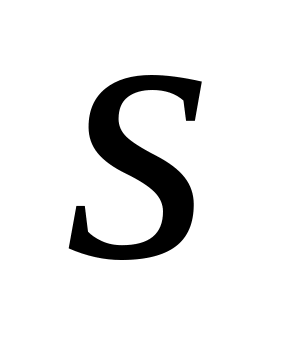 очевидно,
также естественно предположить
одним и тем же для всех измерений, так
как они
производятся в неизменных условиях.
Наконец,
мы считаем,
как обычно, величины
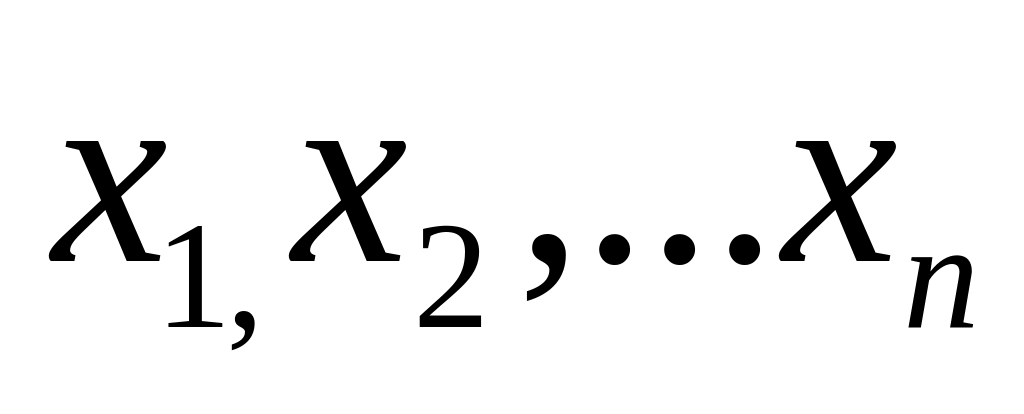 взаимно
независимыми.
Рассмотрим теперь среднее арифметическое
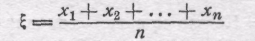
результатов п измерений. Это — случайная величина; найдём её среднее значение и среднеквадратическое отклонение. По правилу сложения
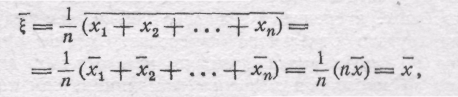
т. е. среднее значение, как это в сущности и ранее было очевидно, то же самое, что и для каждого отдельного измерения.
Далее,
среднеквадратическое отклонение суммы
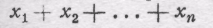 по
правилу сложения дисперсий равно
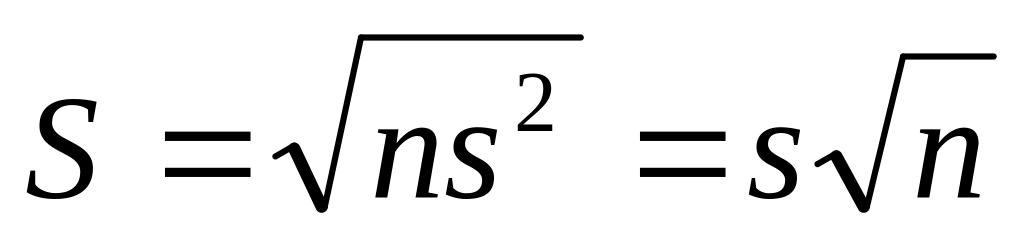
а
среднеквадратическое отклонение
величины
 составляющей
 этой
суммы, равно
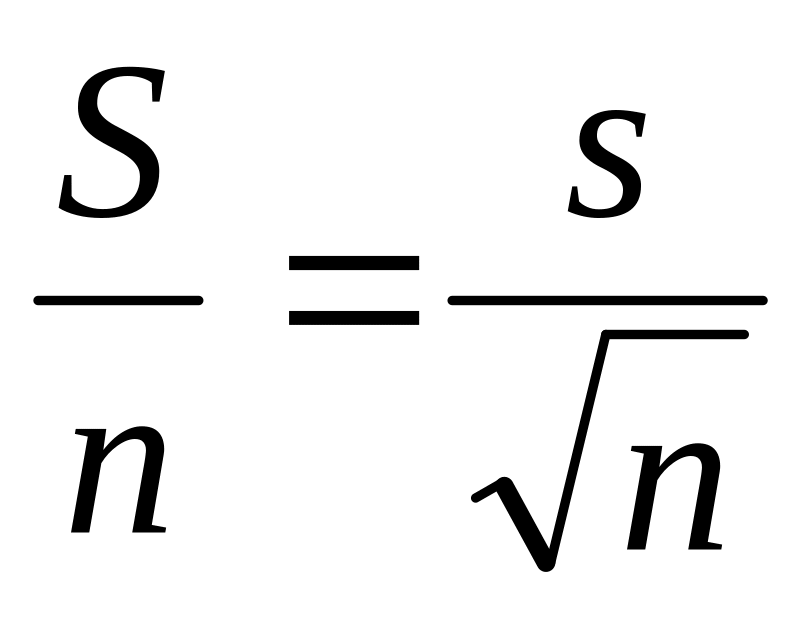
Мы приходим к очень важному результату: среднее арифметическое п взаимно независимых и одинаково распределённых случайных величин имеет:
а) среднее значение — то же самое, что и каждая из составляющих величин;
б) среднеквадратическое
отклонение —
в
 раз
меньшее,
чем каждая из составляющих величин.
Так,
если среднее значение измеряемой
величины
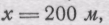 а
среднеквадратическое уклонение
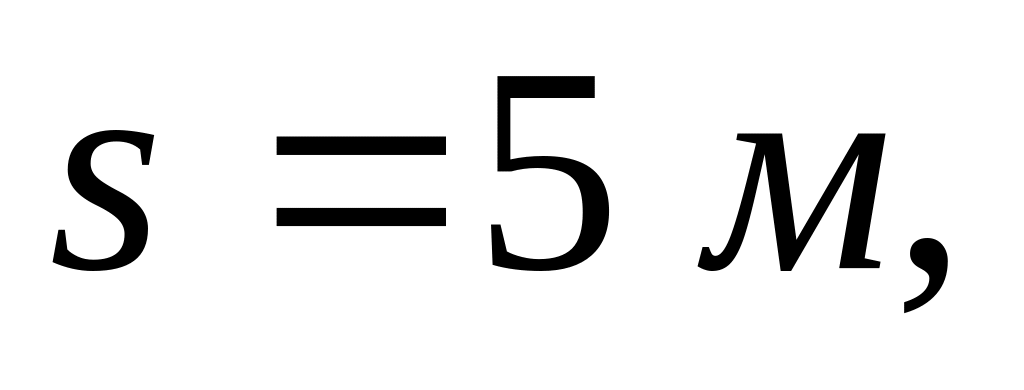 то
среднее арифметическое
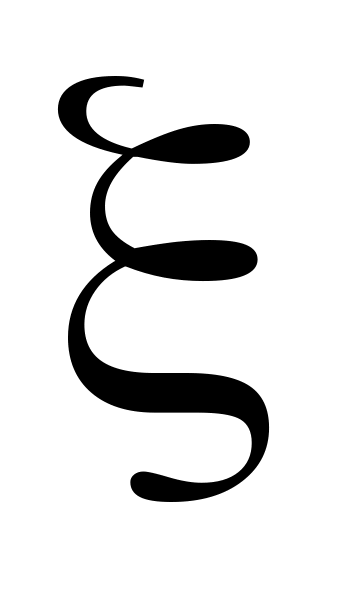 сотни результатов измерений будет,
конечно, иметь своим средним значением
то же число
 но
среднеквадратическое уклонение его
будет
в ]
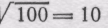 раз
меньше, чем для отдельного измерения,
т. е. будет составлять всего
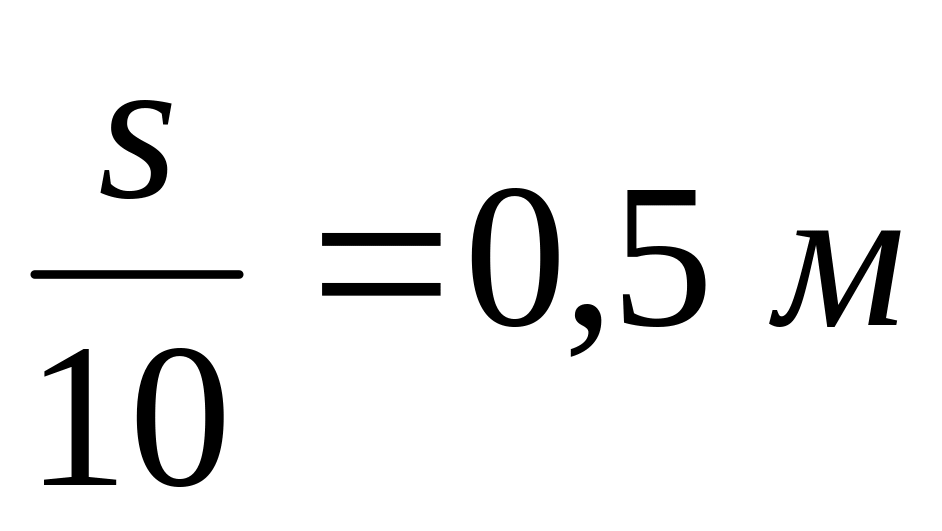 Таким
образом,
имеются основания ожидать, что среднее
арифметическое
сотни фактических результатов измерений
будет значительно
ближе к среднему значению 200 м,
чем
результат того
или другого отдельного измерения.
Среднее арифметическое большого числа взаимно независимых величин обладает во много раз меньшим рассеянием, чем каждая из этих величин в отдельности.
П. Л. Чебышевым (1821—1894) установлено, что при осреднении достаточно большого числа независимых и одинаково распределенных случайных величин, получим с вероятностью, как угодно близкой к единице, значение, сколь угодно мало отличающееся от общего математического ожидания величин.
Это доказательство, составляет частный, но важный случай так называемого «закона больших чисел».
Оно выражает основную и общую закономерность, имеющую первостепенное значение как для обоснования статистических методов, так и для теоретического объяснения большого круга явлений.
С особенной точностью проявляется нивелирующее действие закона больших чисел в области молекулярных процессов.
Движения и соударения отдельных молекул газа происходят хаотически. Каждая из них описывает весьма сложную и запутанную траекторию, так что не представляется возможным предсказать, где она будет находиться через определенный отрезок времени. Тем не менее, выделив на стенке сосуда площадку, мы обнаружим, что среднее число молекул газа, столкнувшихся со стенкой в данной площадке в данный отрезок времени, и средний импульс, переданный стенке при соударениях, будут вполне устойчивой величиной, определяющей упругость и давление газа.
…..Итак,
согласно ране сказанному среднее
арифметическое выборки
 как
среднее из независимых величин с одним
и тем же законом
 ,
будем иметь при любом
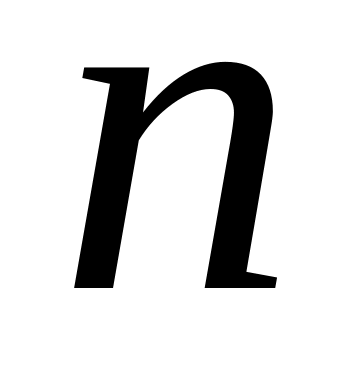 равно:
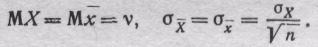
Согласно
закону больших чисел
 стремится
по вероятности к центру распределения
(математическому ожиданию)
 при
 и
может быть использована во многих
случаях как надлежащая оценка этого
параметра.
Выборочные оценки, сходящиеся по вероятностям к тому или иному параметру закона распределения, называются его состоятельными оценками.
Выборочные характеристики, обладающие тем свойством, что их математические ожидания при любом объеме выборки равны оцениваемому параметру, называются несмещенными оценками.
К сожалению, выражение выборочной дисперсии
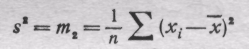
не является несмещенной оценкой.
Для представления выборочной дисперсии в виде несмещенной оценки ее можно представить в следующем виде: