Дипломная (вкр): Визначення ефективності рекламних кампаній
Нехай задані дві сукупності об’єктів X та Y, які мають тримірний (багатовимірний) нормальний закон розподілу з невідомими, але рівними коваріаційними матрицями.
Допустимо також, що з даних
сукупностей спостережень які характеризуються трьома показниками, взято дві
навчаючі вибірки відповідно обсягами n1 і n2:
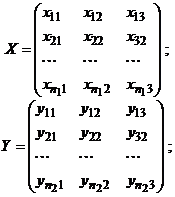 (2.24)
Метою дискримінантного
аналізу є віднесення довільного об’єкта (стрічки) із матриці Z
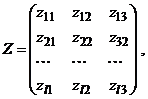 (2.25)
або до сукупності об’єктів Х, або до матриці Y.
Визначимо для матриць вхідних
даних X та Y оцінки векторів середніх значень  і
 та коваріаційних матриць Sx і Sy:
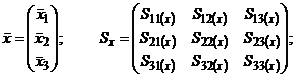 (2.26)
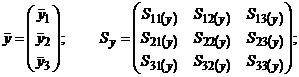 (2.27)
де 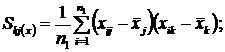
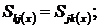
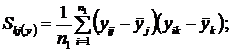
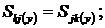
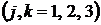
На основі середніх значень  і
коваріаційних матриць Sx та Sy розраховуємо незміщену оцінку сумарної
коваріаційної матриці
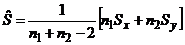 (2.28)
Для сумарної коваріаційної
матриці обчислюємо обернену матрицю S-1, за допомогою якої одержуємо вектор
оцінки коефіцієнтів дискримінантної функції
 (2.29)
Далі знаходимо оцінки
дискримінантної функції  та
 для матриць
вхідних даних X та Y:
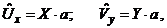
та їх середні значення:

Тоді межа дискримінації  визначається
за формулою:
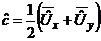 (2.30)
Оцінка дискримінантної функції
для v-ї стрічки матриці Z, яка характеризує v-й об’єкт, що підлягає
дискримінації, одержується за допомогою наступного виразу:
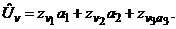 (2.31)
Якщо одержана за формулою
оцінка дискримінантної функції для v-гo об’єкту більша від межі дискримінації , тобто  >, то
досліджуваний об’єкт (v-тe спостереження) необхідно віднести до сукупності X.
Якщо ж <, то v-тe
спостереження (v-й об’єкт) віднесемо до сукупності Y.
В загальному випадку дискримінантний аналіз може мати більш як дві навчаючі вибірки. Коли дискримінація здійснюється на основі трьох і більше навчаючих вибірок, завдання віднесення досліджуваного об’єкта до однієї із заданих вибірок значно ускладнюється і не завжди є однозначним, тобто не всі об’єкти (стрічки) матриці Z вдається віднести до деякого класу.
Трапляються ситуації, коли
змінні не розділені на залежні і незалежні. Тоді використовують факторний
аналіз.
.5 Факторний аналіз
При дисперсійному, регресивному і дискримінантному аналізі одну змінну маркетологи часто ідентифікують як залежну. Тут же ми розглянемо як проводиться аналіз, при якому змінні не розділяються на залежні і незалежні.
Факторний аналіз - клас методів, що використовуються, головним чином, для скорочення кількості змінних і їх узагальнення.
В ході проведення маркетингового дослідження можна зіштовхнутися з багатьма змінними, більшість з яких взаємопов’язані. Для зручності обробки даних їх число належить знизити до бажаного рівня. Для цього зв’язки між корельованими змінними аналізують і виражають у вигляді невеликого числа факторів факторний аналіз - це метод аналізу взаємозалежності, оскільки в факторному аналізі перевіряються всі можливі варіанти взаємозалежних зв’язків.
Факторний аналіз використовують в наступних ситуаціях.
. Для визначення основних факторів, які пояснюють зв’язки в наборі змінних.
. Для визначення нового, меншого за розміром, набору некорелюючих змінних, які замінюють початковий набір корелюючи змінних, на основі якого дальше здійснюється багатомірний аналіз (регресійний чи дискримінантний).
. Для перетворення великого за розміром набору в менший, набір ясно виражених змінних для використання їх в подальшому багатомірному аналізі.
Факторний аналіз широко використовується в маркетингових дослідженнях.
. При сегментації ринку для визначення незалежних змінних з ціллю групування споживачів. Наприклад, покупців нових автомобілів можна згрупувати в залежності від того на що вони звертають увагу при купівлі автомобіля: економію, зручність, робочі характеристики авто, комфорт і поважність. В результаті отримують п’ять сегментів ринку: покупці, схильні до економії; покупці, шукаючі зручність; покупці, що прагнуть до певних робочих характеристик; покупці, що шукають комфортні авто; покупці, що шукають поважні автомобілі.
. При розробці товарної стратегії факторний аналіз використовується для визначення характеристик торгової марки, що впливають на вибір споживачів. Наприклад, конкретні торгові марки зубних паст оцінюють з точки зору захисту від карієсу, відбілювання зубів, смаку, приємного запаху і ціни.
. При розробці рекламної стратегії маркетологи з допомогою факторного аналізу намагаються зрозуміти, яким програмам віддають перевагу споживачі цільового ринку. Наприклад, покупці заморожених продуктів можуть дивитися кабельне телебачення, любити фільми відповідного жанру і музику в стилі "кантрі".
. При розробці стратегії ціноутворення факторний аналіз визначає характеристики споживачів, чутливих до ціни. Наприклад, може виявитись, що вони прагнуть до економії і орієнтовані на домашній відпочинок.
З математичної точки зору
факторний аналіз в деякій мірі аналогічний множинному регресійному аналізу в
тому значенні, що кожна змінна виражена як лінійна комбінація незалежних
факторів. Доля дисперсії окремої змінної, що належить загальним факторам (і
розділяється з іншими змінними) називається спільністю (загальністю). Коваріацію
серед змінних описують невеликим числом загальних факторів, плюс характерний
фактор для кожної змінної. Якщо змінні нормовані, то факторну модель можна
виразити наступним чином:
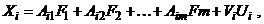 (2.32)
де Хі - і-а нормована змінна;
Аij - нормований коефіцієнт множинної регресії змінної і по загальному фактору і;і - загальний фактор;і - нормований коефіцієнт регресії змінної і по характерному фактору і.- характерний фактор для змінної і;- кількість загальних факторів.
Характерні фактори не
корелюють між собою і з загальними факторами, Загальні фактори в свою чергу
також можна виразити лінійними комбінаціями змінних:
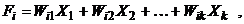
де Fi - оцінка і-го фактора; Wi - ваговий коефіцієнт; k - кількість змінних.
Початковим етапом виконання факторного аналізу є формулювання проблеми. Формулювання проблеми включає декілька завдань. Змінні задаються виходячи з попередніх досліджень і відповідно до думки дослідника. Важливо щоб змінні вимірювались в інтервальній або відносній шкалі. Вибірка повинна бути підходящого розміру. Досвід показує, що рекомендується брати вибірку, в крайньому разі, в чотири або в п’ять разів більшу, ніж число змінних. Часто при маркетингових дослідженнях розмір вибірки малий, і це відношення значно менше. В таких випадках слід обережно відноситись до інтерпретації результатів.
Якщо встановлено, що факторний аналіз підходить до аналізу даних, необхідно вибрати відповідний метод його виконання. Різні методи факторного аналізу розрізняють в залежності від підходів, що використовуються для виділення коефіцієнтів значень факторів. Одним із методів є метод головних компонент.
Розглянемо деяку матрицю X,
одержану в результаті спостережень, над n об’єктами, що характеризуються k
ознаками.
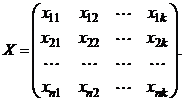 (2.33)
Сукупність спостережень, які утворюють матрицю (2.33), як правило корельовано між собою, що, в свою чергу, значно ускладнює використання регресійних моделей для їх аналізу. Отже, виникає необхідність визначення кількості реально незалежних ознак, що утворюють дану матрицю.
Суть компонентного аналізу (методу головних компонент) полягає в заміні системи k вхідних корельованих між собою факторів на k нових некорельованих показників (головних компонент).
Іншими словами, розглядається перетворення змінних X у нову множину попарно некорельованих змінних, серед яких перша відповідає напрямку максимально можливої дисперсії, друга - напрямку максимально можливої дисперсії в підпросторі, який ортогональний першому напрямку і т.д. таким чином, в одержаній системі головні компоненти будуть вже не лише некорельованими, але й впорядкованими за величиною їх дисперсій, причому перша головна компонента має найбільшу дисперсію, друга - трохи меншу і т.д., остання k-а компонента - найменшу дисперсію.
Розглянемо алгоритм методу головних компонент у випадку трьох факторних ознак.
Нехай задана деяка матриця
спостережень над n об’єктами
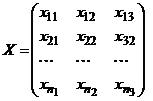 (2.34)
де хij (і = 1, 2, ..., n; j = 1, 2, 3) - значення спостереження j-ї ознаки для i-го об’єкта; n - обсяг вибірки (загальна кількість досліджуваних об’єктів).
Обчислимо основні статистичні
оцінки параметрів тримірного розподілу досліджуваної сукупності.
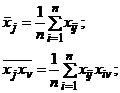
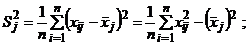 (2.35)
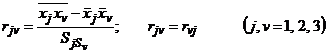
Тут  (j = 1, 2,
3) - середнє значення і дисперсія j-ї ознаки досліджуваної сукупності
спостережень; rjv (j, v = 1, 2, 3) - парний коефіцієнт кореляції між j-ю та v-ю
ознаками.
На основі (2.35) одержуємо
оцінку матриці парних коефіцієнтів кореляції.
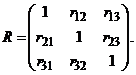 (2.36)
Перетворимо матрицю R в
діагональну матрицю λ власних значень характеристичного
многочлена |λЕ -
R|, який після відповідних обчислень набуває вигляду
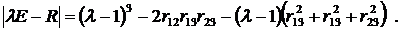
Введемо позначення: r = λ -
1. Одержуємо
неповне кубічне рівняння
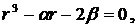 (2.37)
де 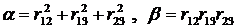 .
Розв’язок рівняння (2.37),
враховуючи виконання нерівності 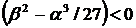 , буде мати вигляд
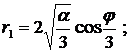
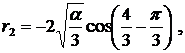 (2.38)
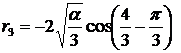
де 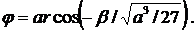
Звідки одержуємо власні
значення λj
= rj + 1 (j = 1, 2, 3), і причому а λ1
> λ2
> λ3
також
матриці власних значень
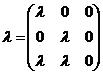 . (2.39)
Власні значення
характеризують вклади відповідних головних компонент у загальну (сумарну)
дисперсію вхідних факторних ознак x1, x2, x3. Перша головна компонента має
найбільший вплив на сумарну дисперсію, друга - менший, третя - найменший,
причому вклад j-ї головної компоненти визначається за формулою:

де, k = λ1 +
λ2 + λ3 = 3
Знайдемо тепер власний вектор Uj, який відповідає власному числу λj (j = 1, 2, 3)
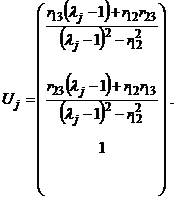 (2.40)
Знайдемо норму вектора
власних значень (2.40):
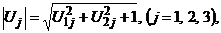
Тоді матриця V, що
складається із нормованих векторів:
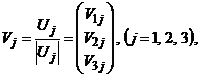
має вигляд:
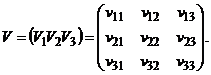 (2.41)
Матриця факторних навантажень
А одержується за формулою
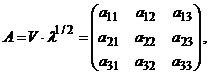 (2.42)
де λ1/2 - діагональна
матриця коренів із власних значень:
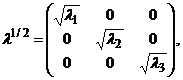
Елементами ajl матриці
факторних навантажень (2.42) є коефіцієнти парної кореляції, які вимірюють
тісноту зв’язку між fl-ю головною компонентою та xj-ю ознакою, при цьому мають
місце співвідношення:
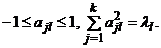
Матрицю факторних навантажень
(2.42) використовують для економічної інтерпретації головних компонент, які є
лінійними функціями вхідних факторів ознак, причому значення головних компонент
для кожного і-го об’єкта (і = 1, 2, ..., n) задаються матрицею F:
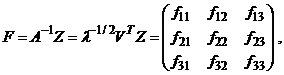 де
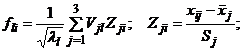 (і = 1, 2,
..., n; l = 1, 2, 3),
- матриця нормованих значень факторних ознак Xj (j = 1, 2, 3), fli - значення l-ї головної компоненти для і-го фактора.
Одержані значення головних компонент дають можливість провести класифікацію сукупності вихідних факторних ознак на певні групи, узагальненими показниками яких є головні компоненти. Внаслідок своєї ортогональності (незалежності) головні компоненти є дуже зручними для побудови на них рівнянь регресії, для яких відсутнє явище мультиколінеарності між головними компонентами. Для побудови рівнянь регресії на головних компонентах в якості вхідних даних необхідно взяти вектор результуючої змінної у, а замість матриці вхідних факторних ознак х - матрицю розрахованих значень головних компонент.
Отже, факторний аналіз - це
загальна назва класу методів, що використовуються, головним чином, для
скорочення кількості змінних і їх узагальнення. У наступному методі ми
розглянемо поділ об’єктів на групи, в якому також не проводять розбіжності між
залежними і незалежними змінними.
.6 Кластерний аналіз
З допомогою кластерного аналізу маркетологи перевіряють весь набір взаємозалежних зв’язків. В кластерному аналізі не проводять розбіжності між залежними і незалежними змінними. Навіть більше, перевіряються взаємозалежні зв’язки усього набору змінних.
Кластерний аналіз являє собою клас методів, які використовуються для класифікації об’єктів і подій в відносно однорідні групи, які називають кластерами (clusters). Об’єкти в кожному кластері повинні бути подібні між собою і відрізнятися від об’єктів в інших кластерах. Кластерний аналіз називають також класифікаційним аналізом (classification analysis) aбо числовою систематикою (numerical taxonomy).