Дипломная (вкр): Визначення ефективності рекламних кампаній
Математика дає інструменти аналізу інформації і навчає з їх допомогою давати правильні кількісні оцінки подіям і залежностям. Постановка будь-якої задачі починається з прийняття деякого припущення про об'єкт чи систему. Ступінь адекватності реальних даних цим припущенням визначає правильність зроблених нами висновків на основі результатів вирішення задачі. Причому існують математичні засоби, які дають можливість визначити, наскільки відхилення тих або інших даних впливають на достовірність результату.
Одержати достовірну і достатню для прийняття рішення інформацію дасть змогу відповідний механізм роботи з інформацією, тобто визначена послідовність процедур аналізу інформації та її використання. Один із таких механізмів [20] передбачає реалізацію наступних процедур:
Перевірка інформації. Найбільш надійний і поширений метод перевірки інформації - порівняльний аналіз, тобто одержання однозначної відповіді на одне й те саме питання з різних джерел. Якщо інформація не підтвердилася іншими джерелами чи були отримані суперечливі відомості, необхідно поставити під сумнів всю отриману інформацію і підтвердити або спростувати припущення про її помилковість. Неузгоджена інформація є неякісною і непридатною для прийняття рішення.
Обробка інформації. На цьому етапі за допомогою різних методів виконується аналіз інформації та синтезування висновку, тобто узагальнення, що пояснює всі встановлені факти. Щоб висновки та рекомендації були мотивовані, необхідно щоб з інформацією працював професіонал і щоб він був досить обережний, обґрунтовуючи свої рекомендації.
Відсіювання надлишкової інформації. Інформація не тільки полегшує і забезпечує швидке обґрунтоване прийняття рішень, а й, якщо вона є надлишковою, може паралізувати її аналіз. Прийняття рішення в такій ситуації досить сумнівне, бо виявити ключову інформацію досить складно, не кажучи вже про можливість отримання дезінформації. Одним із способів вирішення цієї проблеми є використання "фільтра" на вході сторонньої інформації, яку не запитували.
Отримання маркетингової інформації у потрібному виді передбачає використання для обробки первинної інформації різних математичних методів. Спектр цих методів є достатньо широким: від простих вибіркових досліджень до використання штучних нейронних мереж. Далі будуть розглянуті статистичні методи, які найбільш часто використовуються при проведенні маркетингових досліджень.
На вибір способу побудови статистичної системи суттєво впливає структурна особливість системи [9]. Найпростіший і найзручніший для аналізу варіант системи - сукупність великого обсягу однорідних елементів. Прояв неоднорідності може бути в одній із наступних форм:
- наявність у межах системи чітко розмежованих класів елементів;
- наявність в системі розмитих класів (відсутність чітких меж між класами, окремі елементи можуть бути віднесені до декількох класів);
наявність аномальних об'єктів, які мають своєрідні, нетипові для системи в цілому, умови функціонування.
Для кожної з цих форм існує свій, найбільш раціональний, спосіб побудови моделей.
Склад незалежних змінних моделі називають ознаковою множиною. Змінні включаються до моделі в результаті емпіричної перевірки їх впливу за допомогою статистичних критеріїв, при чому, як правило, виконується диференційна оцінка їх значимості. Процес вибору адекватної моделі має ітеративний характер і включає наступні етапи:
- із деякої множини допустимих моделей вибирається робоча модель;
- вибрана модель застосовується до наявних даних;
визначається ступінь відповідності моделі реальним даним.
Після опрацювання всіх допустимих моделей вибирається модель з найвищою ступінню відповідності реальним даним і здійснюється осмислення отриманих результатів. Якщо вони тлумачаться як негативні, то необхідно перейти до пошуку іншої множини допустимих моделей.
Практично в усіх маркетингових дослідженнях використовуються статистичні методи аналізу інформації, які можна розбити на наступні групи:
- вибірковий аналіз - дозволяє встановити характер розподілу показника, що аналізується, визначити оцінки його математичного сподівання та дисперсії;
- дисперсійний аналіз - використовується для виявлення впливу деякого фактора на певний економічний показник (наприклад, вплив реклами на обсяги продажу);
кореляційний аналіз - вивчає взаємодію та силу взаємозв'язку показників системи в процесі її функціонування;
регресійний аналіз - використовується для визначення залежності змінної від однієї чи декількох незалежних змінних (відповідно проста чи багатофакторна регресія);
дискримінантпний аналіз - використовується для визначення меж між заданими (існуючими) групами об'єктів за допомогою комбінації значень декількох незалежних змінних, що характеризують об'єкти, достатніх для розмежування груп та для віднесення будь-якого нового об'єкту до певної групи за його характеристиками;
факторний аналіз - використовується для дослідження взаємозв'язку між змінними з метою визначення найбільш впливових суттєвих факторів;
кластерний аналіз - використовується для об'єднання об'єктів у групи (кластери) так, щоб відмінності між об'єктами одного кластеру були меншими, ніж відмінності між об'єктами різних кластерів;
- аналіз
часових рядів - використовується для моделювання і прогнозування показників,
дані про які представлені в вигляді часових рядів, тобто послідовності залежних
значень цих показників. Необхідно відмітити, якщо метод обробки масиву, даних
отриманого в ході маркетингових досліджень, обрано правильно й обмежувальні
умови поставлені коректно, то уявлення підприємства про його зовнішнє
середовище (модель) відповідатиме дійсності. Розглянемо більш детально вказані
статистичні методи.
2.2 Вибірковий
аналіз
Перед тим, як розглянути методи вибіркового аналізу, приведемо визначення деяких важливих статистичних понять.
Генеральною сукупністю називають сукупність всіх уявних спостережень (або всіх уявно можливих об'єктів визначеного типу, з яких "знімаються" спостереження), які могли б бути виконані при даному реальному комплексі умов. Поняття генеральної сукупності є поняття абстрактне і його не потрібно змішувати з реальними сукупностями, які підлягають статистичному дослідженню. Генеральна сукупність називається скінченою або нескінченою, в залежності від того, скінчена чи нескінчена сукупність всіх уявних спостережень.
Вибірка із даної генеральної сукупності - це результати обмеженого ряду спостережень хх, х2, ...хп випадкової величини х. Вибірку можна розглядати як деякий емпіричний аналог генеральної сукупності. Кількість спостережень, які утворюють вибірку, називають об'ємом вибірки.
Одним із найважливіших питань, від успішного вирішення якого залежить достовірність отриманих в результаті статистичної обробки даних висновків, є питання репрезентативності вибірки, тобто питання повноти і адекватності представлення нею властивостей генеральної сукупності, які нас цікавлять. При оцінці репрезентативної вибірки враховується і те, як вибірка отримана, і те, наскільки розподіл в вибірці суттєвих показників є характерним для генеральної сукупності, що аналізується, в цілому.
Вибірковий аналіз включає так звані методи первинної обробки результатів спостережень, які забезпечують вирішення наступних основних задач:
- перевірка однорідності вибірки та незалежності результатів спостережень;
- ідентифікація закону розподілу вибіркової сукупності;
визначення раціонального об'єму вибірки в залежності від закону розподілу похибки спостережень.
Перевірка однорідності вибірки виконується з метою доведення, що всі результати спостережень належать до однієї генеральної сукупності. Для перевірки гіпотези про однорідність результатів спостережень використовують різні евристичні процедури, параметричні і непараметричні (рангові) критерії [2].
Приблизне уявлення
про однорідність результатів спостережень можна отримати по величині
вибіркового коефіцієнта варіації:
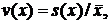 (2.1)
де 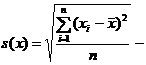 вибіркове
середньоквадратичне відхилення;
 вибіркове середнє значення; п -
об'єм вибірки.
Якщо  , де
 - табличне
середнє значення варіації [6], то вважається, що вибірка однорідна. В іншому
разі, тобто при
 , вибірка
вважається неоднорідною, з неї виключають крайні (екстремальні) значення, і для
зменшеної таким чином вибірки знову виконується перевірка гіпотези про
однорідність результатів спостережень і т. д.
Інша, більш сувора, процедура
перевірки на однорідність [3,5] передбачає виключення аномальних результатів
спостережень. Для цього із сукупності спостережень  вибирається
екстремальне (позначимо його х) і обчислюється статистика:
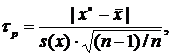 (2.2)
яка залежить від рівня
значимості  і кількості
ступенів свободи
 . Отримане
значення
 порівнюється
з табличним
 Якщо
 , то х
виключається з сукупності результатів спостережень і для зменшеної вибірки
знову повторюється описана процедура перевірки на однорідність.
В [2] наведений аналітичний
критерій одночасного виключення декількох екстремальних спостережень,
розроблений Г. Титьєном і Г. Муром. Він застосовується до варіаційного ряду
спостережень, тобто ряду, отриманого шляхом впорядкування результатів
спостережень по зростанню їх значень. Правило для виключення k найбільших
членів варіаційного ряду ґрунтується на статистиці:
 (2.3)
де  - середнє
перших п-k членів варіаційного ряду,
 - середнє по всій вибірці.
При наявності аномальних
спостережень статистика  буде меншою
від табличного критичного значення.
Якщо в вибірці можливі викиди
і вліво, і вправо, то в цьому випадку використовують наступну модифікацію
статистики (2.3):
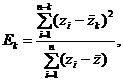 (2.4)
де  - елементи
варіаційного ряду абсолютних відхилень спостережень від середнього значення.
При перевірці однорідності
двох вибірок об'ємом  , і
 , які мають
нормальний розподіл, можна користуватися t-критерієм, згідно якого гіпотеза про
однорідність приймається при виконанні нерівності:
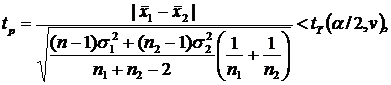 (2.5)
де  ,
 -
відповідно емпіричні середні і дисперсії вибірок; - рівень
значимості;
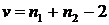 - кількість
ступенів свободи;
 - критичне
значення, визначається по таблицях t-розподілу для заданих і
 .
Якщо необхідно порівняти m
вибірок на однорідність дисперсії (наприклад, при оцінці однорідності
продукції), то рекомендується використовувати критерій Барлетта, згідно з яким
гіпотеза про рівність дисперсій порівнюваних вибірок приймається при
справедливості нерівності:
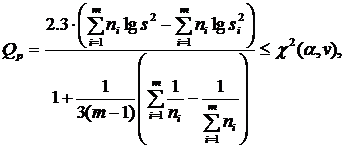 (2.6)
де 

 - вибіркові
дисперсії;
 - об'єми
вибірок; - рівень
значимості;
 - кількість
ступенів свободи;
 - значення
розподілу для заданих і .
У випадку, коли 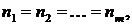 більш
доцільно для перевірки гіпотези про однорідність дисперсій вибірок, які
підлягають нормальному розподілу, використовувати зручніший і більш точний
критерій Кохрана. Гіпотеза про однорідність дисперсій по цьому критерію
відхиляється при справедливості нерівності:
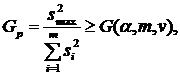 (2.7)
де  -
максимальна вибіркова дисперсія; - рівень значимості;
 - кількість
ступенів свободи;
 - критичне
значення, табульоване для різних значень , т і .
Щоб уникнути систематичної
похибки результатів моделювання, необхідно перед статистичною обробкою
вибіркової сукупності впевнитися в тому, що її можна розглядати як випадкову
вибірку з незалежними даними. Така ситуація виникає, наприклад, при побудові
багатофакторної регресійної моделі, коли необхідно впевнитися, що включені до
моделі вхідні показники є незалежними. Для перевірки незалежності спостережень
використовується декілька критеріїв: критерій  , ранговий критерій Спірмена,
ранговий критерій Кендалла [9,10]. Розглянемо використання найбільш поширеного
критерію Спірмена для перевірки гіпотези про незалежність показників х і у за
результатами спостережень
 і
 Позначимо
через
 ранг хі
серед елементів
 тобто номер
місця, яке займає величина
 в варіаційному ряді
 . Аналогічно
через
 позначимо
ранг уі серед елементів
 Вибірковий
коеффіцієнт рангової кореляції Спірмена має вигляд: