Дипломная (вкр): Визначення ефективності рекламних кампаній
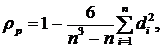 (2.8)
де 


Числове значення  лежить в
діапозоні
 , причому
при повній відповідності рангів (

 )
 , при протилежних рангах (

 і т.д.)

Гіпотеза про статистичну
незалежність показників х і у приймається, якщо справедлива нерівність:
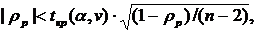
де  - рівень
значимості;
 - кількість
ступенів свободи;
 - критичне
значення, що знаходиться по таблиці критичних значень розподілу Ст'юдента при
заданих значеннях і
 .
При відсутності апріорної інформації про закон розподілу вибіркової сукупності спочатку перевіряється її належність до симетричного розподілу, а потім до нормального або іншого закону розподілу, який є найбільш прийнятним по природі випадковості досліджуваного процесу.
Для перевірки гіпотези про
симетричність розподілу необхідно побудувати інтервал довіри для невідомої
ймовірності подій  по
обчисленій частоті. Гіпотеза не відхиляється, якщо при ймовірності довіри
 значення
ймовірності появи події в одиничному випробуванні р = 0,5 попадає в інтервал
довіри:
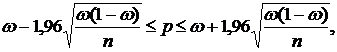 (2.9)
де  - вибіркове
значення частоти.
Для ідентифікації закону
розподілу результатів спостережень розроблена значна кількість статистичних
критеріїв згоди, із яких найбільш часто використовуються критерій  Пірсона,
критерій Колмогорова-Смирнова, критерій
 Крамера-Мізеса-Смирнова. Критерії
згоди призначені для перевірки гіпотези:
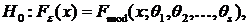 (2.10)
і ґрунтуються на використанні
різних мір відстані між досліджуваною емпіричною функцією розподілу  (яка
визначається по вибірці) і гіпотетичною модельною
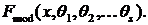 .
На практиці дуже часто перед
тим, як використовувати той чи інший критерій згоди, доцільно отримати
приблизне уявлення про відповідність емпіричного і модельного розподілів шляхом
використання показників асиметрії  і ексцесу
 , які
обчислюються за формулами:
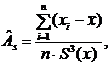 (2.11)
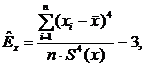 (2.12)
де  - середнє
значення вибірки;
 - середнє
квадратичне відхилення.
Емпіричний розподіл
узгоджується з теоретичним при умові, що вибіркові коефіцієнти асиметрії і
ексцесу відрізняються по модулю від своїх математичних сподівань не більше, ніж
на потроєні середні квадратичні відхилення, які можна визначити по формулах
[10]:
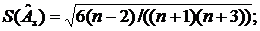 (2.13)
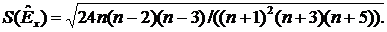 (2.14)
Тобто, для прийняття гіпотези
Но необхідно, щоб одночасно виконувались наступні нерівності:
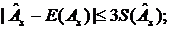
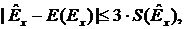 (2.15)
де  - оператор
математичного сподівання.
Для нормального розподілу  і
 , тому
(2.15) приймає вигляд:
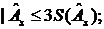
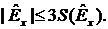
Критерій згоди Пірсона дозволяє
виконувати перевірку гіпотези (2.10) в умовах, коли значення параметрів  модельної
функції розподілу невідомі. Для прийняття гіпотези Но необхідно виконання
відношення:
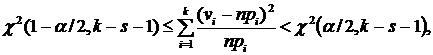 (2.16)
де n - об'єм вибірки; k -
кількість інтервалів групування спостережень 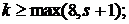
 - кількість параметрів модельного
закону розподілу;
 - кількість
спостережень, які попали в і-й інтервал;
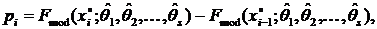
де  - вибіркові
оцінки параметрів модельного закону розподілу, а
 - правий і лівий кінці і-го
інтервалу групування; - рівень
значимості;
 - кількість
ступенів свободи;
 - табличне
значення - розподілу
для рівня значимості
 і кількості
ступенів свободи .
Критерій згоди
Колмогорова-Смирнова дозволяє виконувати перевірку гіпотези (2.10) в умовах,
коли модельна функція 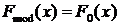 відома
повністю, тобто не залежить від невідомих параметрів.
Позначимо через  - емпіричну
функцію розподілу. Введемо наступні міри відстані між функціями і
 :
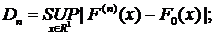
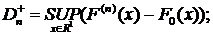 (2.17)
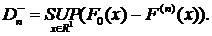
Статистика  є
статистикою критерію Колмогорова, а статистика - статистикою критерію Смирнова.
Очевидно, що
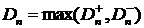 .
На практиці статистики
Колмогорова-Смирнова використовуються в вигляді [2]:
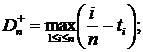
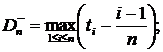 (2.18)
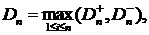
де  - значення
гіпотетичної функції розподілу в і-й позиції варіаційного ряду.
Для статистик 
 і
 відомі точні
закони розподілу [16].
Гіпотеза (2.10) приймається, якщо обчислене значення статистики менше значення відповідної процентилі закону розподілу статистики для заданого рівня значимості.
Статистикою критерія (Крамера-Мізеса-Смирнова)
є величина:
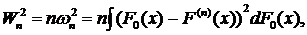 (2.19)
для обчислення якої на
практиці використовують наступну залежність [2]:
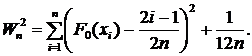
В разі справедливості
гіпотези  функція
розподілу статистики
 збігається
при
 до
граничного розподілу
 , таблиця
якого наведена в [16].
Мінімальний об'єм вибірки п,
необхідний для оцінювання параметрів багатофакторної моделі залежить від
кількості апріорної інформації про властивості досліджуваного процесу (І),
структурних особливостей моделі (S), необхідної точності оцінювання ( ), кількості
невідомих параметрів моделі (m), ймовірності довіри (1-),
коефіцієнта множинної кореляції результатів спостережень (R) і в загальному
вигляді може бути представлений співвідношенням [1]:
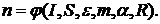 (2.20)
В залежності від кількості апріорної інформації в [13] наведені різні формули для обчислення n, які базуються на використанні нерівності Чебишева, та надані результати їх дослідження. Наведемо деякі із них, що представляють найбільший практичний інтерес.
В припущенні приналежності
вибіркових значень генеральній сукупності мінімальний об'єм вибірки п, що
забезпечує задану точність моделювання , визначається із співвідношення:
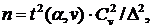 (2.21)
де  -
статистика, яка при = 0,05 має
наступні значення: 4,46 - для довільного закону розподілу; 2,96 - для
унімодального симетричного закону розподілу; 1,96 - для нормального закону
розподілу;

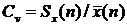 - вибіркова
оцінка коефіцієнта варіації;
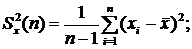
 - відносна похибка; - задана
похибка оцінки математичного сподівання х, тобто
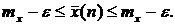
Якщо структура математичної
моделі представлена рівнянням лінійної багатофакторної моделі з т оцінюваними
параметрами при допустимій точності і коефіцієнті множинної кореляції  , то
мінімальний об'єм вибірки можна визначити із співвідношення [14]:
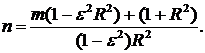 (2.22)
При повній апріорній
невизначеності відносно властивостей досліджуваного процесу і структури моделі
прийнято вважати, що
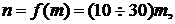 (2.23)
тобто об'єм вибірки повинен в
10 30 раз
перебільшувати кількість оцінюючих параметрів.
.3 Кореляційно-регресійний
аналіз
Регресійний аналіз - це потужний і гнучкий метод встановлення форми і вивчення зв’язків між залежною змінною і одною чи декількома незалежними змінними. Якщо ми маємо справу лише з однією незалежною змінною, то вивчати її слід за допомогою парної регресії. Парна регресія (bivariate regression) - це метод встановлення математичної (в формі рівняння) залежності між одною залежною змінною і одною незалежною змінною.
Залежність між двома змінними буває функціональною або кореляційною. Залежність між двома змінними називається функціональною, якщо кожному значенню незалежної змінної відповідає єдине значення залежної змінної. Кореляційним вважається зв’язок, при якому при зміні незалежної ознаки, змінюється середнє значення залежної ознаки. Причому при кореляційній залежності одному значенню незалежної змінної відповідає не одне, а декілька значень залежної змінної.
Кореляційним і регресійним аналізом називається сукупність математичних методів, за допомогою яких досліджуються і узагальнюються взаємозв’язки кореляційно зв’язаних змінних. Зокрема, методами кореляційно-регресійного аналізу розв’язуються два основні завдання:
1) знаходження загальної закономірності, яка характеризує залежність двох кореляційно зв’язаних змінних, тобто розробка математичної моделі зв’язку;
2) вивчення тісноти зв’язку.
Для розрахунку на
ПК параметрів парної і множинної регресії за методом найменших квадратів (МНК),
а також оцінки тісноти та значимості зв’язку між змінними при проведенні
дисперсійного (кореляційного) аналізу використовуються пакети прикладних
програм EXCEL.
2.4 Дискримінантний аналіз
Дискримінантний аналіз (discriminant analysis) використовується для аналізу даних в тому випадку, коли залежна змінна категоріальна, а незалежні змінні інтервальні.
Наприклад, залежна змінна може бути вибором торгової марки персонального комп’ютера (торгові марки А, В, С), а незалежними змінними можуть бути рейтинги властивостей персональних комп’ютерів, виміряні по семибальній шкалі Лайкерта. Цілі дискримінантного аналізу полягають в наступному:
. Визначення дискримінантних функцій чи лінійних комбінацій незалежних змінних, які найкращим чином розрізняють (дискримінують) категорії залежної змінної.
. Перевірка існування між групами значних відмінностей з точки зору незалежних змінних.
. Визначення незалежних змінних, які вносять найбільший вклад в між групові відмінності.
. Віднесення випадків до одної з груп (класифікація), виходячи зі значень незалежних змінних.
. Оцінка точності класифікації даних на групи.
Перший крок дискримінантного аналізу полягає у формулюванні проблеми шляхом визначення цілей, залежної змінної і незалежних змінних. Залежна змінна повинна складатися з двох чи більше взаємовичерпуючих категорій. Якщо залежна змінна виміряна з допомогою інтервальної чи відносної шкали, то її необхідно, в першу чергу, перевести в статус категоріальної. Наприклад, відношення до торгової марки, виміряне по семибальній шкалі, можна виразити як негативне (1, 2, 3), нейтральне (4) і позитивне (5, 6, 7). Незалежні змінні слід вибирати, виходячи з теоретичної моделі чи раніше проведеного дослідження, чи, у випадку пошукового дослідження, з інтуїції і досвіду дослідника.
Під класифікацією надалі будемо розуміти розподіл досліджуваної сукупності об’єктів чи явищ на однорідні в певному розумінні групи.
На практиці класифікація буває двох типів: класифікація із навчаючою вибіркою (дискримінантний аналіз) і класифікація без навчаючої вибірки (кластерний аналіз).
В даному розділі розглянемо більш докладно класифікацію першого типу.
Припустимо, що існують дві чи більше множини об’єктів, які характеризуються відповідними вибірками. Завдання дискримінантного аналізу полягає в побудові за допомогою даних навчаючих вибіркових спостережень правила, яке дає можливість віднести будь-який новий об’єкт до однієї із заданих множин.