Материал: Телекоммуникационные системы и сети - КНИГА
СОДЕРЖАНИЕ
Часть I. Способы передачи сообщений
1.1 Спектры периодических сигналов
1.2. Спектры непериодических сигналов
1.3. Сигналы электросвязи и их спектры
2.1. Принципы передачи сигналов электросвязи
3.1. Понятие о цифровых сигналах
3.2. Дискретизация аналоговых сигналов
3.3. Квантование и кодирование
3.4. Восстановление аналоговых сигналов
Глава 4. Принципы многоканальной передачи
4.1. Одновременная передача сообщений
4.2. Частотное разделение каналов
4.3. Временное разделение каналов
Глава 5. Цифровые системы передачи
5.1. Формирование группового сигнала
6.3. Регенерация цифровых сигналов
5.4. Помехоустойчивое кодирование
6.1. Плезиохронная цифровая иерархия
6.2. Синхронная цифровая иерархия
7.3. Волоконно-оптические кабельные линии
8.1. Предпосылки создания транспортных сетей
8.2. Системы передачи для транспортной сети
Vc низшего порядка (Low order vc, lovc)
Vc высшего порядка (High order vc, hovc)
8.3. Модели транспортных сетей
8.4. Элементы транспортной сети
8.5. Архитектура транспортных сетей
Часть II. Службы электросвязи. Телефонные службы и службы документальной электросвязи
Глава 9. Основные понятия и определения
9.1. Информация, сообщения, сигналы
9.2. Системы и сети электросвязи
9.3. Эталонная модель взаимосвязи открытых систем
9.4. Методы коммутации в сетях электросвязи
9.5 Методы маршрутизации в сетях электросвязи
Т а б л и ц а 9.2. Устройства, реализующие функции маршрутизации
10.1. Услуги, предоставляемые общегосударственной системой автоматизированной телефонной связи
10.3. Расчет коммутационного узла с коммутацией каналов 10.3.1. Модель коммутационного узла
10.3.1 Модель коммутационного узла
10.3.2. Структура коммутационных полей станций и узлов
10.3.3. Элементы теории телетрафика
11.2. Направления развития телеграфной связи
Глава 12. Службы пд. Защита от ошибок и преобразование сигналов
12.2. Сигналы и виды модуляции, используемые в современных модемах
13.1. Компьютеры — архитектура и возможности
13.2. Принципы построения компьютерных сетей
13.3. Международные стандарты на аппаратные и программные средства компьютерных сетей
13.4. Сетевые операционные системы
13.5. Локальные компьютерные сети
13.6. Глобальные компьютерные сети
13.7. Телефонная связь по компьютерным сетям
14.1. Основы факсимильной связи
14.2. Организация факсимильной связи
Глава 15. Другие службы документальной электросвязи
Глава 16. Единая система документальной электросвязи
16.1. Интеграция услуг документальной электросвязи [1]
16.2. Назначение и основные принципы построения служб обработки сообщений [2]
16.3. Многофункциональные терминалы
Глава 17. Обеспечение информационной безопасности в телекоммуникационных системах
17.2. Правовые и организационные аспекты информационной безопасности
17.3. Технические аспекты информационной безопасности
Часть III. Интеграция сетей и служб электросвязи
Глава 18. Узкополосные цифровые сети интегрального обслуживания (у-цсио)
18.1. Пути перехода к узкополосной цифровой сети интегрального обслуживания
18.2. Службы и услуги узкополосной цсио
18.3. Система управления у-цсио
Глава 19. Широкополосные и интеллектуальные сети
19.1. Условия и этапы перехода к широкополосной сети интегрального обслуживания (ш-цсио)
19.3. Способы коммутации в ш-цсио
19.4. Построение коммутационных полей станций ш-цсио
19.5. Причины и условия перехода к интеллектуальной сети (ис)
Глава 20. Система межстанционной сигнализации по общему каналу в цсио
20.1. Понятие об общем канале сигнализации
20.2. Протоколы системы сигнализации № 7 itu-t
20.3. Способы защиты от ошибок в окс № 7
20.5. Способы построения сигнальной сети
Глава 21. Широкополосные сети и оборудование компании «Huawei Technologies Co, Ltd»
21.1. Оптическая сеть абонентского доступа с интеграцией услуг honet
21.2. Построение транспортных сетей на базе оборудования компании «Huawei Technologies Co., Ltd»
21.3. Цифровая коммутационная система с программным управлением с&с08
21.4. Высокоскоростной коммутирующий маршрутизатор Radium 8750
Часть IV. Современные методы управления в телекоммуникациях
22.1. Многоуровневое представление задач управления телекоммуникациями
22.2. Функциональные группы задач управления
Глава 23. Интегрированные информационные системы управления предприятиями электросвязи
23.1. Понятия и определения в области информационных систем управления предприятием
Глава 24. Управление услугами. Качество предоставляемых услуг
24.1. Система качества услуг электросвязи
24.2. Базовые составляющие обеспечения качества услуги
24.3. Оценка качества услуг связи с точки зрения пользователя и оператора связи
Глава 25. Управление услугами.
25.3. Централизованный способ построения системы расчетов
25.4. Интеграция аср с системами управления tmn
25.5. Основные технические требования для аср
25.6. Обзор автоматизированных систем расчетов
Глава 26. Управление сетями и сетевыми элементами
26.1. Архитектура систем управления сетями и сетевыми элементами
26.2. Системы управления первичными и вторичными сетями
26.3. Принципы построения системы управления
Глава 27. Решения компании strom telecom в области tmn (Foris oss)
27.1. Общая характеристика семейства продуктов Foris oss
27.2. Автоматизация расчетов. Подсистема TelBill
27.3. Многофункциональные подсистемы сбора данных и взаимодействия с атс
27.4. Подсистема сбора данных и их биллинговой предобработки TelCharge
27.5. Подсистемы TelRes, TelTe, TelRc
27.6. Система «Электронный замок»
27.7. Подсистема поддержки клиентов tccs (Foris Customer Care Systems)
Более эффективно используются дискретные каналы при применении корректирующих кодов. В однонаправленных системах это должны быть коды, исправляющие ошибки. Широкое распространение на практике получили двоичные корректирующие коды, т.е. коды, при формировании которых используются только два типа элементов: 0 и 1. Только такие коды и будут рассматриваться в данной главе.
Построение корректирующих кодов. Каждому символу исходного алфавита сообщений объема Nа поставим в соответствие n-элементную двоичную последовательность - кодовую комбинацию. Возможное (общее) число последовательностей длины n составляет N0 = 2n, причем должно соблюдаться условие N0 > Nа.
Если N0 = Nа, то все возможные последовательности n-элементного кода используются для передачи или, как говорят, являются разрешенными. Полученный таким образом код называется простым.
Пример 12.1. Для передачи сообщений, число которых равно восьми (Nа = 8), используется трехэлементный код. Число кодовых комбинаций, которое можно при этом получить, N0 = 23 = 8. Из табл. 12.1 видно, что комбинация под номером 0 отличается от комбинации 1 только в одной позиции. Следовательно, если при передаче комбинации 000 произойдет ошибка в третьем элементе, то получим комбинацию 001.
Степень различия комбинаций определяется расстоянием Хемминга d. Это расстояние для любых двух кодовых комбинаций определяется числом несовпадающих в них разрядов. Например, две ниже написанные друг под другом комбинации не совпадают в двух разрядах:
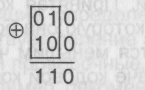
поэтому
расстояние Хемминга d
= 2. Иначе
его определяют как вес суммы по модулю
два ( - условное обозначение суммы) этих
кодовых комбинаций. Весом
W
кодовой
комбинации называется число входящих
в нее ненулевых элементов.
Таблица 12.1. Кодовые комбинации трехэлементного кода
|
Номер комбинации |
0 |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
|
Вид комбинации |
000 |
001 |
010 |
011 |
100 |
101 |
110 |
111 |
Перебрав все возможные пары кодовых комбинаций, можно найти минимальное хеммингово расстояние, которое принято называть кодовым и обозначать d0. Для примера 12.1 кодовое расстояние d0 = 1. Рассмотренный в примере код простой. Любая ошибка (даже одиночная!) при использовании такого кода приведет к тому, что переданная разрешенная кодовая комбинация перейдет в другую разрешенную. Таким образом, простой код не способен обнаруживать и тем более исправлять ошибки и имеет d0 = 1.
Для того чтобы код мог обнаруживать ошибки, необходимо, чтобы соблюдалось неравенство Na < N0. При этом неиспользуемые л-эле-ментные кодовые комбинации, число которых (N0 - Nа), будем называть запрещенными. Они определяют избыточность кода. Очевидно, что появление ошибки в кодовой комбинации будет обнаружено, если переданная разрешенная комбинация перейдет в одну из запрещенных. В качестве Nр = Nа разрешенных кодовых комбинаций надо выбирать такие, которые максимально отличаются друг от друга.
Пример 12.2. Алфавит передаваемых сообщений Nа = 2. Выберем из числа комбинаций, представленных в табл. 12.1, две. Очевидно, что ими должны быть комбинации 000, 111 или 001 и 110 и т.д. Кодовое расстояние d0 = 3. Ошибки кратности один или два превращают любую разрешенную кодовую комбинацию в запрещенную. Следовательно, максимальная кратность обнаруживаемых таким образом ошибок равна двум (tо.ош = 2).
Нетрудно догадаться, что минимальное кодовое расстояние d0 и гарантированно обнаруживаемая кратность ошибок связаны соотношением tо.ош = d0 - 1.
Исправление ошибок возможно также только в том случае, если переданная разрешенная кодовая комбинация переходит в запрещенную. Вывод о том, какая кодовая комбинация передавалась, делается на основании сравнения принятой запрещенной комбинации со всеми разрешенными. Принятая комбинация отождествляется с той из разрешенных, на которую она больше всего похожа, т.е. с той, от которой она отличается меньшим числом элементов. Так, если в примере 12.2 при передаче кодовой комбинации 000 получим 001, то вынесем решение, что передавалась кодовая комбинация 000.
Связь между d0 и кратностью исправляемых ошибок определяется выражением tи.ош = (d0/2) - 1 для четного d0 и tи.ош = = (d0 - 1)/2 для нечетного d0.
Итак, задача получения кода с заданной корректирующей способностью сводится к задаче выбора (путем перебора) из N0 = 2n кодовых комбинаций Nа комбинаций с требуемым кодовым расстоянием d0. Если л достаточно мало, то такой перебор не представляет особого труда. При больших n перебор может оказаться непосильным даже для современной ЭВМ, поэтому на практике используют методы построения кодов, не требующие перебора с целью получения кода с заданным d0 и отличающиеся невысокой сложностью реализации.
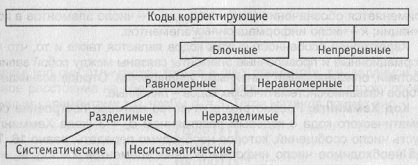
Рис. 12.1. Классификация корректирующих кодов
Классификация корректирующих кодов. Помехоустойчивые или корректирующие коды (рис. 12.1) делятся на блочные и непрерывные. К блочным относятся коды, в которых каждому символу алфавита сообщений соответствует блок (кодовая комбинация) из n(i) элементов, где i - номер сообщения. Если n(i) = n, т.е. длина блока постоянна и не зависит от номера сообщения, то код называется равномерным. Такие коды чаще применяются на практике. Если длина блока зависит от номера сообщения, то блочный код называется неравномерным. Примером неравномерного кода служит код Морзе. В непрерывных кодах передаваемая информационная последовательность не разделяется на блоки, а проверочные элементы размещаются в определенном порядке между информационными. (Проверочные элементы в отличие от информационных, относящихся к исходной последовательности, служат для обнаружения и исправления ошибок и формируются по определенным правилам).
Равномерные блочные коды делятся на разделимые и неразделимые. В разделимых кодах элементы разделяются на информационные и проверочные, занимающие определенные места в кодовой комбинации, во-вторых, отсутствует деление элементов кодовых комбинаций на информационные и проверочные. К последним относится код с постоянным весом, например рекомендованный Международным консультативным комитетом по телефонии и телеграфии (МККТТ), семиэлементный телеграфный код № 3 с весом каждой кодовой комбинации, равным трем.
Примерами систематических кодов являются коды Хемминга и циклические. Последние реализуются наиболее просто, что и привело к их широкому использованию в УЗО. Для систематического кода применяется обозначение (n, k) - код, где n - число элементов в комбинации; k- число информационных элементов.
Характерной особенностью этих кодов является также и то, что информационные и проверочные элементы связаны между собой зависимостями, описываемыми линейными уравнениями. Отсюда возникает и второе название систематических кодов - линейные.
Код Хемминга. Рассмотрим в качестве примера построение систематического кода с кодовым расстоянием d0 = 3 (кода Хемминга). Пусть число сообщений, которое необходимо передать, равно 16. Тогда необходимое число информационных элементов k= log2Na = 4. Можно выписать все 16 кодовых комбинаций, включая нулевую (0000). Это один из возможных способов задания исходного (простого) кода. Другой способ заключается в выписывании только четырех кодовых комбинаций простого кода в виде матрицы, называемой единичной:
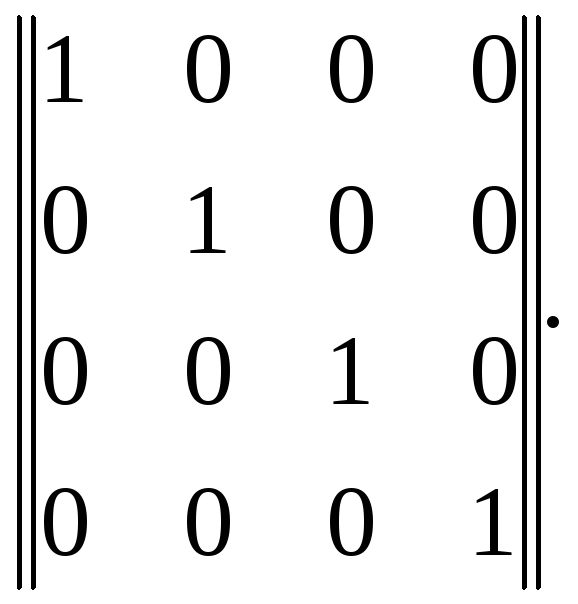 (12.1)
Суммируя
по модулю два в различном сочетании
кодовые комбинации, входящие в
единичную матрицу, можно получить 15
кодовых комбинаций, 16-я - нулевая. Кодовые
комбинации, составляющие матрицу (12.1),
линейно независимы. Можно было бы
составить матрицу и из других кодовых
комбинаций (лишь бы они были линейно
независимыми). Ненулевые комбинации
A1,
A2,
A3,
A4
линейно независимые, если
 ,
где
 при условии, что хотя бы один из
коэффициентов
 .
Дополним каждую кодовую комбинацию
в (12.1) проверочными элементами так, чтобы
обеспечивалось d0
= 3. Будем иметь в виду также тот факт,
что к числу разрешенных комбинаций
корректирующего кода принадлежит и
комбинация 0000 ... 0, называемая нулевой.
Очевидно,
что в числе добавляемых проверочных
элементов должно быть не менее двух
единиц. Тогда общее число единиц в каждой
комбинации кода получим не меньше
трех и комбинации, полученные нами,
будут отличаться от нулевой, по
крайней мере, в трех элементах. Добавим
по две единицы к каждой строке матрицы
(12.1):
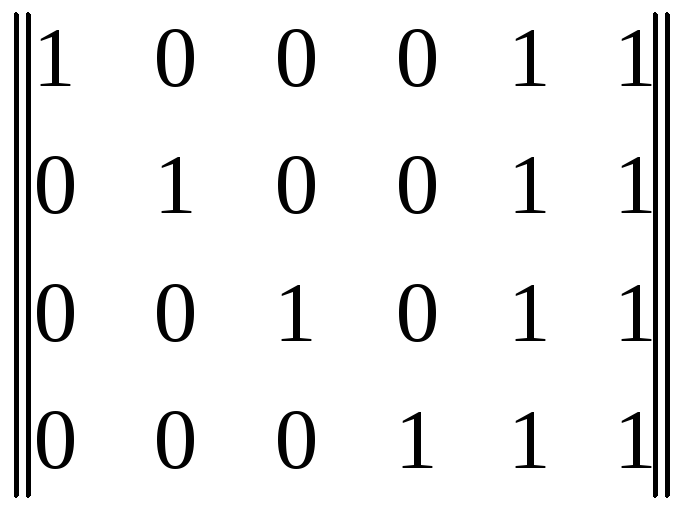 .
(12.2)
Складывая строки 1 и 2 матрицы (12.2) по модулю два
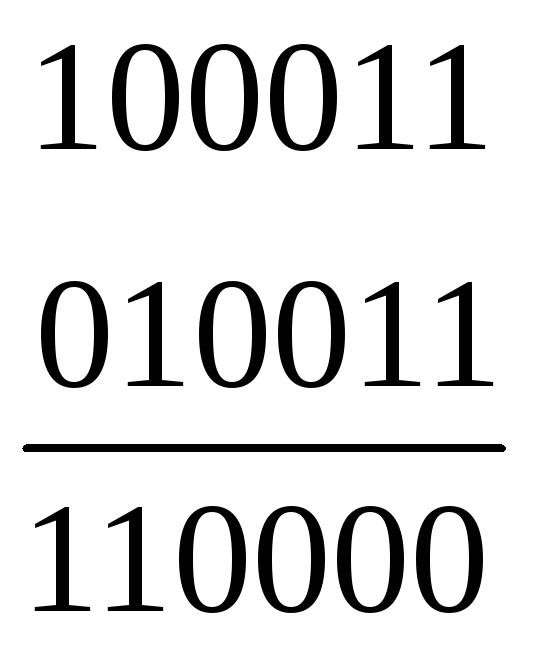
видим, что они отличаются только в двух элементах, т.е. заданное кодовое расстояние не обеспечивается. Дополним каждую строку проверочными элементами так, чтобы d0 = 3. Тогда матрица примет вид
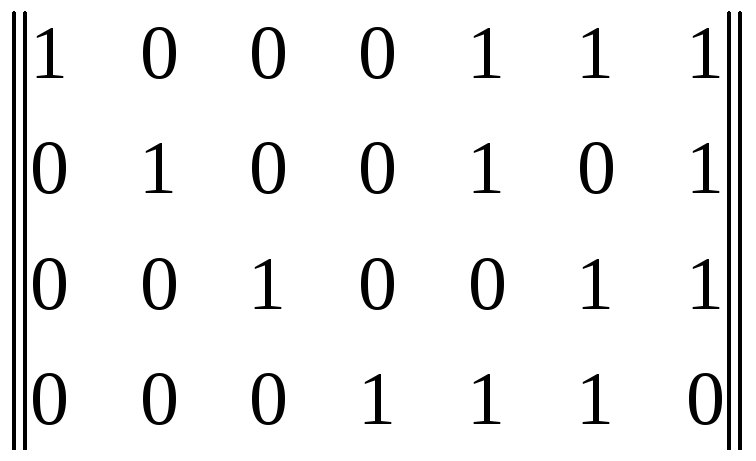 .
(12.3)
Добавляемые проверочные элементы могут быть записаны и в другом порядке. Необходимо лишь обеспечить d0 = 3.
Матрицу (12.3) называют производящей, или порождающей, матрицей кода (7,4), содержащего семь элементов, из которых четыре информационных. Обычно матрицу обозначают буквой G с индексом, указывающим, к какому коду она относится (в нашем случае G(7,4)). Производящая матрица состоит из двух матриц - единичной (размерности k x k) и С(r,k), содержащей r столбцов и k строк. Суммируя в различном сочетании строки матрицы (12.3), получаем все (кроме нулевой) комбинации корректирующего кода с d0 = 3.
Обозначим элементы комбинации полученного семиэлементного кода а1, а2, а3, а4, а5, а6, а7, из которых а1, а2, а3, а4 - информационные и а5, а6, а7 - проверочные. Последние могут быть получены путем суммирования по модулю два определенных информационных элементов. Разумеется, правило формирования проверочного элемента аi для любой кодовой комбинации одинаково.
Найдем правило формирования элемента а5, пользуясь матрицей (12.3). Из первой строки следует, что в суммировании должен обязательно участвовать элемент а1 (только в этом случае а5 = 1), из второй - что элемент а3 в суммировании не должен участвовать, а из четвертой - что элемент а4 должен участвовать в суммировании. Итак,
 .
(12.4)
Уравнения для а6 и а7 по аналогии записываются в виде:
 ,
(12.5)
 (12.6)