Материал: Математическое моделирование в экологии
СОДЕРЖАНИЕ
Математическое моделирование элементов сложных экологических систем
Лекция 1. Введение в моделирование. Исторический экскурс.
1. Основы моделирования в экологии 1.1. Общие принципы построения моделей в экологии
2.2. Этапы построения математической модели
1.4. Элементы теории подобия, применяемые в моделировании
3.2.2. Выборочный метод в экологометрике.
Зависимость числа интервалов от объема выборки
Статистический ряд по интервалам
Лекция 4. Статистические оценки параметров распределения случайных величин по выборкам
4.4. Статистические оценки гипотез об экологических моделях
Выборка из генеральной совокупности
Статистическая таблица эксперимента
Пример преобразования членов уравнения регрессии
Вычисление данных для линеаризации уравнения регрессии
Нормальные уравнения мнк для некоторых функций
Статистическое оценивание уравнения регрессии и парной корреляции.
Обработка результатов наблюдений
Рекомендации по выбору вида функции
3.4. Динамические статистические модели
Данные по объему сброса качественных сточных вод
Данные по объему сброса сточных вод за 5-летие
Пример расчета 5-летних средних
Расчетные значения для определения уравнения динамики
Ряд динамики для определения сезонных колебаний
Эксперименталъный материал исследования
8.1. Анализ влияния отдельных факторов в экологической модели.
Лекция 9. Методы оптимизации. Метод Лагранжа
Лекция 10. Метод линейного программирования.
Лекция 11. Функциональные модели.
Лекция 12. Модели процессов содержащие обыкновенные дифференциальные уравнения.
Численные ошибки использованных для вычисления данных
Лекция 13. Статистические модели динамики.
Лекция 16. Информационные технологии в экологии. Экологические информационные системы.
1 6.1. Экологические информационные системы
1. Какова область значения для числовых характеристик?
Лекция 17. Использование информационных технологий для решения задач экологии.
Критические значения коэффициента корреляции rk;α
2.1. Подобие физических явлений и его признаки
2.4. Применение методов подобия в математическом
11.3. Численные методы решения дифференциальных уравнений
11.3.2. Процесс численного решения
11.3.4. Модифицированный метод Эйлера
11.3.6. Метод Рунге – Кутта для систем дифференциальных уравнений
11.3.7. Общая характеристика одношаговых методов
11.3.9. Методы прогноза и коррекции
11.3.10. Краткая характеристика методов прогноза и коррекции.
11.3.11. Выбор шага и погрешность решения.
11.4. Имитационное моделирование систем
11.4.1. Принципы имитационного моделирования
11.4.3. Динамическая модель исследуемого объекта
11.4.4. Построение имитационных моделей динамических систем
11.4.5. Преобразование передаточных функций звеньев в дифференциальные уравнения в форме Коши
11.4.6. Синтез имитационной модели на основе структурной схемы
11.5. Теоретические основы построения математических моделей систем
11.5.1. Компонентные и топологические уравнения
11.5.2. Компонентные и топологические уравнения механической системы
11.5.3. Компонентные и топологические уравнения электрической системы
11.5.4. Компонентные и топологические уравнения гидравлической системы
11.5.5. Компонентные и топологические уравнения тепловой системы
11.6.1. Сущность метода электроаналогий.
11.6.2. Электромеханические аналогии
11.6.3. Построение имитационных моделей методом электроаналогий
11.6.4. Плоское прямолинейное движение звеньев
11.6.5. Электрогидравлические аналогии
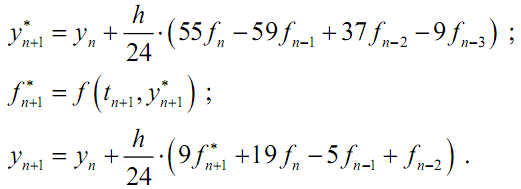
В целом этот метод
является явным. Сначала по формуле
Адамса –
Башфорта вычисляется
значение
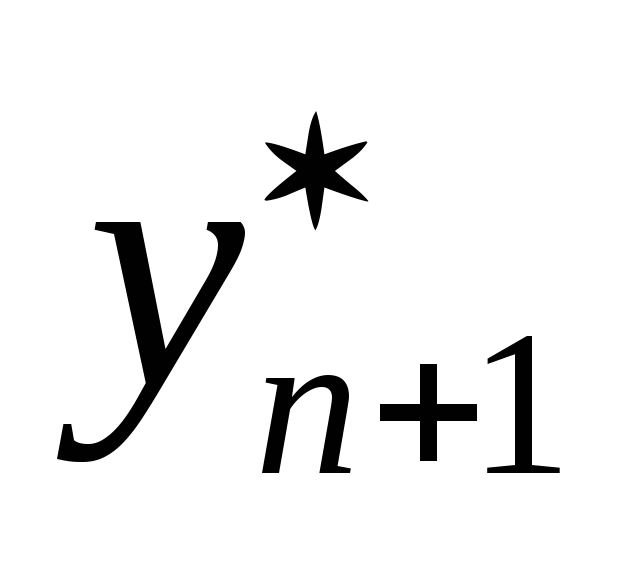 ,
являющееся «прогнозом» для
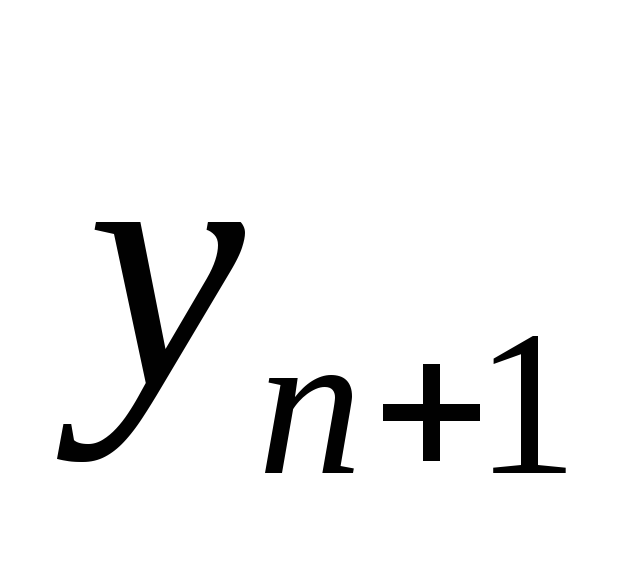 .
Затем
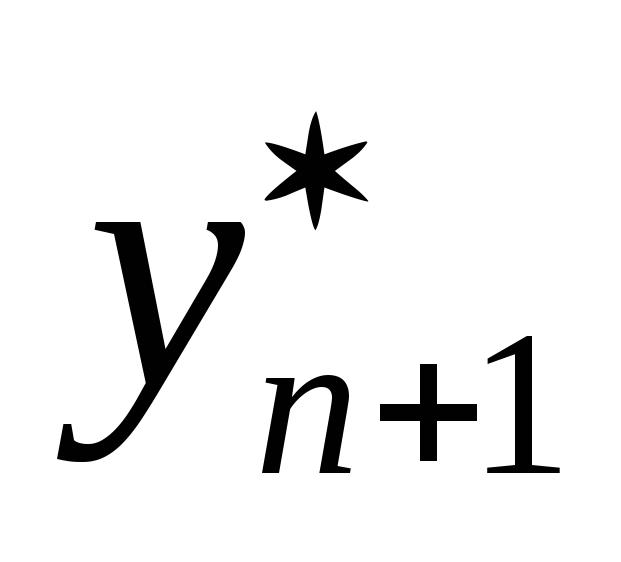 используется для вычисления приближенного
значения
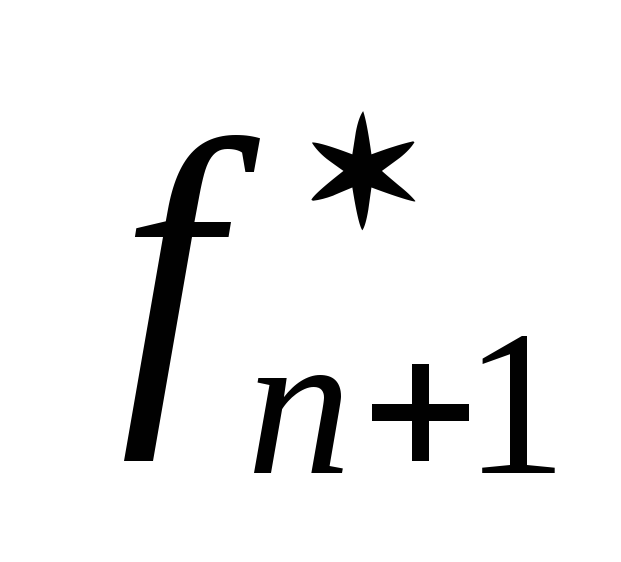 ,
которое, в свою очередь, используется
в формуле Адамса
- Моултона.
Таким образом, формула Адамса
-Моултона «корректирует»
приближение, даваемое формулой Адамса–
Башфорта.
Может возникнуть вопрос - зачем вообще нужна коррекция, если прогноз имеет четвёртый порядок точности? Ответ на этот вопрос дает оценка величины членов, выражающих погрешность. Ошибка усечения ряда для формулы прогноза (3.17) равна:
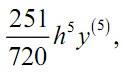
а для формулы коррекции (3.19):
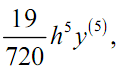
т. е. погрешность усечения ряда при коррекции в 13 раз меньше.
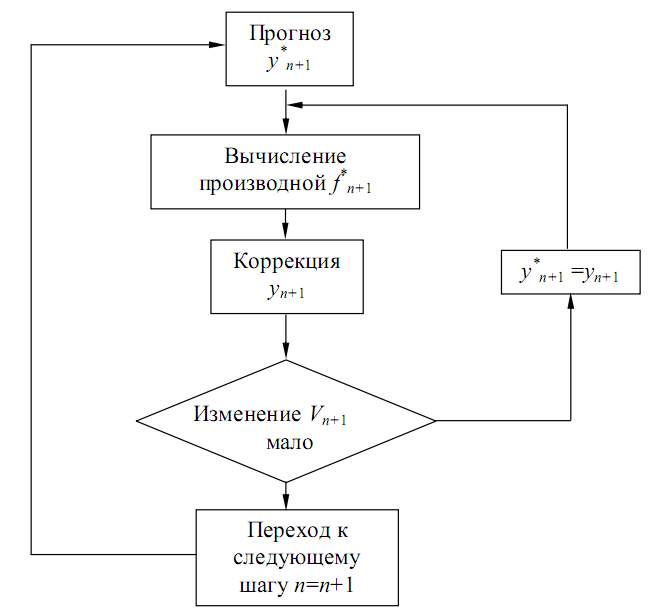
Рис. 3.5. Алгоритм метода прогноза и коррекции
Формулы коррекции гораздо более точны, чем формулы прогноза, а потому их использование оправданно, хотя и связано с дополнительными вычислениями (рис. 3.5). Чтобы добиться наибольшей точности вычисления, коррекцию в методах прогноза и коррекции часто повторяют на одном и том же шаге несколько раз. На практике для обеспечения сходимости решения достаточно 2-3 циклов коррекции.
11.3.10. Краткая характеристика методов прогноза и коррекции.
По сравнению с одношаговыми методами, методы прогноза и коррекции имеют ряд особенностей:
1) Для реализации методов прогноза и коррекции необходимо иметь информацию о нескольких предыдущих точках. Поэтому они не относятся к числу «самостартующихся» методов и начинать решение приходится с помощью какого-либо одношагового метода. По этой же причине в процессе решения дифференциальных уравнений нельзя изменять шаг интегрирования.
2) Одношаговые методы и методы прогноза и коррекции обеспечивают приблизительно одинаковую точность результатов, однако вторые в отличие от первых позволяют легко оценить погрешность на шаге.
3) Применяя метод Рунге - Кутта четвёртого порядка, на каждом шаге приходится вычислять четыре значения функции, в то время как для обеспечения сходимости метода прогноза и коррекции того же порядка точности достаточно двух значений функции. Поэтому методы прогноза и коррекции требуют почти вдвое меньше машинного времени, чем методы Рунге - Кутта сравнимой точности.
11.3.11. Выбор шага и погрешность решения.
Одним из важнейших практических вопросов, которые встают перед инженером, составляющим программы решения дифференциальных уравнений, является выбор подходящей величины шага. Если шаг слишком мал, то расчёт потребует неоправданно много машинного времени, а число ошибок на
отдельных шагах, складывающихся в суммарную ошибку, будет весьма велико. Если же наоборот - шаг выбран слишком большим, то значительной будет погрешность, обусловленная усечением рядов, и накопившаяся суммарная ошибка будет также недопустимо большой (рис.3.6).
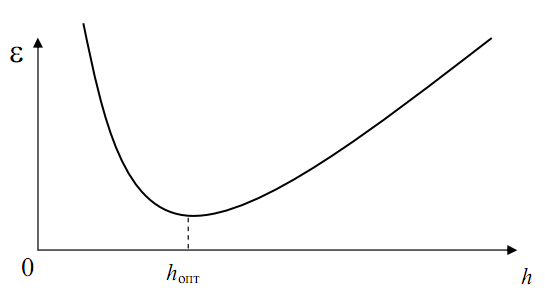
Рис. 3.6. Выбор оптимального шага интегрирования
Кроме того, при больших значениях h возникает опасность появления цифровой неустойчивости решения. Важно различать между собой две меры погрешностей дискретизации [9],[10]:
а) локальная ошибка - это погрешность, вносимая в вычислительный процесс на каждом шаге вычислений.
б) глобальная ошибка - это разность между вычисленным и точным значениями величины на всем этапе реализации численного алгоритма, определяющая суммарную погрешность, накопившуюся с момента начала вычислений. Обычно, выбирая величину шага, стремятся, чтобы локальная ошибка на шаге была меньше некоторой заданной допустимой величины. Вообще говоря, если порядок точности метода Р, то локальная ошибка определяется выражением:
L(h) = c hp+1,
где c - некоторая постоянная; h - шаг интегрирования.
Указанное выражение с помощью θ-символики может быть записано более компактно:
L(h) = θ (hp+1).
Например, рассмотрим метод Эйлера:
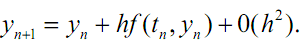
Отсюда заключаем, что для метода Эйлера p =1, т.е. метод имеет первый порядок точности, а локальная ошибка определяется формулой:
L(h) = θ (h2 ).
Рассмотрим теперь глобальную ошибку дискретизации в конечной точке t=tN. По мере повышения требований к точности, длина шага h будет убывать, а общее из числа N, необходимое для достижения tN, будет возрастать:
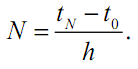
Далее, глобальная ошибка E(h) может быть представлена как сумма N локальных ошибок и поэтому мы можем, округляя, записать:
E(h) = N θ(hp+1) = θ(hp ).
Для метода Эйлера p =1, так что уменьшение длины шага в 2 раза уменьшает среднюю локальную ошибку примерно в 2p+1 = 4 раза. Но так как для достижения tN теперь потребуется вдвое больше шагов, то глобальная ошибка ум-еньшится лишь в 2p = 2 раза. Если используется один из методов прогноза и коррекции, то ошибка на шаге определяется величиной последнего члена в формуле коррекции. При использовании же одношаговых методов Рунге-Ку-тта, локальную ошибку не удается выразить в явной форме. Один из методов оценки этой ошибки основан на двойном счете. Если для вычисления значения искомой функции yn+1 в точке tn+1 используется шаг h, то разность между истинным и вычисленным значениями на данном шаге равна:
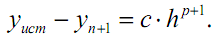
Если уменьшим шаг
вдвое и выполнив два шага вычислим
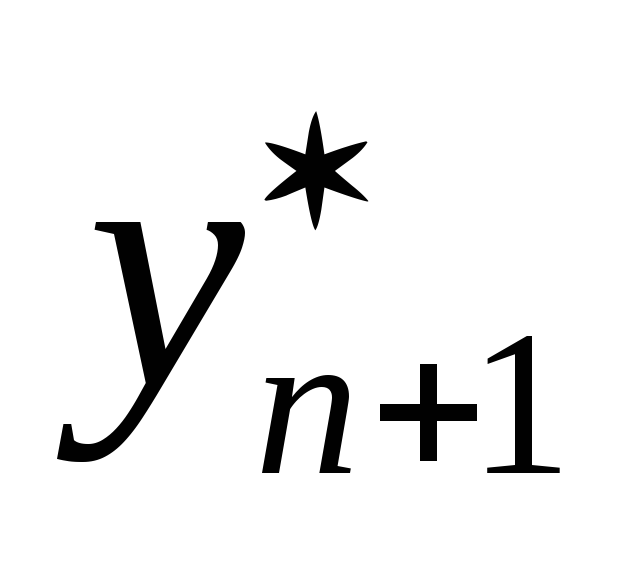 в точке tn+1,
то получим:
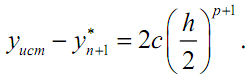 (3.21)
Вычитая это выражение из предыдущего, найдем:
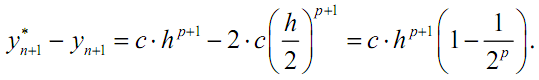
Отсюда можно найти локальную погрешность:
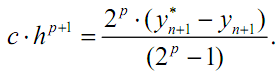 (3.22)
Данная формула называется правилом Рунге. Если ошибка на данном шаге слишком велика, то шаг делят пополам и вычисления повторяют вновь.
Запишем формулу (3.22) в виде:
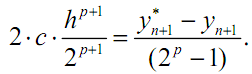
Подставляя полученное выражение в (3.21) и полагая p=4, найдём приближенное значение ошибки на одном шаге:
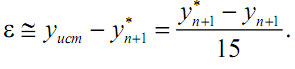 (3.23)
Из (3.23) вытекает уточнённое решение:
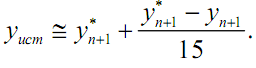
Недостатком этого метода является то, что значение yn+1 приходится вычислять дважды, причем второй раз с помощью двух шагов. Тем не менее, эта процедура часто включается в вычислительный алгоритм для автоматического изменения шага в процессе вычислений и часто используется в методах Рунге - Кутта. Главное достоинство методов Рунге - Кутта - простота начала счета и возможность изменения величины шага в процессе вычисления. С
другой стороны, главным достоинством методов прогноза и коррекции является простота оценки ошибки на шаге.