Материал: Математическое моделирование в экологии
СОДЕРЖАНИЕ
Математическое моделирование элементов сложных экологических систем
Лекция 1. Введение в моделирование. Исторический экскурс.
1. Основы моделирования в экологии 1.1. Общие принципы построения моделей в экологии
2.2. Этапы построения математической модели
1.4. Элементы теории подобия, применяемые в моделировании
3.2.2. Выборочный метод в экологометрике.
Зависимость числа интервалов от объема выборки
Статистический ряд по интервалам
Лекция 4. Статистические оценки параметров распределения случайных величин по выборкам
4.4. Статистические оценки гипотез об экологических моделях
Выборка из генеральной совокупности
Статистическая таблица эксперимента
Пример преобразования членов уравнения регрессии
Вычисление данных для линеаризации уравнения регрессии
Нормальные уравнения мнк для некоторых функций
Статистическое оценивание уравнения регрессии и парной корреляции.
Обработка результатов наблюдений
Рекомендации по выбору вида функции
3.4. Динамические статистические модели
Данные по объему сброса качественных сточных вод
Данные по объему сброса сточных вод за 5-летие
Пример расчета 5-летних средних
Расчетные значения для определения уравнения динамики
Ряд динамики для определения сезонных колебаний
Эксперименталъный материал исследования
8.1. Анализ влияния отдельных факторов в экологической модели.
Лекция 9. Методы оптимизации. Метод Лагранжа
Лекция 10. Метод линейного программирования.
Лекция 11. Функциональные модели.
Лекция 12. Модели процессов содержащие обыкновенные дифференциальные уравнения.
Численные ошибки использованных для вычисления данных
Лекция 13. Статистические модели динамики.
Лекция 16. Информационные технологии в экологии. Экологические информационные системы.
1 6.1. Экологические информационные системы
1. Какова область значения для числовых характеристик?
Лекция 17. Использование информационных технологий для решения задач экологии.
Критические значения коэффициента корреляции rk;α
2.1. Подобие физических явлений и его признаки
2.4. Применение методов подобия в математическом
11.3. Численные методы решения дифференциальных уравнений
11.3.2. Процесс численного решения
11.3.4. Модифицированный метод Эйлера
11.3.6. Метод Рунге – Кутта для систем дифференциальных уравнений
11.3.7. Общая характеристика одношаговых методов
11.3.9. Методы прогноза и коррекции
11.3.10. Краткая характеристика методов прогноза и коррекции.
11.3.11. Выбор шага и погрешность решения.
11.4. Имитационное моделирование систем
11.4.1. Принципы имитационного моделирования
11.4.3. Динамическая модель исследуемого объекта
11.4.4. Построение имитационных моделей динамических систем
11.4.5. Преобразование передаточных функций звеньев в дифференциальные уравнения в форме Коши
11.4.6. Синтез имитационной модели на основе структурной схемы
11.5. Теоретические основы построения математических моделей систем
11.5.1. Компонентные и топологические уравнения
11.5.2. Компонентные и топологические уравнения механической системы
11.5.3. Компонентные и топологические уравнения электрической системы
11.5.4. Компонентные и топологические уравнения гидравлической системы
11.5.5. Компонентные и топологические уравнения тепловой системы
11.6.1. Сущность метода электроаналогий.
11.6.2. Электромеханические аналогии
11.6.3. Построение имитационных моделей методом электроаналогий
11.6.4. Плоское прямолинейное движение звеньев
11.6.5. Электрогидравлические аналогии
Различают следующие виды отбора объектов из генеральной совокупности в выборку:
1) типический, или групповой, когда генеральная совокупность предварительно делится на типические группы (например, участки, делянки, районы);
2) серийный, или гнездовой, когда генеральная совокупность делится на серии, или гнезда;
3) механический, когда генеральную совокупность предварительно разбивают на несколько частей (или групп) и затем из каждой части отбирают в выборку по несколько объектов, представителей этих частей. Если учесть, что изучение выборки преследует цель исследования свойств и характеристик генеральной совокупности, то выборка должна быть представительной (репрезентативной). Это означает, что ее объем должен быть не менее некоторого специального определенного объема, что будет рассмотрено далее.
Исследования или измерения каких-либо свойств или характеристик отдельных объектов выборки представляются в виде статистического ряда, они могут быть дистрибутивные, вариационные, динамики, или временные.
Дистрибутивные ряды служат для разделения объектов выборки по каким-либо признакам, заранее известным, например, людей по группам крови.
Вариационные ряды показывают закономерность распределения единиц изучаемой выборки по ранжированным значениям варьирующего признака, например, пробы воздуха по содержанию пылевых частиц.
Ряды динамики (временные) показывают закономерность изменения варьирующего признака в зависимости от времени.
При статистической обработке не следует упускать из внимания экологический смысл изучаемого объекта, который всегда устанавливает границы исследования. Таким образом, выборка — группа объектов, отличающихся некоторыми особенностями:
• это часть генеральной совокупности;
• объекты в выборку отбираются в случайном порядке определенным способом;
• объекты выборки исследуются для определения характеристик самой выборки и для оценки характеристик генеральной совокупности.
Основное правило — соблюдение равной вероятности попадания в выборку любого объекта генеральной совокупности, т.е. вы- бор должен быть совершенно случаен.
Построение статистического ряда. Пусть имеется некоторое множество N объектов, которое рассматриваем как генеральную совокупность, характеристику (признак) Х которой нам необходимо изучить. Так как N слишком велико, то для определения характеристики берем из N некоторое подмножество объектов n, которое назовем выборкой.
Если выбор каждого из n объектов производится независимо один от другого по всему множеству N случайным образом, то та- кую выборку можно назвать случайной или статистической. Ре- зультатом выборки n является совокупность х1, х2, ..., хn зафиксиро- ванных значений характеристики (признака) Х.
Характеристика Х является случайной величиной. Если опыты (наблюдения) производились в одинаковых условиях и независимо друг от друга, то-выборку (х1, х2, ..., хn) можно рассматривать как - n-мерный случайный вектор, где величины хi независимы, и каждая из них распределена так же, как и случайная величина Х в генеральной совокупности. В этом случае можно сказать, что выборка (х1, х2, ..., хn) взята из генеральной совокупности случайной величины Х с теорети- ческой функцией распределения F(x).
Результаты опыта, записанные в порядке возрастания х, называют вариационным рядом (расположение х в порядке возрастания называют ранжированием ряда), величину х, называют вариантой. Например, при исследовании пораженности лесного массива выявлено на одном гектаре пораженных деревьев:
4; 12; 11; 13; 15; 7; 15; 6; 4; 9; 10; 15.
Результаты опыта представлены в виде вариационного ряда:
4; 4; 6; 7; 9; 10; 11; 12; 13; 15; 15; 15.
В случае, когда в n опытах величина х,. встречается mi раз, то число m называют частотой величины хi (в нашем примере для хi = 15, mi = 3), а отношение частоты к общему числу опытов n называют относительной частотой (или частостью, вероятностью)
Wi = mi/n
Для данного примера для Wi = 3/12 = 1/4, при хi = 15. Очевидно, что сумма частот равна:
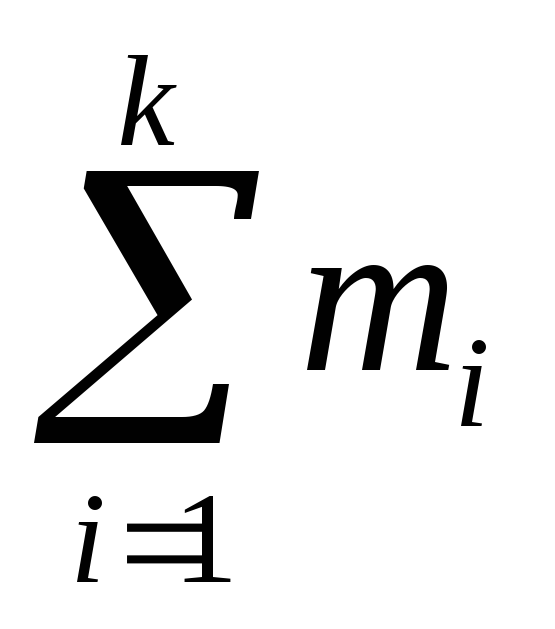
 =
n,
а
частостей
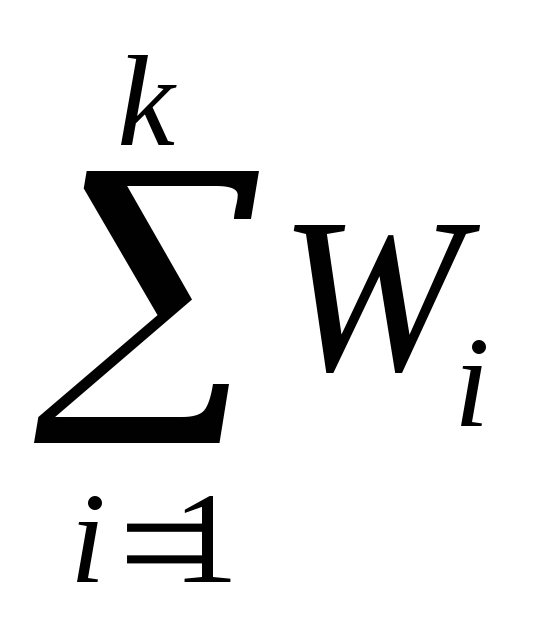 =1,0
где k — число различных групп значений величин х.
Результаты наблюдений можно записать в виде последовательности пар чисел (хi, mi). Такую запись называют статическим рядом (табл. 3.1).
|
хi |
0,6 |
0,8 |
1,0 |
1,2 |
1,4 |
1,6 |
1,8 |
|
mi |
4 |
6 |
10 |
8 |
7 |
5 |
3 |
|
|
|
|
|
|
|
|
|
Статический ряд последовательности пар чисел
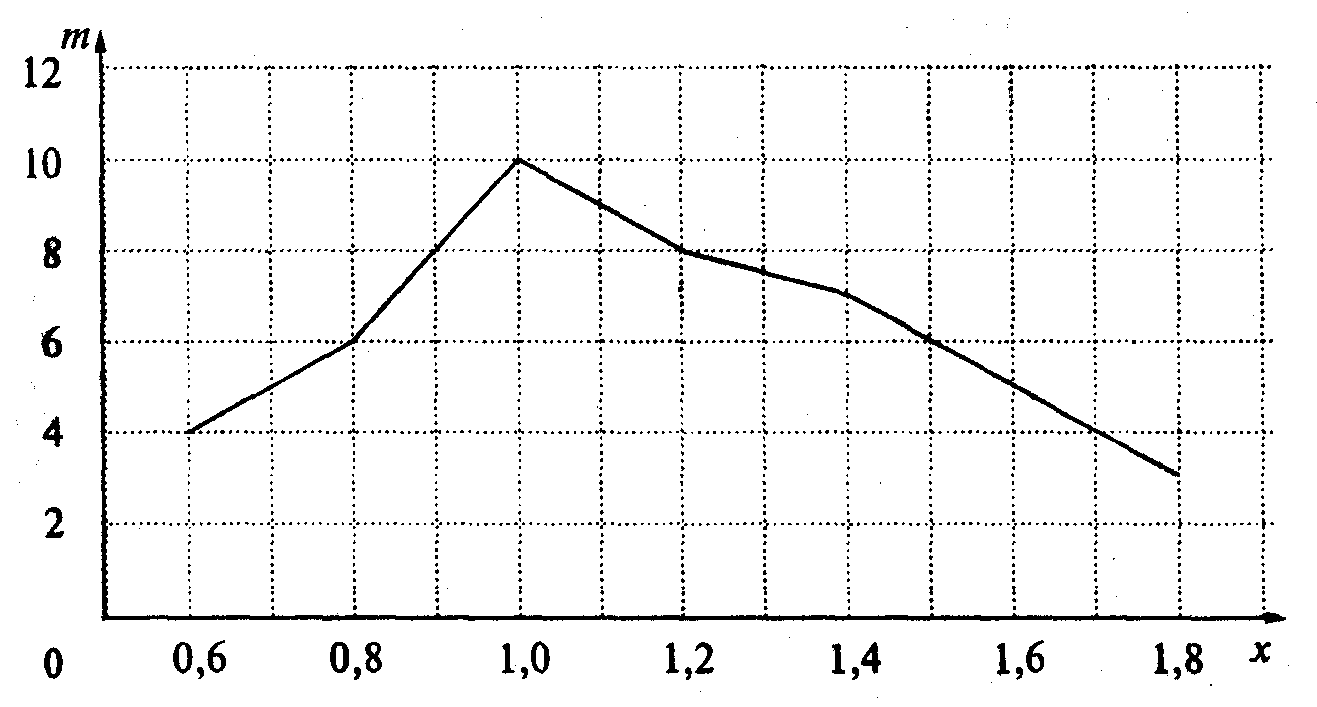 Можно
построить
в
системе
координат
(х,
m)
график
с
точками
(х1,
m1),
(х2,
m2),
..., (хk,
mk)
и соединить
полученные
точки
ломаной
линией,
которую
называют
полигоном
частот
выборки или
полиго-
ном
Рис. 3.1. Полигон распределения х.
распределения (см. рис 3.1).
Полигон строится для таких величин, которые принимают дискретные значения х. Для непрерывных величин строится гистограмма распределения (рис. 2.2), построение которой рассмотрим на примере.
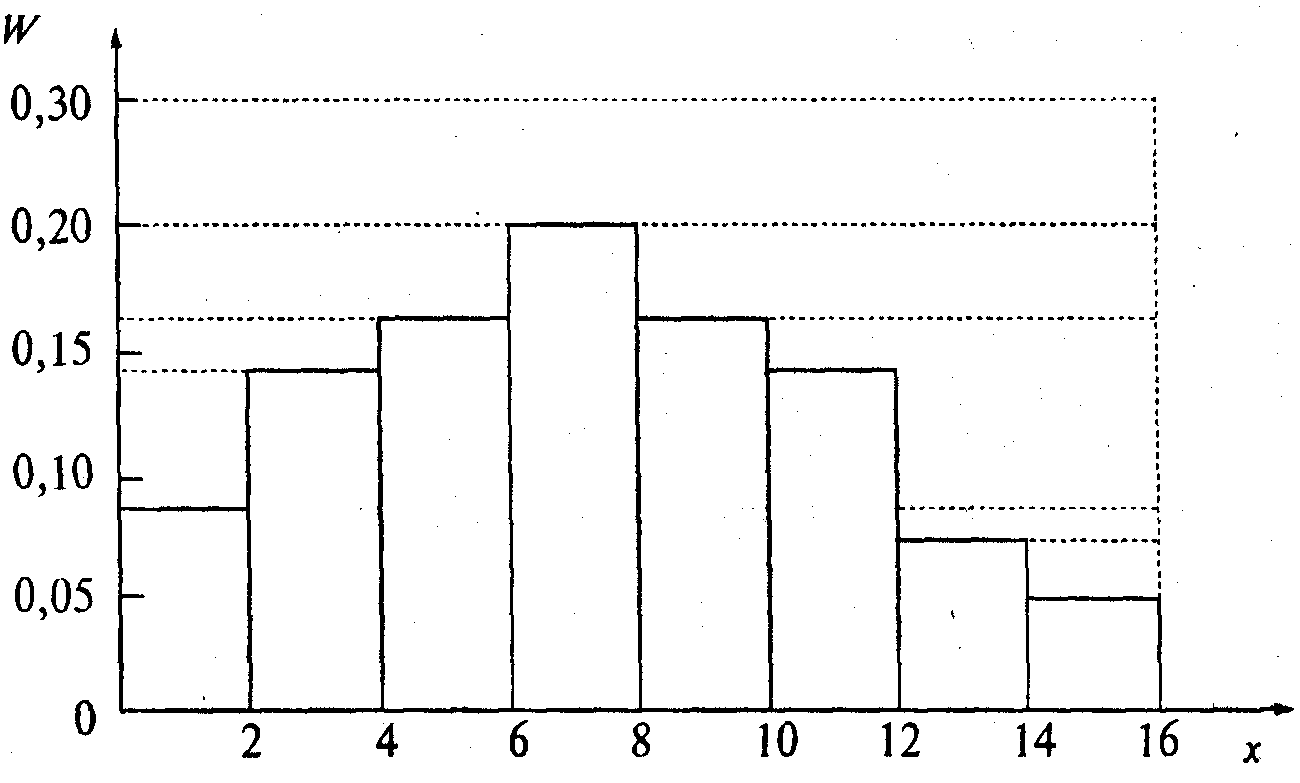
Рис.3.2. Гистограмма распределения нитратов в огурцах
Пример. Вариационный ряд, записанный по результатам 64 опытов по определению содержания нитратов (мг/кг) в огурцах, поставляемых в магазин из совхоза, имеет вид:
0,1;0,2;0,2;1,0;1,0;1,5;2,1;2,1;2,2;2,3;2,5;3,5;3,8;3,9;4,2; 4,2; 4,4; 4,5;
5; 5,0; 5,5; 5,6; 5,8; 6,0; 6,2; 6,3; 6,5, 6,8; 6,8; 6,8; 7,0; 7,5; 7,8; 7,8; 7,8; 7,8; 8;
8; 8,6; 8,8; 9,0; 9,5; 9,5; 9,5; 9,5; 9,5; 10,0; 10,0; 10,0; 11,3; 11,8; 11,8;
11,8; 11,9; 12,0; 12,0; 12,8; 13,2; 13,8; 13,8; 14,0; 14,5; 15,0; 15,9.
Здесь наименьшее значение Хmin = 0,1; наибольшее — Хmax = 15,9. Разницу между наибольшим и наименьшим значением х называют размахом (R), который равен
R = Хmax - Хmin = 15,9 — 0,1 = 15,8.
Выбираем число интервалов для группировки данных. Число интервалов можно ориентировочно выбирать по табл. 2.2 в зависимости от объема выборки n.
Таблица 3.2
Зависимость числа интервалов от объема выборки
|
n |
До 50 |
50 — 100 |
100 — 500 |
500 — 1000 |
Свыше 1000 |
|
k |
6 — 8 |
8-10 |
10-13 |
13-15 |
15-20 |
При этом желательно, чтобы в каждом интервале было не менее восьми наблюдений (в крайних интервалах число наблюдений может быть меньше восьми).
Для нашего примера принимаем k = 8. Определяем ширину интервала (h) по формуле
h =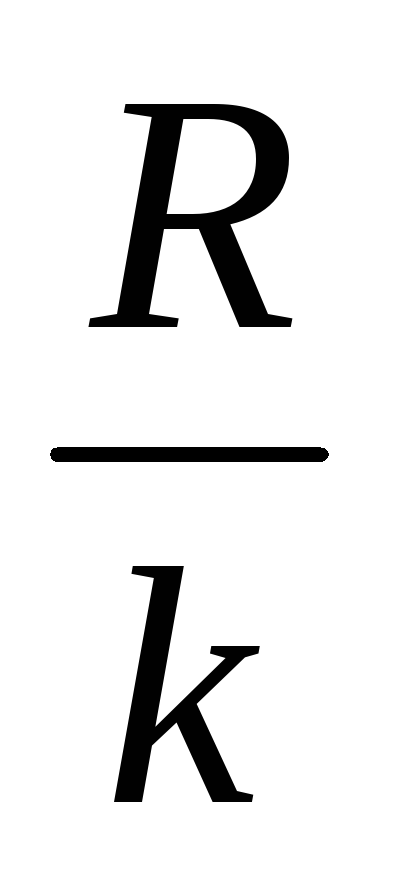 =
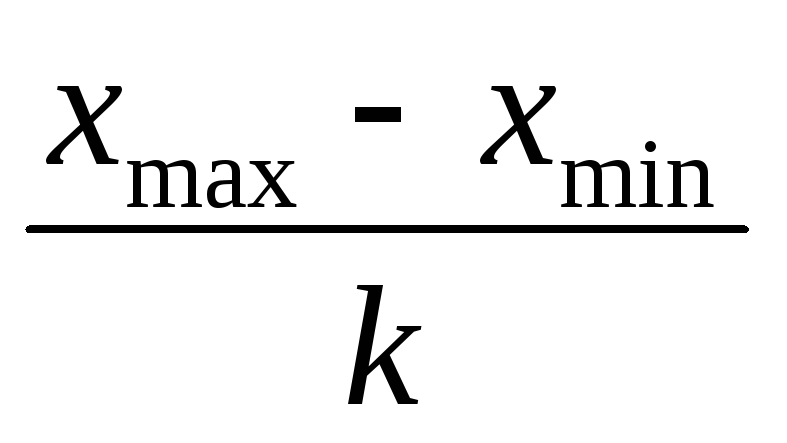 =
15,8/8=
1,975
Принимаем h = 2,0, условно считаем Хmax = 16,0. Записываем статистический ряд по интервалам (табл. 3.3). Эмпирической функцией распределения Fn(х) называют функцию накопленных (кумулятивных) частостей, для нашего примера она имеет вид Рис. 3.3.
Функция Fn(х) может быть изображена графически (см. рис. 3.3) в координатах (х, Fn(х)). Функция Fn(х) служит оценкой неизвестной функции распре- деления F(x) для случайной величины х.
Таблица 3.3
Статистический ряд по интервалам
-
Номер интер- вала i
Интервал значений для хi.
Среднее значение х в ин- тервале, хi*.
Частота наблюде- ний в интервале, mi.
Частость,
wi
Накоп- ленная частость, wn,i
1
0 ≤ х1 ≤ 2
1
6
0,09375
0,09375
2
2 ≤ х2 ≤ 4
3
8
0,12500
0,21875
3
4 ≤ x3 ≤ 6
5
10
0,15625
0,37500
4
6 ≤ х4 ≤ 8
7
12
0,18750
0,56250
5
8 ≤ x5 ≤ 10
9
10
0,15625
0,71875
6
10 ≤ х6 ≤12
11
8
0,12500
0,84375
7
12 ≤ х7 ≤ 14
13
6
0,09375
0,93750
8
14 ≤ х8 ≤ 16
15
4
0,06250
1,00000
Сумма
64
1,00000
1,00000