Материал: Математическое моделирование в экологии
СОДЕРЖАНИЕ
Математическое моделирование элементов сложных экологических систем
Лекция 1. Введение в моделирование. Исторический экскурс.
1. Основы моделирования в экологии 1.1. Общие принципы построения моделей в экологии
2.2. Этапы построения математической модели
1.4. Элементы теории подобия, применяемые в моделировании
3.2.2. Выборочный метод в экологометрике.
Зависимость числа интервалов от объема выборки
Статистический ряд по интервалам
Лекция 4. Статистические оценки параметров распределения случайных величин по выборкам
4.4. Статистические оценки гипотез об экологических моделях
Выборка из генеральной совокупности
Статистическая таблица эксперимента
Пример преобразования членов уравнения регрессии
Вычисление данных для линеаризации уравнения регрессии
Нормальные уравнения мнк для некоторых функций
Статистическое оценивание уравнения регрессии и парной корреляции.
Обработка результатов наблюдений
Рекомендации по выбору вида функции
3.4. Динамические статистические модели
Данные по объему сброса качественных сточных вод
Данные по объему сброса сточных вод за 5-летие
Пример расчета 5-летних средних
Расчетные значения для определения уравнения динамики
Ряд динамики для определения сезонных колебаний
Эксперименталъный материал исследования
8.1. Анализ влияния отдельных факторов в экологической модели.
Лекция 9. Методы оптимизации. Метод Лагранжа
Лекция 10. Метод линейного программирования.
Лекция 11. Функциональные модели.
Лекция 12. Модели процессов содержащие обыкновенные дифференциальные уравнения.
Численные ошибки использованных для вычисления данных
Лекция 13. Статистические модели динамики.
Лекция 16. Информационные технологии в экологии. Экологические информационные системы.
1 6.1. Экологические информационные системы
1. Какова область значения для числовых характеристик?
Лекция 17. Использование информационных технологий для решения задач экологии.
Критические значения коэффициента корреляции rk;α
2.1. Подобие физических явлений и его признаки
2.4. Применение методов подобия в математическом
11.3. Численные методы решения дифференциальных уравнений
11.3.2. Процесс численного решения
11.3.4. Модифицированный метод Эйлера
11.3.6. Метод Рунге – Кутта для систем дифференциальных уравнений
11.3.7. Общая характеристика одношаговых методов
11.3.9. Методы прогноза и коррекции
11.3.10. Краткая характеристика методов прогноза и коррекции.
11.3.11. Выбор шага и погрешность решения.
11.4. Имитационное моделирование систем
11.4.1. Принципы имитационного моделирования
11.4.3. Динамическая модель исследуемого объекта
11.4.4. Построение имитационных моделей динамических систем
11.4.5. Преобразование передаточных функций звеньев в дифференциальные уравнения в форме Коши
11.4.6. Синтез имитационной модели на основе структурной схемы
11.5. Теоретические основы построения математических моделей систем
11.5.1. Компонентные и топологические уравнения
11.5.2. Компонентные и топологические уравнения механической системы
11.5.3. Компонентные и топологические уравнения электрической системы
11.5.4. Компонентные и топологические уравнения гидравлической системы
11.5.5. Компонентные и топологические уравнения тепловой системы
11.6.1. Сущность метода электроаналогий.
11.6.2. Электромеханические аналогии
11.6.3. Построение имитационных моделей методом электроаналогий
11.6.4. Плоское прямолинейное движение звеньев
11.6.5. Электрогидравлические аналогии
Можно получить выборочную функцию распределения плотности вероятностей fn(х) в сере- дине интервалов хi* (см. ниже рис. 2.3)
fn(хi*)= mi /nh,
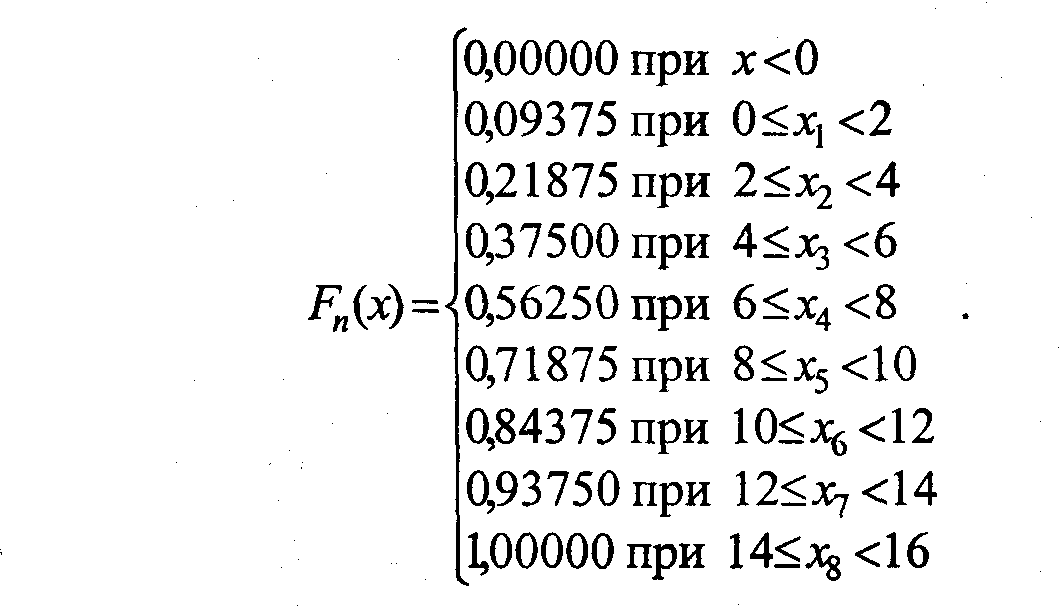
Рис. 3.3. Эмпирическая функция распределения нитратов в огурцах.
Например, для первого интервала
fn(xi*)
=
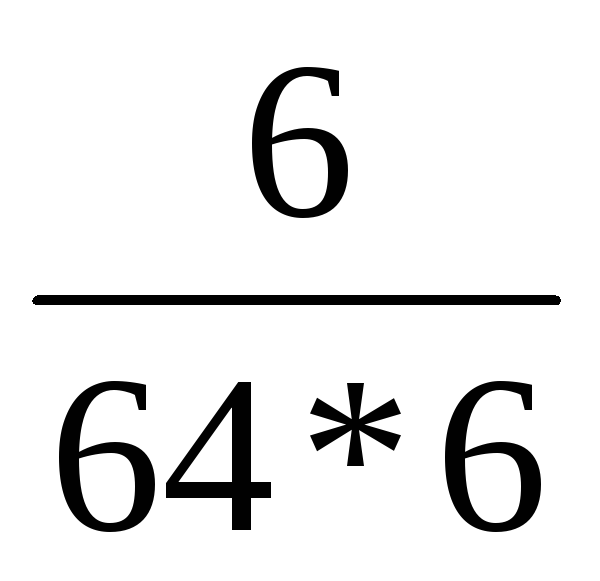 = 0,046875
Тогда f'n(х) для нашего примера будет иметь следующий вид:
⌠ 0,00000 при х < 0
│ 0,04687 при 0 < x1 < 2
│ 0,06250 при 2 < х2 < 4
│ 0,07823 при 4 < х3 < 6 130
fn(x) = { 0,09375 при 6 < х4 < 8
│ 0,07812 при 8 < х5 <10
│ 0,06250 при 10 < х6 < 12
│ 0,04687 при 12 < х7 <14
⌡ 0,03125 при 14 < х8 <16
Если генеральная совокупность N обладает двумерным признаком Х и Y, где Х и Y представляют собой случайные зависимые величины, то статистический ряд может иметь вид, приведенный:
в табл. 2.4 (когда обе величины Х и Y непрерывны); табл. 2.5 (Х непрерывна, а Y дискретна); табл. 2.6 (обе Х и Y дискретны).
В табл. (2.4 - 2.6) частота наблюдений mij показывает, сколько встречается в опыте пар (хi,уj).
Таблица 3.4
Статистический ряд при непрерывных величинах Х и Y
-
Х
Y
Границы интервала
0,1<у1<2
0,2<у2<0,3
0,3<у3<0,4
0,4<у4<0,5
Грани- цы
интер- вала
0 ≤ х1< 1,1
m11= 5
m12 = 4
m13= 3
m14= 1
1,1≤х2< 2,2
m21= 1
m22= 7
m23= 6
m24= 4
2,2 ≤x3<3,3
m31 = 0
m32 = 8
m33= 5
m34 = 2
2,2 ≤x3<3,3
m41= 2
m42= 4
m43= 1
m44= 3
Таблица 3.5
Статистический ряд, когда Х непрерывна, а Y дискретна
|
Y X |
Значение у,. |
||||
|
y1= 2 |
y2 = 4 |
y3 = 6 |
y4 = 8 |
||
|
Грани- цы интер- вала |
0,5≤ х2<1,5 |
m11= 4 |
m12=6 |
m13=4 |
m14= 2 |
|
1,5≤ х2<2,5 |
m21= 3 |
m22=5 |
m23=6 |
m24=5 |
|
|
2,5≤ х2<3,5 |
m31= 1 |
m32= 5 |
m33=4 |
m34=7 |
|
Таблица 3.6
Статистический ряд, когда Х и Y дискретны
|
У Х |
Значение у,. |
|||||
|
1 |
2 |
3 |
4 |
5 |
||
|
|
.10 |
m»= 5 |
т,,=4 |
m»= 8 |
т — 7 |
т =2 1з |
|
Значе- |
15 |
т,,=2 |
изб |
и,,=4 |
т4= 3 |
и,,= 2 |
|
ние х,. |
20 |
т =1 зз |
т,,=6 |
m»= 5 |
и =1 з~ |
тзз 2 |
|
|
25 |
m4) 3 |
т =3 42 |
т,,=4 |
т =5 44 |
т,,=6 |
Если генеральная совокупность N обладает р-мерным признаком
(L = l, 2,...,1,..., р), где x1, x2, x3, …, xn, …, хp — случайные величины, то статистический ряд будет состоять при выборке n из n векторов
(x11, x21, x31, …, xn1)
(x12, x22, x32, …, xn2)
…………………….
(x1n, x2n, x3n, …, xnm)
где хij — случайная величина хj в i-ом испытании (наблюдении).
Результаты наблюдений могут быть также представлены в виде матрицы
X =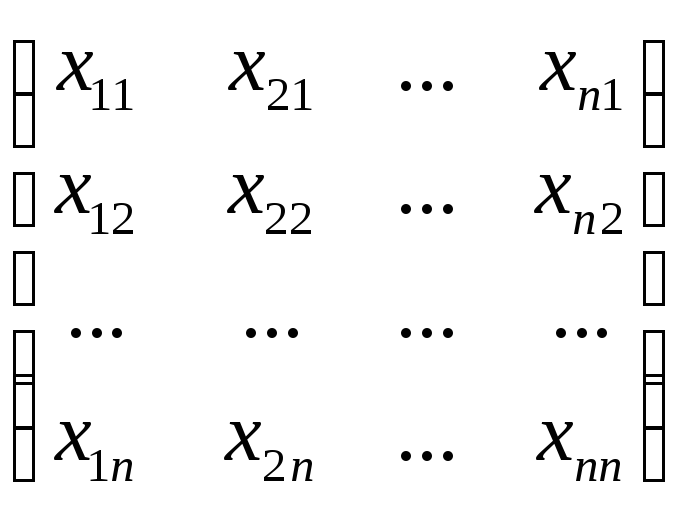
назад
Лекция 4. Статистические оценки параметров распределения случайных величин по выборкам
Основная
задача
выборочного
метода
заключается
в
том,
что-
бы
на
основе изучения
выборочной
совокупности
получить
та-
кие
выборочные
характеристики, которые
как
можно
более
точно
отражали
бы
характеристики генеральной
совокупности.
Пусть
изучается
некоторый
признак Θ.
По
результатам
выборки
определяется
оценка
этого
признака Θb.
Как
бы
тщательно
ни
была
организована
выборка,
будем
иметь некоторую
ошибку
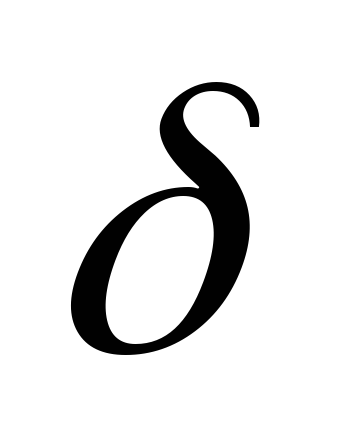 =
|
Θb
—
Θ|,
которая
будет
отличаться
от
нуля. С
этой
точки
зрения
основная
задача
выборочного
метода
будет
заключаться в
том,
чтобы
величина
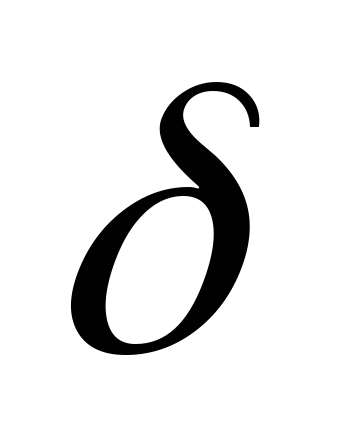 была
как
можно
меньше.
Чтобы выборочную оценку можно было считать, доброкачественной и пригодной для решения поставленных задач, она должна обладать определенными свойствами. Наилучшие оценки обладают такими свойствами, как несмещенность, состоятельность, эффективность и достаточность.
Выборочная оценка называется несмещенной, если ее математическое ожидание при любом объеме выборки равно значению пара- метра в генеральной совокупности, т.е.
М(Θb) — Θ = 0.
Если же имеется смещение, т.е.
М(Θb) — Θ = β,
то величина β отражает это смещение.
Пусть исследуется признак Х в генеральной совокупности, из которой сделана выборка х1, х2, ..., хn. Средняя арифметическая выборочная
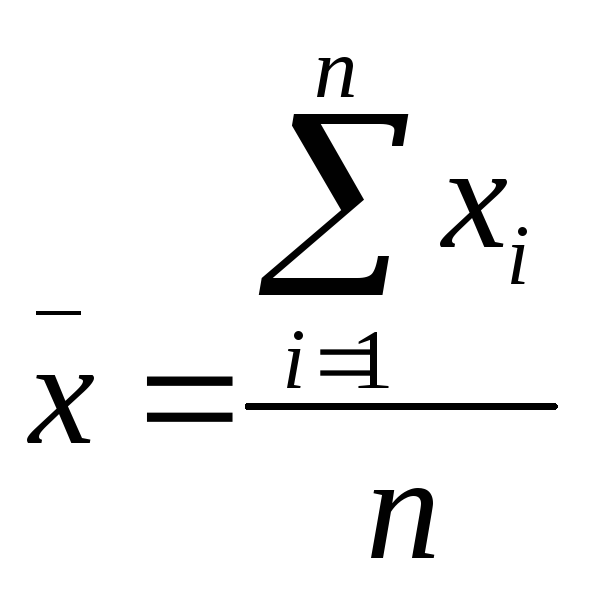
является оценкой генеральной средней M(x), так как
M(x)=M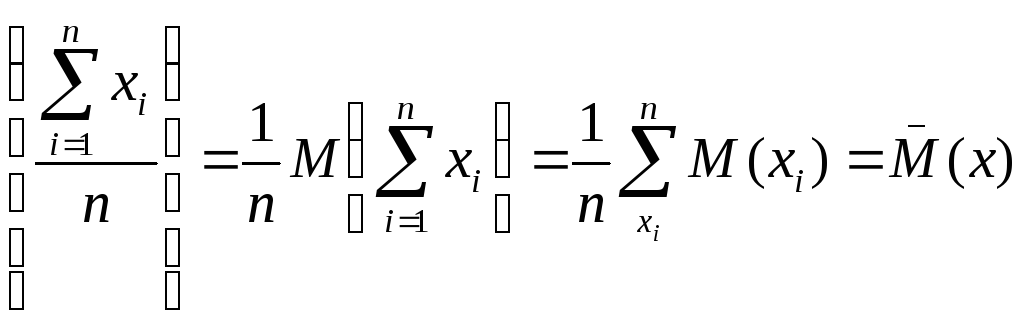
Математическое
ожидание
выборочной
средней
равно
средней
генеральной
совокупности:
M(x)
=
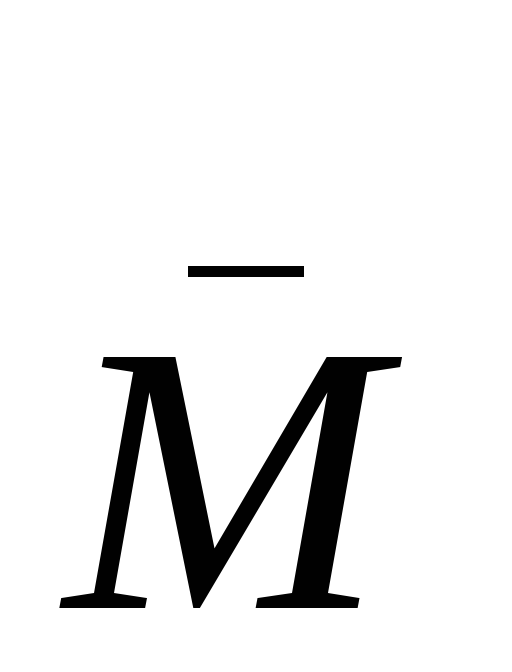 (x).
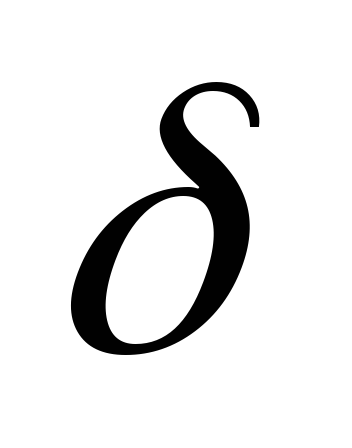
Выборочная оценка Θb параметра Θ, полученная на основе n независимых наблюдений, называется состоятельной, если предел вероятности
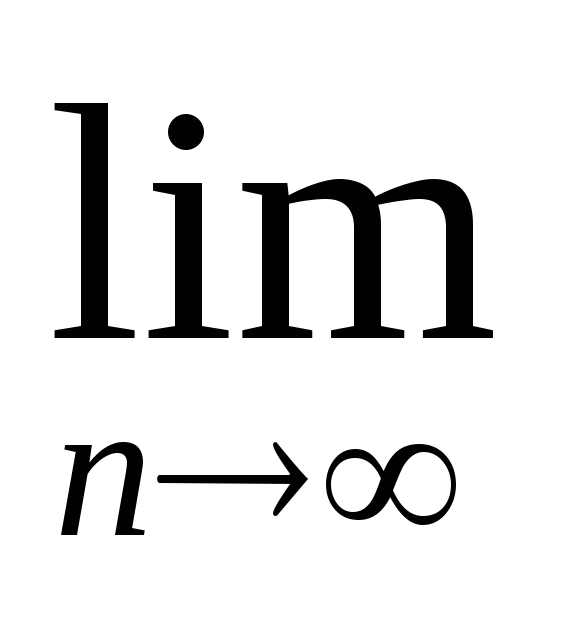 P(Θb
- Θ
<
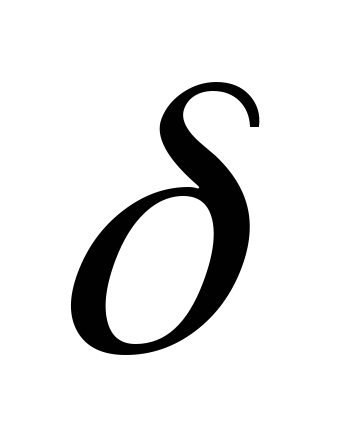 )
=1.
Таким
образом,
разность
|Θb
– Θ|
будет
сколь
угодно
малой,
а
предел
стремится
к
единице
при
увеличении объема
выборки
при
 >0.
Свойство
очевидно,
так
как
чем
ближе
n
к
∞, тем
ближе
оценка
Θb
к
Θ.
Отсюда следует,
что
состоятельность
оценки
возрастает
с
увеличением
объема
выборки.
Выборочная
несмещенная
оценка
называется
эффективной,
если
она
имеет
минимальную
дисперсию
по
сравнению с
другими
возможными
оценками.
Так,
например,
имеются
две
выборочные
оценки
Θb1
и Θb2
с дисперсиями D(Θb1)
>
D(Θb2),
тогда
эффективной
будет
оценка
Θb2.
Достаточной
называют
выборочную
оценку,
если она
включает
всю
информацию,
которая
содержится
в
выборке
относительно
определенного
параметра. Если,
например,
по
выборке
(х1,
х2,
...,
хn)
производится
оценка
неизвестной
вероятности
Р,
то
вполне достаточно
знать
сумму
варианта
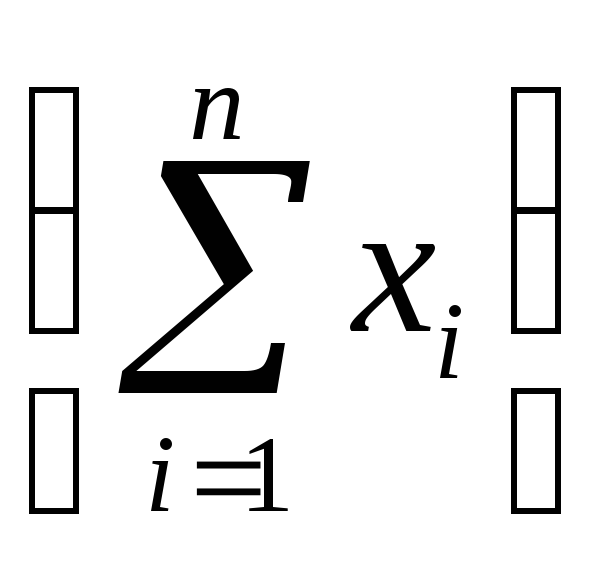 ,
т.е.
общее
число
случаев,
благоприятствующих
данному
событию.
Отдельные
же
значения
хi
уже
не
содержат
никакой
новой
информации и
ничего
не
поясняют
относительно
значений
Р.
Выборочные
оценки
могут
быть
точечными
и
интервальными.
Точечные оценки — это оценки некоторых неизвестных числовых параметров распределения случайных величин. Они представляют собой числа, полученные путем подстановки выборочных значений
х1, х2, ..., хn, в формулу для оценивания искомого параметра. Точечные оценки параметров Θ b не дают информации о степени близости к соответствующему теоретическому параметру генеральной совокупности Θ. Поэтому более информативный способ оценивания неизвестных параметров состоит в построении интервала, в котором оказывается оцениваемый параметр.
Интервальной оценкой параметра Θ называется интервал, гра- ницы которого Θ b1 и Θ b2 являются функциями выборочных значе- ний х1,х2,...,хn, и который с заданной вероятностью накрывает оцениваемый параметр Θ
Р{
Θ b1
<
Θ
<
Θ
b2}
=
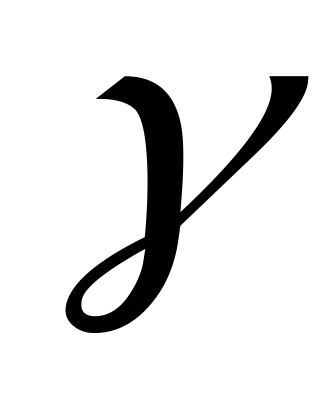 .
Величина
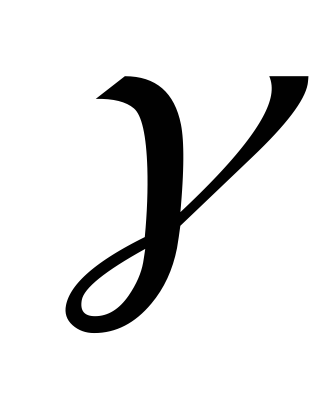 называется
доверительной
вероятностью
или
надежностью,
с
которой
оценка
Θ
заключается
в
интервал
(Θ
b1 и
Θ
b2),
она
записывается
в
виде
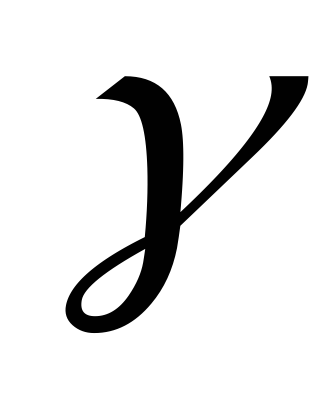 = 1
- α,
где
α
—
уровень
значимости,
определяющий
величину
вероятности
того,
что
оценка
Θ
выйдет
за
пределы
интервала
Θ
b1 и
Θ
b2.